Цифровой дворник

selfhosting

Обложка

У меня в лабе живёт мини-ПК на AMD Phoenix: внутри встроенная графика Radeon 760M (ядро gfx1103), 16 ГБ общей памяти, и ни одной дискретной карты. На первый взгляд — что там гонять, это же iGPU от ноутбучного кристалла. Но у него есть то, чего нет у процессора: настоящий GPU-пайплайн и прямой доступ к общему куску быстрой памяти. А у меня давно чесалось запустить локальную LLM — без аренды видеокарты в облаке и без отправки своих вопросов на чужие серверы.

Спойлер: завелось и работает. Но не так, как обещают красивые посты «локальный DeepSeek за пять минут на любом железе». Давайте по порядку — боль, решение, честные цифры и грабли.

Зачем вообще локально

Сначала про мотивацию, потому что без неё весь этот геморрой выглядит бессмысленным. Локальная модель — это три вещи. Первое: приватность, вопросы не уезжают в чужое облако. Второе: нет счётчика за токены, гоняешь сколько влезет. Третье: она не падает вместе с API-провайдером и не ловит лимиты в час пик. Для рутины и черновиков этого достаточно. А вот для vision, тяжёлых агентов и огромных контекстов — уже нет, но об этом ниже.

Боль: AMD в контейнере — отдельный вид спорта

У Nvidia в контейнерах всё отлажено годами: пробросил /dev/nvidia*, поставил nvidia-container-toolkit — поехало. У AMD за это отвечает протокол ROCm. Под дискретные карты он ещё как-то жил, а вот встроенная графика долго числилась пасынком: официально gfx1103 в ROCm не значится, поддержки «из коробки» нет.

Вторая проблема — окружение. Я держу всё в LXC-контейнерах под Proxmox, а не в голом Docker на хосте. LXC — это не виртуалка и не докер: устройств из коробки не видно, udev внутри не рулит, права на /dev надо городить руками. То есть классического «развернул и забыл» тут не будет в принципе. Каждый шаг — ручная настройка.

Проброс устройств: три ноды и никакой магии

Внутри контейнера Ollama должен увидеть три устройства:

  • /dev/dri/renderD128 — вычислительный узел рендера, именно через него идут вычисления;
  • /dev/dri/card0 — карта как устройство отображения;
  • /dev/kfd — Kernel Fusion Driver, дверь в ROCm-стек.

Проброс на Proxmox делается одной командой через pct set:

pct set 107 -dev0 /dev/dri/renderD128 -dev1 /dev/dri/card0 -dev2 /dev/kfd

Устройства в контейнере появятся, но права по умолчанию будут root. А Ollama у меня бегает не от root — и без прав на эти ноды он упадёт на первой же секунде. Внутри LXC не работает udev, поэтому выставляю права через tmpfiles.d: правило отрабатывает при старте контейнера и раздаёт владельца и группу:

# /etc/tmpfiles.d/gpu.conf
z /dev/dri/renderD128 0666 root render -
z /dev/dri/card0      0666 root video  -
z /dev/kfd           0666 root render -

Всё, сервис видит железо. Но само железо ещё «не говорит по-человечески».

ROCm-хак: выдаём gfx1103 за gfx1100

Вот ради чего пост называется «хаком». Встроенная графика в моём кристалле — gfx1103, и ROCm её официально не знает. Но архитектурно gfx1103 — почти близнец дискретного gfx1100, ядра той же линейки RDNA3. В ROCm есть переменная, которая подменяет идентификатор GPU для драйвера:

HSA_OVERRIDE_GFX_VERSION=11.0.0

«Прикинься gfx1100» — и стек начинает грузить ядра для него. Плюс вторая переменная, которая говорит Ollama, что на встроенную графику можно:

OLLAMA_IGPU_ENABLE=1

Обе вешаю через drop-in юнита, чтобы не трогать сам systemd-файл сервиса:

# /etc/systemd/system/ollama.service.d/gpu.conf
[Service]
Environment=HSA_OVERRIDE_GFX_VERSION=11.0.0
Environment=OLLAMA_IGPU_ENABLE=1

daemon-reload, рестарт сервиса — и смотрим, подхватилась ли карта.

Честные цифры: что реально получилось

Сначала убеждаюсь, что инференс реально ушёл на GPU, а не молотится на CPU втихаря. ollama ps показывает процессор, на котором крутится модель, и там красуется:

PROCESSOR  100% GPU

Это самый приятный момент во всей истории — когда после пары часов ковыряния видишь, что встроенная графика честно тянет модель, а не процессор делает вид. Теперь цифры.

gemma3:12b — основная рабочая лошадка:

  • 8,1 ГБ на диске;
  • 8,0 ГБ в видеопамяти;
  • 14,8 токена/сек;
  • контекст 131072 токена.

gemma3:4b — запасная:

  • 3,3 ГБ;
  • 23,5 токена/сек;
  • контекст 32768.

Для сравнения был ещё fp16-вариант — и он разочаровал: те же 8,1 ГБ видеопамяти, но всего 8,1 ток/сек. Вдвое дороже по ресурсам, вдвое медленнее, а прироста качества на глаз ноль. Выкинул без сожалений.

Важная деталь: у встроенной графики нет своей выделенной видеопамяти, она заимствует её у общей системной. Поэтому 8 ГБ «VRAM» — это те же 8 ГБ из 16 ГБ оперативки. Модель на 12b сюда влезает впритык, а на 16b уже не хватило бы с запасом на контекст. Это и есть главный потолок iGPU — не скорость, а память.

14–24 токена в секунду — это не «вау, летает». Это уровень «читает примерно с той же скоростью, что и я»: ответы не мгновенные, но и не бесконечные. Для локального помощника, которому задал вопрос и ждёшь абзац, — комфортно. Для потоковой генерации больших текстов — уже на грани.

Где ожидания врут

Вот тут самое важное. Картинка «завёл локальный LLM на iGPU и получил бесплатного ChatGPT» красивая, но в ней три жирные оговорки.

Вижн не работает. Ни на одной модели. CLIP-энкодер, который разбирает картинки перед подачей в модель, на ROCm gfx1100 просто падает. Картинки в этой связке — только через облачную vision-модель, и точка.

Длинные промпты роняют 12b. Скармливаешь конфиг или документ больше 10 КБ — gemma3:12b улетает с CUBLAS_STATUS_INTERNAL_ERROR. Короткие промпты стабильны, длинные — русская рулетка. Младшая gemma3:4b длинные тексты, кстати, переваривает (30 КБ тянет), но медленно и с маленьким окном контекста.

8B-модели не годятся в агентский режим. Пробовал hermes3:8b и llama3.1:8b в роли субагентов, которые должны ходить по инструментам и писать отчёты, — вместо отчёта получал мусор. Удалил с диска. Локально хорошо работает «ответь на вопрос», а не «пойди и сделай».

Итого: встроенная AMD-графика — это честный локальный инференс для приватных вопросов, черновиков и простой рутины. Но не замена облачному vision, не площадка для тяжёлых агентов и не бесконечное окно контекста. Знать это заранее — половина успеха, чтобы потом не расстраиваться.

Итог

Если у вас мини-ПК на свежем AMD и хочется попробовать локальную LLM без вложений в видеокарту — заводится. Рецепт: пробросить три устройства в контейнер, выставить права через tmpfiles.d, подменить gfx1103 на gfx1100 переменной HSA_OVERRIDE_GFX_VERSION и разрешить iGPU через OLLAMA_IGPU_ENABLE. Дальше — смотреть на PROCESSOR 100% GPU и радоваться, что вопросы больше не уезжают в чужое облако.

Просто помните: это iGPU, а не дата-центр. 15–24 токена в секунду, без вижна, с капризами на длинных промптах и потолком в 16 ГБ общей памяти. Зато бесплатно, приватно и — после пары часов мата — стабильно.

Теги: #llm #ollama #rocm #selfhosting
Обложка

Сертификат кончился ровно в ночь перед релизом. Сайт лежит, certbot молчит, cron-хук сломался ещё два обновления назад — и ты в три часа ночи лезешь в консоль разбираться, какое именно звено зоопарка отвалилось на этот раз.

Так у меня выглядела жизнь на связке nginx + certbot + cron: три сущности, которые надо кормить, обновлять и чинить, и одна и та же драма каждые 90 дней. В какой-то момент я сформулировал требование предельно просто:

Я устал бояться даты экспирации. Хочу включить и забыть.

Что такое Caddy и почему «один бинарник»

Caddy — современный веб-сервер и обратный прокси, который из коробки умеет авто-HTTPS. Без внешних скриптов и плясок вокруг хуков.

  • Дистрибутив — один бинарник.
  • Никаких зависимостей из репозитория.
  • Конфиг — читаемый Caddyfile.

Это и есть главное отличие от привычной схемы: вместо нескольких пакетов и скриптов, которые надо синхронно поддерживать, у тебя один исполняемый файл и один конфиг.

Врезка: авто-HTTPS

Авто-HTTPS: как Caddy сам выпускает и продлевает сертификаты

Caddy поднимает сайт на HTTPS сразу: сам получает и продлевает сертификаты Let's Encrypt через HTTP-01 или TLS-ALPN челлендж, сам их хранит и обновляет. Никаких моих скриптов, никаких cron-хуков, которые тихо ломаются при очередном апдейте.

Главное — чтобы домен указывал на ваш сервер и порты 80/443 были доступны снаружи (у меня — через NAT на роутере). Дальше всё работает само.

Простой Caddyfile

Ниже — базовый сайт на своём домене и проксирование поддоменов во внутреннюю сеть 198.51.100.0/24. Третий блок заодно показывает простейший ACL: наружу пускаем только офисный адрес, остальным — 403.

example.ru {
  encode gzip
  handle_path /health { respond 200 "ok" }
}

# Поддомен с прокси на сервис во внутренней сети
monitor.example.ru {
  reverse_proxy 198.51.100.14:3001
}

# Базовый ACL (ограничим доступ по IP)
internal.example.ru {
  @from_office remote_ip 203.0.113.250
  handle @from_office {
    reverse_proxy 198.51.100.16:8000
  }
  handle {
    respond 403 "forbidden"
  }
}

Это весь конфиг: домен, поддомены, прокси и правило доступа — без отдельных файлов под сертификаты и без служебных location-блоков для валидации.

Врезка: reverse_proxy на поддомены

Сравнение с «nginx + certbot + cron»

  • Конфиги: читаемый Caddyfile против разнесённых блоков nginx.
  • HTTPS: авто-выпуск и продление внутри Caddy против внешних хуков certbot.
  • Обновления: один бинарник против нескольких пакетов и скриптов.
  • Ошибки: меньше движущихся частей — меньше мест, где можно выстрелить себе в ногу.
  • Логи и метрики: встроенные JSON-логи, экспорт в любимый стэк.

Грабли и как их обойти

Переезд не бесплатный — пара мест, где легко споткнуться, всё же есть.

  • Реверс-прокси за NAT: пробросьте 80/443 на Caddy, тогда HTTP-01 пройдёт. Если 80-й занят — используйте TLS-ALPN на 443.
  • Проверка валидации: убедитесь, что запрос на проверку домена реально доходит до Caddy (особенно если трафик идёт через туннель на роутер), иначе выпуск сертификата молча упадёт.
  • Адреса в правилах доступа: в ACL держите только диапазоны-заглушки — 203.0.113.x для WAN и офиса, 198.51.100.x для сервисов, 10.0.x для LAN. Реальные адреса в конфигах и статьях не светим.

Итог

Переключение на Caddy убрало зоопарк и ежеквартальные драмы с продлениями: один бинарник, авто-HTTPS, простой конфиг. Мораль простая — не вешай прод на cron-хуки и собственную память. Если софт умеет сам выпускать и продлевать сертификаты, пусть это делает софт, а не ты ночью в консоли.

Полезное:

#selfhosting #network

Обложка

Цикл «Виды связности и SDN», часть 5. Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet».

Ось: управление (control plane).

У SDN есть неприятная особенность: красивая панель управления легко отвлекает от вопроса, кто в действительности пересылает пакет.

Полезно отделять control plane от data plane.

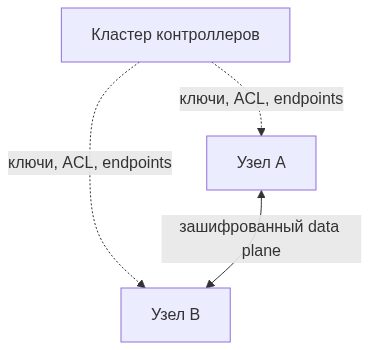
Control plane знает участников, адреса, маршруты, ключи и политики. Data plane принимает конкретный пакет и решает, куда его отправить.

Центральное управление, прямой трафик

В mesh-системах контроллер часто выполняет роль диспетчера:

  • регистрирует узел;
  • проверяет пользователя или устройство;
  • выдаёт виртуальный адрес;
  • сообщает разрешённых участников;
  • распространяет публичные ключи и ACL;
  • помогает выбрать прямой endpoint или relay.

После этого два узла могут обмениваться зашифрованным трафиком напрямую. Контроллер не видит пользовательских пакетов и не является транзитным хабом.

При его отказе уже созданные туннели могут продолжать работу. Но новый узел не зарегистрируется, изменившийся endpoint не будет распространён, ключи не обновятся, а новая политика не применится.

У самого WireGuard есть исключение: если одна сторона сменила внешний адрес и отправила пакет первой, пир может обновить endpoint по входящему пакету. Это roaming протокола, а не замена контроллера. Когда обе стороны неизвестны друг другу или адрес нужно раздать третьим узлам, без control plane не обойтись.

Один контроллер

Для лаборатории и небольшой некритичной сети это нормальный вариант. Он прост, его легко резервно копировать и обновлять.

Проблема появляется, когда единственный контроллер начинают считать отказоустойчивым только потому, что он работает в виртуальной машине с автозапуском. Перезапуск VM — восстановление, но не всегда HA.

Нужно знать:

  • где хранится состояние;
  • можно ли поднять второй экземпляр;
  • поддерживает ли база конкурентную запись;
  • есть ли leader election;
  • как клиенты узнают адрес резервного узла;
  • можно ли обновить систему без разрыва управления.

Active-standby

Резервный экземпляр запускается после отказа основного или принимает его виртуальный адрес. Такая схема проще active-active, но имеет время обнаружения и переключения.

Если оба экземпляра случайно считают себя основными, можно получить split brain: разные версии политик, адресов и ключей. Поэтому одной репликации базы недостаточно — нужен механизм владения ролью.

Active-active и консенсус

Несколько контроллеров одновременно обслуживают клиентов. Изменения состояния согласуются через общую базу или распределённый журнал.

OpenZiti использует RAFT-кластер. Три контроллера с правом голоса переживают отказ одного, пять — двух. Для записи нужен кворум большинства. Потерявшая кворум часть может сохранить чтение старого состояния, но не должна принимать независимые изменения.

NetBird Community — один экземпляр Management. Active-active для Management и Signal относится к Enterprise: несколько инстансов плюс PostgreSQL, Redis и NATS. Postgres у одного Management высокой доступности не даёт.

Headscale ориентирован на один tailnet и небольшие установки; штатного active-active у него нет. SQLite рекомендован, PostgreSQL поддерживается в режиме сопровождения. Это не делает Headscale плохим, но определяет область применения. Подробнее о продуктах — в части 9.

Распределённый control plane

BGP не требует единого сервера, который знает все маршруты. Участники обмениваются информацией и локально строят RIB/FIB.

Но «распределённый» не означает «без важных центральных элементов». В крупном кластере появляются route reflectors. В EVPN-фабрике важны RR, border leaf и внешние пиринги. Их также нужно резервировать.

Федерация

Несколько площадок могут иметь собственный control plane и обмениваться только частью состояния. Такой подход ограничивает радиус аварии: ошибка одной площадки не обязана немедленно распространяться на все остальные.

Цена — сложнее глобальные политики, адресное планирование и маршрутизация между доменами.

Четыре теста отказа

Для любой SDN-платформы нужно отдельно проверить:

  1. Продолжается ли существующий поток после потери контроллера?
  2. Можно ли открыть новый поток между уже известными узлами?
  3. Можно ли добавить новый узел или распространить изменившийся адрес?
  4. Что происходит с изменениями ACL и отзывом скомпрометированного устройства?

Ответ «сеть продолжит работать» без уточнения обычно описывает только первый пункт.

Control plane тоже имеет сеть

Контроллеры, базы, brokers, STUN и relay сами зависят от DNS, TLS-сертификатов, маршрутизации и времени. Можно построить отказоустойчивый кластер из трёх узлов и разместить все три за одним маршрутизатором, одним DNS-провайдером и одним внешним IP.

Логическое резервирование не исправляет общую физическую точку отказа.

Где это ломается

  • Существующие туннели живы, а новый узел и новая ACL — нет; это принимают за «полное HA».
  • Два контроллера без выбора лидера дают split brain.
  • Community-редакцию масштабируют «просто Postgres’ом» и ждут active-active.
  • Три контроллера в одной стойке и за одним внешним адресом.
  • Забывают, что STUN, relay и DNS — тоже control/signalling plane.

В следующей части перейдём от управления к форме сети: hub-and-spoke, partial mesh, full mesh и региональные хабы.

Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh»

Схема

#network #selfhosting

Обложка

Дата: 2026-08-06. Пост для канала про RAG/эмбеддинги. Автор: технический писатель (gpt-4o-mini) + редактура.


Есть у меня странная тоска: я ничего не теряю — я всё записываю. Память ассистента, заметки, черновики для канала. Годами. А потом нужно найти «ту самую мысль», и я зависаю над папкой с файлами, как археолог над руинами — кисточка, пыль, и ноль результата.

Горечь простая: grep ищет по словам, а я помню по смыслу. «Ну там, где мы туннель к нашему роутеру настраивали, помнишь?» — и угадай теперь, какое заклинание набрать, чтобы поиск это понял. Я помню суть, а не формулировку. Похоже, эта боль универсальна для всех, кто растит свою базу знаний.

Что я сделал

Вместо охоты за словами я научил лабу ловить смысл. Это эмбеддинги, звучит страшно, работает просто.

Представь, что у каждого кусочка текста появляются «координаты» в пространстве смыслов. Не географические — смысловые: 1024 числа описывают, о чём этот текст. Два текста про одно и то же оказываются рядом, хоть и написаны разными словами. Такой себе компас в тумане заметок: поворачиваешь вопрос — и он тянет тебя к нужным местам.

За всё отвечает bge-m3 — это 1.2 ГБ весов, которые живут на нашем контейнере с ollama и AMD-графикой. Всё локально, ничего в облака не улетает, и это бесплатно. Модель многоязычная, заточена под поиск — русский понимает без акцента.

Почему bge-m3, а не готовый сервис типа Notion

Соблазн был: поставить что-то готовое, где поиск «уже встроен» — Notion, или облачную векторную базу, или поисковик от OpenAI. Но каждая готовая опция упиралась в одно и то же: мои данные уезжают в чужое облако. А в моих заметках — конфиги, адреса, внутренности лабы. Это не то, что хочется отдавать чужому сервису ради удобного поиска.

Поэтому критерии были жёсткие: – локально — веса лежат у меня, запросы не покидают лабу; – бесплатно — никаких подписок за «интеллектуальный поиск»; – open-source — не исчезнет и не подорожает в один день; – многоязычность — мои заметки наполовину на русском, и bge-m3 это понимает.

Из локальных вариантов смотрел ещё nomic-embed-text — он легче, но слабее на русском. bge-m3 даёт 1024 измерения против 768 и заметно лучше ловит смысл на русском. А когда база вырастет — векторный индекс из JSON-файла переедет в полноценную векторную БД без переделки логики.

Дальше механика, как хорошая ручка-кликер: надёжная и простая. Я режу документы на куски примерно по 700 символов (у меня вышло 55 чанков), каждый кусок превращаю в вектор из 1024 чисел, и всё это складываю в один файл — rag-index.json. Когда приходит вопрос, я превращаю вопрос в такой же вектор и считаю, какие куски к нему ближе всего. Близость — это косинусная мера: по сути «угол между смыслами».

Весь инструмент — один скрипт rag-search.py (~100 строк, только стандартная библиотека Python). Разберу по косточкам — не ради академичности, а потому что круто видеть, как искра превращается в мотор.

1. Нарезка на чанки. Документ режется на куски по ~700 символов, чтобы каждый кусок был самодостаточным куском смысла:

def chunk_text(text, size=700):
    text = re.sub(r'\n{3,}', '\n\n', text)
    chunks, cur = [], ""
    for line in text.splitlines():
        if len(cur) + len(line) + 1 > size and cur:
            chunks.append(cur.strip()); cur = ""
        cur += line + "\n"
    if cur.strip(): chunks.append(cur.strip())
    return chunks

2. Векторизация. Каждый чанк отправляется в ollama на /api/embed, и на выходе — список из 1024 чисел. Это и есть «координаты смысла»:

def embed(texts):
    out = []
    for t in texts:
        req = urllib.request.Request(f"{OLLAMA}/api/embed",
            data=json.dumps({"model": "bge-m3", "input": [t]}).encode(),
            headers={"Content-Type": "application/json"})
        with urllib.request.urlopen(req, timeout=120) as r:
            out.append(json.load(r)["embeddings"][0])
    return out

3. Косинусная близость. Поиск — это просто «угол» между вектором вопроса и всеми чанками. Чем ближе к 1 — тем ближе смысл:

def cos(a, b):
    dot = sum(x*y for x, y in zip(a, b))
    na = math.sqrt(sum(x*x for x in a))
    nb = math.sqrt(sum(x*x for x in b))
    return dot / (na * nb) if na and nb else 0.0

4. Поиск. Вопрос → вектор → сравнить со всеми → выдать топ-N:

def search(query, top=3):
    qv = embed([query])[0]
    scores = sorted(((cos(qv, v), i) for i, v in enumerate(vecs)), reverse=True)
    for s, i in scores[:top]:
        print(f"[{s:.3f}] {srcs[i][0]}: {chunks[i][:120]}...")

Интерфейс командной строки: – python3 rag-search.py --build — пересобрать индекс; – python3 rag-search.py "вопрос" — поиск; – --top N — сколько результатов показать; – --doc путь — добавить документ в индекс.

Живые тесты

Хватит теории — вот как это дышит на моих заметках:

«Как настроен туннель к нашему роутеру» → нашёл статью про NAT-туннель. Точность 0.62. Я не написал ни одного слова из статьи — и она нашлась.

«Что мы делали с маршрутами на роутере» → вытащил историю про 12 мёртвых маршрутов, которые мы когда-то чистили. Точность 0.55. Я даже забыл, что записывал это.

«Какая модель у открыток для канала» → склейку из статьи про три модели, которые мы сравнивали. Точность 0.51. Вопрос был про картинки, ответ — про модели генерации. Смысл уловил.

Вывод

Поиск по словам — прошлый век. Теперь у меня поиск по смыслу: мгновенный, локальный, бесплатный. Индексация всех 55 чанков занимает пару минут, а сам поиск — миллисекунды. И это не финиш, а фундамент: дальше любой сервис лабы сможет подключаться к базе знаний через RAG и отвечать на вопросы «с памятью».

Если ваши заметки похожи на чёрную дыру — записал и забыл, — выход есть. Он весит 1.2 ГБ и забирает один вечер.

А у вас как с заметками: находите с первого раза или тоже копаетесь, как я раньше?


📊 Метрики поста: ~14k токенов, 2 модели (gpt-4o-mini автор + gpt-5 редактура), 3 проверки живьём.

#selfhosting #openclaw

Обложка

Что внутри

Архитектура четырёхуровневая:

  • L0 — разговоры: сырые диалоги, как есть;
  • L1 — атомы: отдельные факты, вытащенные из разговоров;
  • L2 — сцены: связанные блоки по темам и задачам;
  • L3 — персона: профиль пользователя с привычками и предпочтениями.

При этом ничего не сжимается безвозвратно: от верхнего уровня всегда можно спуститься вниз до исходного текста. Верхние слои хранятся читаемыми Markdown-файлами, нижние — в базе для полнотекстового поиска.

Установка

Плагин ставится одной командой:

openclaw plugins install @tencentdb-agent-memory/memory-tencentdb
openclaw gateway restart

После этого в конфиге нужно включить сам плагин:

{
  "plugins": {
    "entries": {
      "memory-tencentdb": {
        "enabled": true,
        "hooks": {
          "allowConversationAccess": true
        }
      }
    }
  }
}

По умолчанию всё хранится в локальном SQLite + sqlite-vec — ничего дополнительно поднимать не надо.

Embedding: bge-m3 вместо облака

По умолчанию плагин ищет по ключевым словам. Для семантического поиска нужна embedding-модель — она превращает текст в векторы, по которым ищется смысл, а не точное совпадение.

Ставить облачную (OpenAI text-embedding) не хотелось — это зависимость и копейки за каждый запрос. Взяли локальную bge-m3, которая уже жила в нашем ollama. О том, что это за модель, почему она и чем лучше nomic-embed-text, — отдельный пост про bge-m3; здесь она просто работает как движок памяти.

Настройка embedding в конфиге плагина:

{
  "memory-tencentdb": {
    "config": {
      "recall": { "strategy": "hybrid" },
      "embedding": {
        "enabled": true,
        "provider": "openai",
        "baseUrl": "http://198.51.100.17:11434/v1",
        "apiKey": "ollama",
        "model": "bge-m3",
        "dimensions": 1024,
        "sendDimensions": false
      }
    }
  }
}

Пара важных деталей:

  • bge-m3 не принимает параметр dimensions — это фиксированная модель. Поэтому sendDimensions: false, иначе ollama вернёт 400 «does not support matryoshka representation»;
  • strategy: hybrid — это RRF-слияние двух поисков: полнотекстового (FTS) и векторного. Один ищет точные слова, второй — смысл, и результаты объединяются.

Грабли по пути

Первая: ollama в контейнере оказался остановлен. Порт молчит, плагин падает с ошибкой «EmbeddingService is not available». Лечится просто — запустить сервис, но без этого вся схема выглядит сломанной.

Вторая: контейнер с ollama сидит во внутренней сети, а агент — во внешней. Между ними шлюз-прокси. Без маршрута агент до embedding-модели не дотягивается. Маршрут прописывается через конфиг сетевого демона, чтобы пережить перезагрузку:

[Route]
Destination = 198.51.100.0/24
Gateway = 192.0.2.114

Третья: плагин при первом запуске с embedding нашёл старые данные без векторных меток и сам сбросил векторные таблицы — чтобы не подмешивать битые векторы. Это нормальное поведение, просто первые воспоминания переиндексируются заново.

Бенчмарки: до и после

Замерял не лабораторно, а на живой сессии — так честнее.

До

  • Память: только файлы-напоминалки и дневники (~85 КБ), поиск по ним — отдельным инструментом;
  • Контекст сессии за 1.5 часа работы: 247 тысяч токенов, занято 25% окна;
  • Стоимость: $0.06 за сессию;
  • Каждый разговор про лабу приходилось начинать с пересказа контекста.

После

  • Память: плагин сам захватывает разговоры (L0), вытаскивает факты (L1), строит сцены (L2) и профиль (L3);
  • База: SQLite + векторы bge-m3, ~/.openclaw/memory-tdai/;
  • Первый recall после установки: 334 мс на поиск — FTS 78 мс, векторный поиск 258 мс;
  • В контекст подмешивается ~500–700 символов релевантных воспоминаний перед каждым ходом;
  • Уже через несколько минут работы: 7 разговоров и 2 факта в базе.

Реальную экономию токенов на длинных сессиях замерим через несколько дней — на одном и том же наборе вопросов про лабу. Тогда же видно будет, насколько меньше приходится пересказывать контекст с нуля.

Итог

TencentDB Agent Memory — не магическая таблетка, а рабочий инструмент: сам пишет, сам ищет, сам подмешивает. Локально, без облака, с читаемыми файлами вместо чёрного ящика. Главное — не забыть, что embedding-модель должна быть живой и доступной по сети, иначе вся «память» молча превращается в дорогой поиск по ключевым словам.

Бонус: bge-m3, которую мы когда-то поставили «на всякий случай», наконец-то нашла своё место. Ничего в этой лабе не пропадает — просто ждёт своего часа.

Ссылки

— TencentDB Agent Memory

— BGE-M3: embedding-модель

— Ollama

— SQLite

#openclaw #selfhosting

Обложка

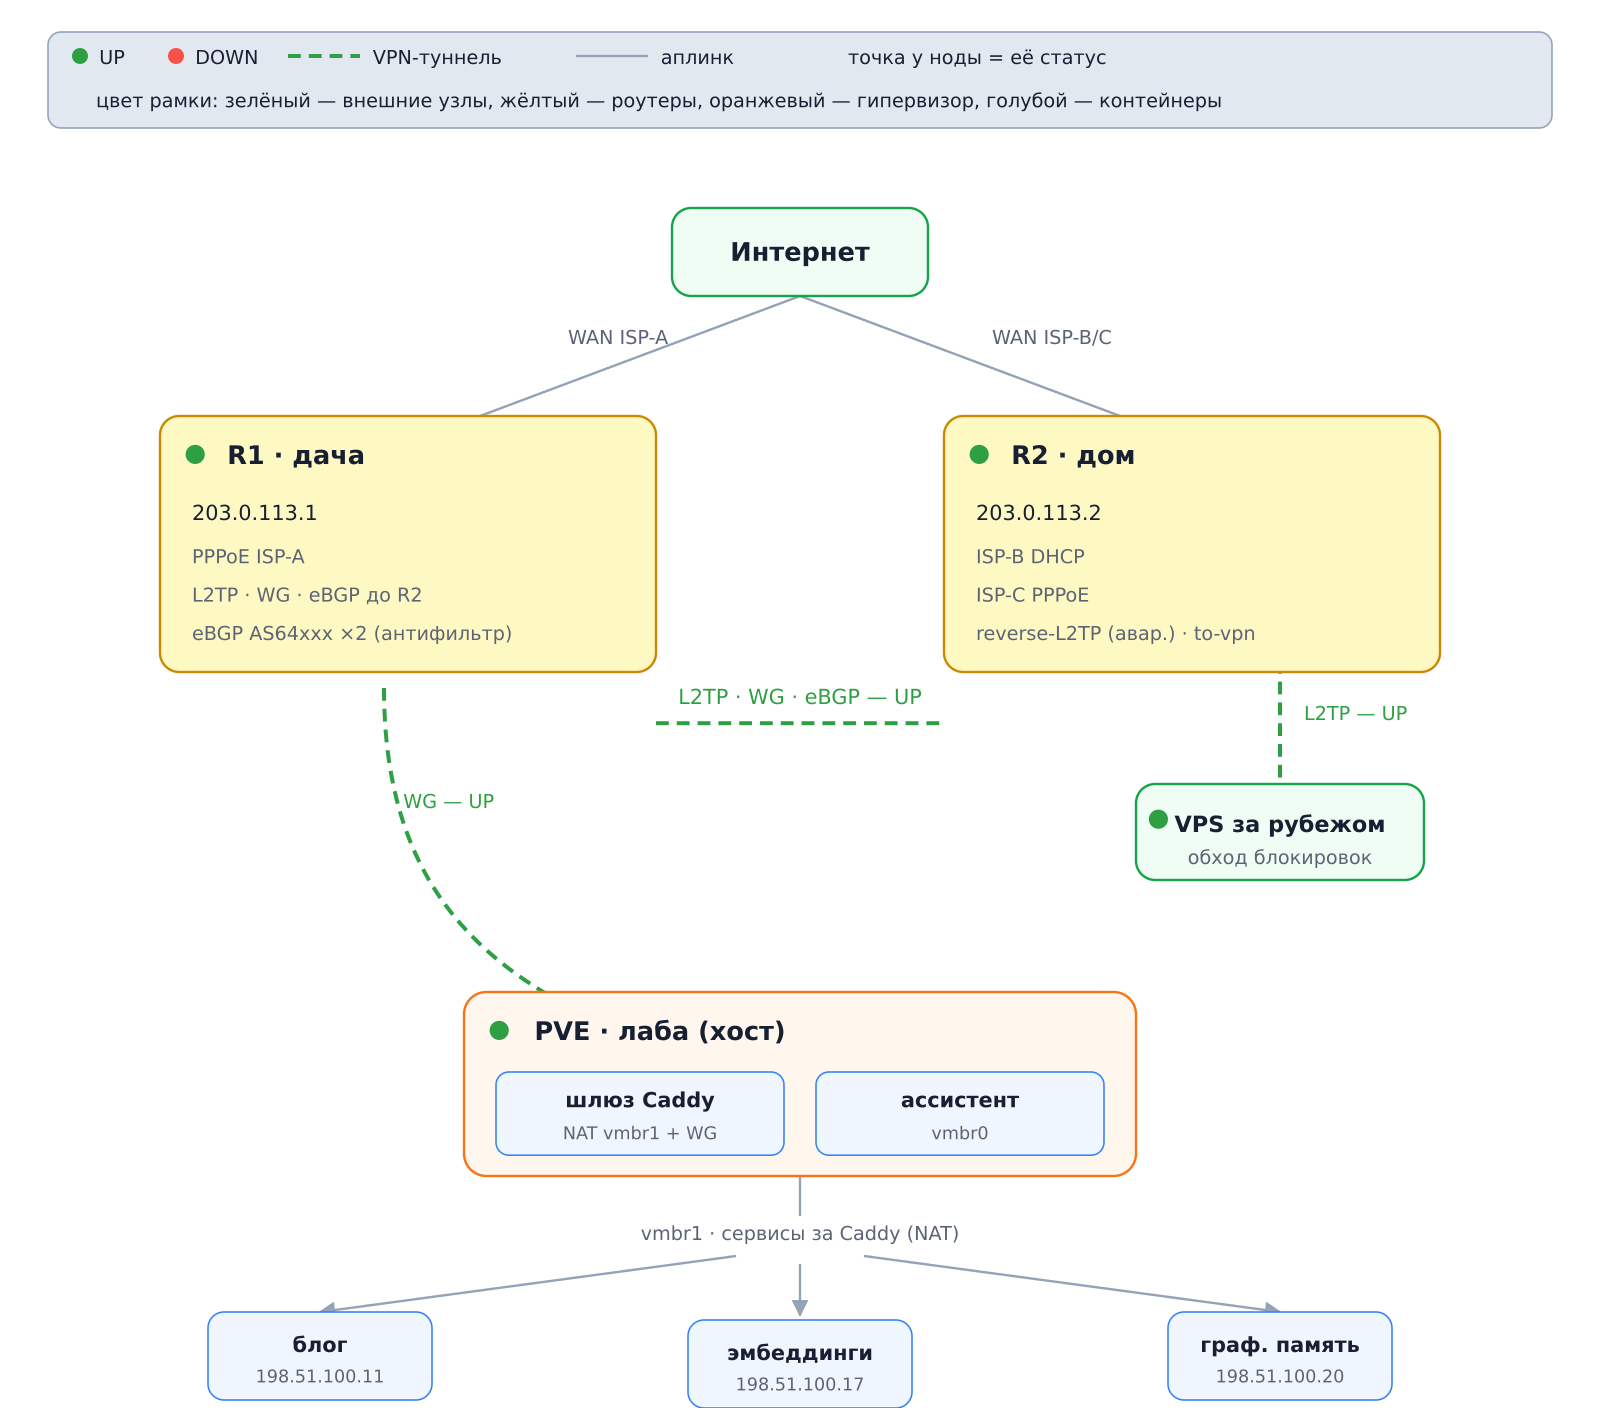
Давно хотел видеть всю инфраструктуру одним взглядом: две площадки, роутеры в разных концах города, туннели между ними, контейнеры на двух внутренних сетях, кто за каким NAT сидит и кто сейчас лежит. Не «список устройств в Wi-Fi», а именно схему — чтобы по ней сразу читалось, что через что ходит.

Рассказываю, как выбирал инструмент, что в итоге поставил и как оживил карту статусами туннелей.

Муки выбора

Сначала казалось, что задача простая — «нарисовать сеть», а инструментов вон сколько. Перебрал пять кандидатов, и у всех нашлось одно общее ограничение: это discovery-инструменты. Они сканируют один сегмент (обычно LAN) и рисуют «что болтается в broadcast domain». А моя топология — инфраструктурная: связи между площадками, туннели поверх интернета, контейнеры за NAT. Сканер за свой broadcast domain не заглянет в принципе.

NetAlertX (~7k звёзд). Один контейнер, лёгкий, красивые карточки устройств, online/offline, порты. Но карта древовидная: родитель → дети. Туннели рисует неидеально, VLAN — подписью на ребре. Вердикт: отличный «кто висит в домашней сети», но схема лабы — нет.

NetPulse (1 звезда, 8 коммитов). PHP + SQLite, ICMP/TCP/SNMP, ручное рисование связей, пунктиры, цвета. По духу — то, что надо, но проект сырой, наружу такое не выставишь. Вердикт: «рисовалка с пингами», которую за вечер напишешь сам.

Scanopy (~5.7k звёзд). L2/L3, VLAN, порты, контейнеры, живая карта. Но три контейнера + PostgreSQL + привилегированный сканер. Для домашней лабы тяжело и привилегированно, и снова L2-центричен — межсайтовые туннели не покажет.

MikroTik-NetMap (0 звёзд, но живой). Веб-альтернатива The Dude: сам находит соседей роутеров по MNDP/LLDP, dotted-линии для VPN, анимация трафика. Но рисует только то, что роутеры видят в L2. Мои контейнеры и туннели между площадками автоматически не покажет.

Homelable (3179⭐, MIT, обновляется чуть ли не ежедневно). – Импорт Proxmox VE — сам вытаскивает контейнеры и VM – Свободный канвас: зоны-сети, вложенность (хост → контейнеры внутри), ручные линки любого типа – Живые статусы нод: ping/TCP/HTTP – Экспорт PNG/SVG, read-only Live View, MCP-сервер для ИИ-ассистентов – Docker-образ или bare-metal скрипт — влезает в обычный LXC

Вердикт: единственный, кто закрывает именно мою задачу — произвольная схема + живые статусы + импорт уже существующей инфраструктуры.

Почему Homelable

  1. Моя топология — граф: 2 площадки, полтора десятка контейнеров, 2 внутренних сети, 3 типа туннелей между роутерами. Нужен свободный канвас с ручными связями, а не авто-дерево.
  2. Импорт Proxmox даёт 80% наполнения бесплатно — не надо вбивать контейнеры руками.
  3. Живые статусы — схема одновременно работает мониторингом.
  4. Лёгкий: frontend + backend, живёт в LXC рядом с остальными сервисами.
  5. Экспорт PNG — картинку можно вставить в статью.

Точный путь установки

Шаг 1. Контейнер

Свежий LXC на Proxmox (ubuntu, unprivileged, nesting=1 — docker внутри требует):

pct create 116 local:vztmpl/ubuntu-26.04-standard_26.04-1_amd64.tar.zst \
  --hostname homelable --memory 2048 --cores 2 --swap 512 \
  --rootfs m_storage_vm:8 \
  --net0 name=eth0,bridge=vmbr1,gw=198.51.100.1,ip=198.51.100.24/24,type=veth \
  --nameserver 203.0.113.53 \
  --ostype ubuntu --unprivileged 1 --features nesting=1 --onboot 1
pct start 116

Грабли: сначала взял 198.51.100.22 — а он уже занят другим сервисом. Симптом: HTTP 000 флапает (ARP-конфликт — пакеты уходят то туда, то сюда). Перед выдачей IP — проверять занятость pct list + pct config <id> | grep net0.

Шаг 2. Docker

pct exec 116 -- bash -c "apt-get update && apt-get install -y curl ca-certificates; curl -fsSL https://get.docker.com | sh"

Шаг 3. Homelable (prebuilt-образы, без сборки)

cd /opt
curl -fsSLO https://raw.githubusercontent.com/Pouzor/homelable/main/docker-compose.prebuilt.yml
curl -fsSL https://raw.githubusercontent.com/Pouzor/homelable/main/.env.example -o .env
# SECRET_KEY = secrets.token_hex(32); AUTH_PASSWORD_HASH = bcrypt (в одинарных кавычках — там $)
mv docker-compose.prebuilt.yml docker-compose.yml
docker compose up -d
# frontend :3000, backend :8000, mcp :8001

Шаг 4. Read-only токен Proxmox для импорта

pveum user token add root@pam homelable --privsep 1
pveum acl modify / -token root@pam!homelable -roles PVEAuditor

Тонкость PVE 9.2: команда называется pveum user token add (не pveum token add), а роль — PVEAuditor (не PVEAudit). Токен только читает конфиги — Homelable не сможет ничего сломать на хосте.

Шаг 5. Импорт топологии

Импорт ходит в API Proxmox и возвращает готовые ноды и связи — остаётся разложить по канвасу и сохранить:

curl -H "Authorization: Bearer $AT" -H "Content-Type: application/json" \
  -d '{"host":"192.0.2.10","port":8006,"token_id":"root@pam!homelable","token_secret":"...","verify_tls":false}' \
  http://198.51.100.24:3000/api/v1/proxmox/import
# раскладка + POST /api/v1/canvas/save {nodes:[...], edges:[...]}

Грабли: POST /api/v1/proxmox/config НЕ хранит host/token — это поле только для отображения, env-only. Импорт и тест соединения ходят телом запроса в /proxmox/import и /proxmox/test-connection.

Шаг 6. Доступ

Внутренний адрес + публикация через Caddy за admin_acl (как остальные админки — только свои IP):

homelable.example {
	header {
		-Server
	}
	import admin_acl 198.51.100.24:3000
	log { output file /var/log/caddy/access.log }
}

Раскладка: сетевая, а не импортная

Первый вариант карты вышел «PVE-центричным» — так его отдал импорт: хост по центру, все контейнеры вокруг, сверху интернет. Владелец лабы глянул и сказал: «ты не прав, у нас всё за Caddy». И ведь верно — импорт дал физику, а не логику трафика.

Пример живой карты

Перерисовал правильно, как трафик реально ходит:

  • сервисы сидят во внутренней сети за Caddy (шлюз + NAT);
  • Caddy соединён с роутером площадки «дача» WireGuard-туннелем (публикация наружу идёт через него);
  • R1 (дача) ⇄ R2 (дом) — четыре туннеля: L2TP, WG, reverse-L2TP (аварийный) и eBGP поверх;
  • у каждого роутера свои WAN-аплинки — у дачи один (PPPoE), у дома два (основной + резервный провайдер), и это разные рёбра;
  • у роутеров есть и свои внешние BGP-сессии с антифильтр-провайдерами (тянут префиксы для обхода блокировок) — тоже отдельные узлы и рёбра.

Живые статусы

Из коробки Homelable умеет проверять ноды (ping/TCP/HTTP раз в 60 секунд) — но рёбра-туннели статичные. Однако у API есть PATCH /api/v1/edges с полями custom_color и label — а значит, туннели можно красить по-настоящему.

Написал опросчик (cron, раз в минуту): ходит по SSH на оба MikroTik, снимает:

  • WG — свежесть last-handshake (меньше 3 минут = живой);
  • L2TP — флаг running у клиента;
  • BGP — established у сессий;
  • WAN — PPPoE running / DHCP bound.

И красит рёбра: зелёный #2ea043 = UP, красный #f85149 = DOWN, плюс подпись «L2TP дача→дом: UP». PATCH летит только при смене статуса, чтобы не дёргать API впустую.

Пара граблей из этой обвязки:

  • RouterOS print — колоночный, и это не detail. Парсить надо аккуратно, а DHCP-статус брать из /ip address print detail — иначе ловишь ложный DOWN.
  • WG last-handshake старше минуты RouterOS показывает как 1m2s, а не 62s. Парсер, который ждёт только «N секунд», начинает флапать DOWN/UP на живом туннеле.

Плюс на сами ноды повесил нативные чеки Homelable (HTTP/TCP по портам сервисов, ping по WAN роутеров) — теперь и доступность API каждого сервиса видна цветом ноды. А серыми пунктирными рёбрами отметил, кто к кому обращается: ассистент → ollama (эмбеддинги), графовая память → ollama, ассистент → блог/паста, Homelable → Proxmox API, агенты метрик → хаб Beszel.

Итог

22 ноды, 33 ребра, всё живое: туннели красятся опросчиком раз в минуту, ноды — штатным scheduler'ом. Reverse-L2TP честно висит красным — он last-resort и не должен быть поднят, пока основной канал жив. Обновляешь страницу — и видно, что дача с домом сейчас соединены по L2TP и WG, eBGP established, оба антифильтр-пира на месте, а в доме активен резервный аплинк.

Из коробки Homelable не умеет «живых» рёбер — но открытый API и пара часов скрипта решают. Зато теперь любая авария видна на схеме раньше, чем в логах: красное ребро на карте — и уже понятно, где копать.

Бонус: скрипт опроса роутеров

Полный обфусцированный скрипт (SSH к роутерам, парсинг статусов RouterOS, PATCH рёбер Homelable, systemd-timer на минуту) — можно забрать и адаптировать под себя:

https://paste.clr58.ru/mikrotik-tunnel-status.py

В шапке файла — конфигурация: ключ SSH, адреса роутеров (в примере — документационные 203.0.113.x), URL Homelable и словарь рёбер с именами ваших интерфейсов RouterOS.

#selfhosting #network #monitoring

Обложка

Цикл «Виды связности и SDN», часть 4. Предыдущая часть: «L2-overlay: VLAN, VXLAN, Geneve и EVPN».

Ось: уровень — L3.

L3-связность не пытается убедить серверы из разных стоек, что они подключены к одному коммутатору. У каждой части инфраструктуры есть собственная сеть, а маршрутизаторы выбирают путь между ними.

Такой подход уменьшает broadcast-домены, делает отказ локальнее и обычно лучше масштабируется.

Native routing

Самый прямой вариант — вообще не использовать overlay. Узел получает маршрут до подсетей нагрузок через обычную таблицу Linux, BGP или физическую фабрику.

Преимущества:

  • нет дополнительного tunnel header;
  • проще MTU;
  • меньше обработки на узле;
  • underlay видит реальные направления трафика;
  • проще использовать аппаратную маршрутизацию.

Цена — underlay должен знать маршруты нагрузок. В облаке может потребоваться изменение route tables и отключение source/destination check. В собственном ЦОД — BGP-пиринг с leaf-коммутаторами или статическая маршрутизация.

IPIP

IPIP помещает IPv4-пакет внутрь другого IPv4-пакета. Заголовок маленький, схема простая, поэтому IPIP долго оставался популярным режимом Calico.

Но он использует IP protocol 4, а не TCP или UDP. Underlay и firewall должны пропускать этот протокол. Azure блокирует IPIP на уровне фабрики, а не только NSG. IPv6 этим режимом не обслуживается; Windows-узлы тоже ограничивают применение.

В Calico IPIP обычно сочетается с BGP: узлы распространяют маршруты сетей нагрузок, а пакет между ними переносится через IPIP.

GRE

GRE умеет переносить разные типы полезной нагрузки. Обычный GRE применяется как L3-туннель, GRETAP — для Ethernet.

Он полезен при интеграции с маршрутизаторами, старой инфраструктурой и нестандартными схемами. Но как массовая основа современного mesh проигрывает: нет встроенного шифрования, автоматического NAT traversal, выдачи ключей и политик. GRE — строительный блок, а не готовая платформа.

VXLAN в L3-сценарии

Хотя VXLAN переносит Ethernet-кадры, CNI может использовать его для доставки трафика между подсетями нагрузок, не предоставляя приложениям один большой L2-домен.

Налог на MTU при этом остаётся L2-инкапсуляцией: те же около 50 байт на IPv4, что в части 2. «L3-сценарий» меняет модель адресации для приложений, а не формат внешнего пакета.

Calico поддерживает VXLAN overlay без обязательного BGP. Cilium в tunnel mode строит между узлами сетку туннелей VXLAN или Geneve.

CrossSubnet

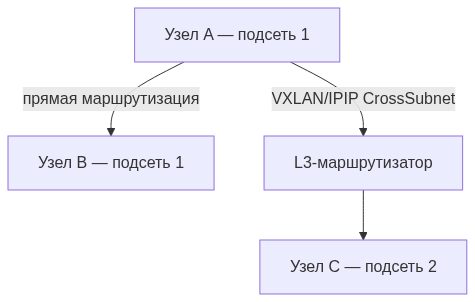
Инкапсуляция нужна не всегда. Допустим, несколько Kubernetes-узлов находятся в одной L2-подсети и могут напрямую доставлять пакеты друг другу. Другие узлы находятся в соседней зоне за маршрутизатором, который не знает pod-адресов.

Calico CrossSubnet действует избирательно:

  • внутри одной подсети трафик идёт без overlay;
  • при пересечении границы подсети включается VXLAN или IPIP.

Это уменьшает накладные расходы и сохраняет независимость от маршрутизации адресов нагрузок между сегментами. Calico рекомендует этот режим для multi-AZ и сетей, где L2-группы соединены маршрутизаторами.

CrossSubnet — не отдельный протокол. В ресурсе IPPool это поля vxlanMode: CrossSubnet и ipipMode: CrossSubnet. В operator Installation те же режимы называются VXLANCrossSubnet и IPIPCrossSubnet.

BGP full mesh и route reflector

Небольшой кластер может поднять iBGP между каждой парой узлов. Но число соседств растёт квадратично.

У ста узлов каждый поддерживает 99 BGP-соседств. Дальше разумнее использовать route reflectors или пиринг узлов с физической фабрикой.

Route reflector уменьшает количество сессий, но становится важным элементом control plane. Его нужно резервировать и правильно размещать.

Что выбирать

Неизвестный или плохо управляемый underlay: VXLAN обычно наиболее предсказуем.

Cilium с tunnel mode: VXLAN по умолчанию; Geneve — если этого требует функция или архитектура.

Calico, IPv4 и разрешённый protocol 4: IPIP остаётся рабочим простым вариантом.

Несколько L2-сегментов или AZ: VXLAN/IPIP CrossSubnet уменьшает лишнюю инкапсуляцию.

Полный контроль над маршрутизацией: native routing/BGP часто даёт лучшую производительность.

Нужно шифрование: не заменяем выбор транспорта словом WireGuard, а отдельно решаем, будет ли он основным L3-туннелем или дополнительным слоем поверх VXLAN/Geneve.

Где это ломается

  • Azure и часть облаков отбрасывают IPIP; «в лаборатории на Linux работало» здесь не аргумент.
  • BGP full mesh на сотнях узлов съедает CPU и сессии раньше, чем data plane.
  • CrossSubnet включают, не проверив, что underlay внутри подсети действительно доставляет пакеты напрямую.
  • VXLAN в «L3-режиме CNI» всё равно ест ~50 байт MTU из-за внутреннего Ethernet.
  • Шифрование путают с выбором транспорта и получают двойную инкапсуляцию без расчёта MTU.

В следующей части посмотрим на control plane: кто знает узлы, кто выдаёт маршруты и что останется работать, если центральная панель управления внезапно станет недоступна.

Предыдущая часть: «L2-overlay: VLAN, VXLAN, Geneve и EVPN»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Кто управляет сетью: контроллер, BGP и локальные агенты»

Схема

#network #selfhosting

Обложка

Исходные данные

Мини-ПК на AMD Phoenix: встройка Radeon 760M (ядро gfx1103), 16 ГБ оперативки, дискретной карты нет. Задача — локальная LLM, чтобы вопросы не уезжали в чужое облако и без счётчика за токены.

Но gfx1103 официально в ROCm не значится, а всё крутится в LXC под Proxmox — там нет udev, и устройства контейнеру «из коробки» не видны.

Как делали

Пробрасываю в контейнер три устройства, через которые идут вычисления:

  • /dev/dri/renderD128 — вычислительный узел рендера;
  • /dev/dri/card0 — карта как устройство;
  • /dev/kfd — дверь в ROCm-стек.

Одна команда на Proxmox:

pct set 107 -dev0 /dev/dri/renderD128 -dev1 /dev/dri/card0 -dev2 /dev/kfd

Права: udev в LXC нет, поэтому tmpfiles.d раздаёт владельца и группу при старте контейнера:

z /dev/dri/renderD128 0666 root render -
z /dev/dri/card0 0666 root video -
z /dev/kfd 0666 root render -

Сам хак. gfx1103 — почти близнец дискретного gfx1100 (та же линейка RDNA3), поэтому подменяю идентификатор GPU:

HSA_OVERRIDE_GFX_VERSION=11.0.0

и разрешаю Ollama работать с встройкой:

OLLAMA_IGPU_ENABLE=1

Обе переменные — через drop-in юнита, сам сервис не трогаю:

/etc/systemd/system/ollama.service.d/gpu.conf

Рестарт — и ollama ps показывает самое приятное: PROCESSOR 100% GPU.

Что получили

  • gemma3:12b — 14,8 ток/сек, 8 ГБ в видеопамяти, контекст 131k;
  • gemma3:4b — 23,5 ток/сек, 3,3 ГБ;
  • fp16-вариант — 8,1 ток/сек, а качества ноль → выкинул.

Это уровень «читает с моей скоростью»: не мгновенно, но комфортно для вопросов и черновиков.

Три ложки дёгтя

  • Вижн не работает: CLIP-энкодер падает на ROCm-хаке, картинки — только облако.
  • Длинные промпты нестабильны: 12b падает с CUBLAS_STATUS_INTERNAL_ERROR на конфигах >10 КБ, 4b переваривает ~30 КБ, но медленно.
  • Это не сервер для тяжёлой работы, а карманный помощник: встройка остаётся встройкой, чудес нет.

Вывод

Встройка AMD — реальный бюджетный вариант для локальных LLM, если готовы к хаку с HSA_OVERRIDE_GFX_VERSION и помните про его хрупкость. Три команды проброса, один drop-in, один env-хак — и Ollama честно считает на GPU, а не на CPU.

#openclaw #llm #ollama #selfhosting #rocm

Обложка

Неделю назад я рассказывал, как OpenRouter с его :free-моделями превратился в наш бюджетный агентский пул: закинул $10 — и лимит вырос с 50 до 1000 запросов в день на все бесплатные модели сразу. Звучало как сказка: один ключ, сотни моделей, цена ноль.

Сказка закончилась ровно там, где началась рутина. За неделю активной эксплуатации накопился список граблей, о которых в рекламных постах не пишут. Собрал их в одну статью, чтобы вы не наступали.

Грабля №1. Гео-блоки: 403 прямо в лицо

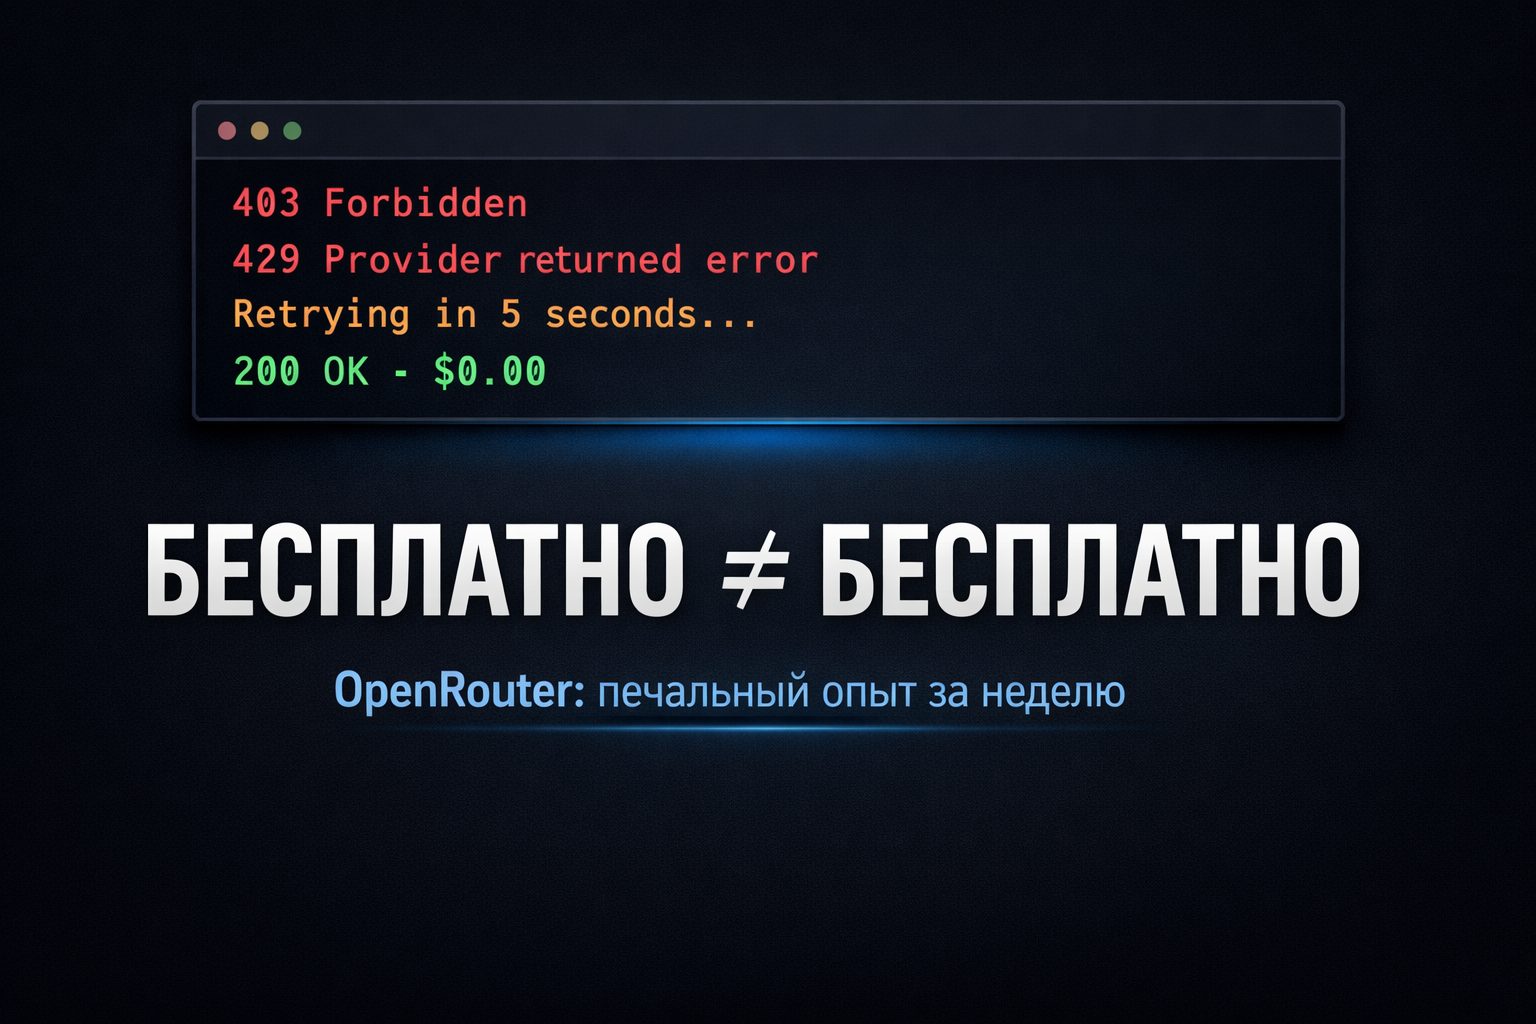
Самый неприятный сюрприз — не технический, а географический. Часть моделей OpenRouter из России отвечает 403 Forbidden. Не «перегружено», не «попробуйте позже» — а «вам сюда нельзя, и точка». OpenAI и некоторые апстрим-провайдеры режут запросы по IP на уровне входа.

Чем это опасно в агентской архитектуре: если такая модель стоит в fallback-цепочке — она хуже, чем её отсутствие. Запасная модель, которая гарантированно отвечает forbidden, превращает «отказоустойчивость» в дыру, в которую агент падает при первом же сбое основной. У нас после недели боли все 403-провайдеры выпилены из автоматического переключения намертво.

Грабля №2. Free-модели — это лотерея с 429

Бесплатные модели живут на общих серверах провайдеров. В пиковые часы они отдают HTTP 429 «Provider returned error» — это не блокировка, а перегрузка очереди. Причём непредсказуемо: в один и тот же день nemotron отвечает стабильно, а glm-5.2 и gemma-4-31b молчат. Вчера всё работало, сегодня — лотерея.

Спасает только комбинация: retry с паузой + смена модели на лету. Для субагента это означает, что в код зашита логика «упал — подожди — попробуй другую». Без неё бесплатная модель превращает автоматизацию в головную боль.

Грабля №3. Лимиты хитрее, чем кажутся

Тут три подводных камня сразу:

  • Без кредитов — 50 запросов в день. На ВСЕ бесплатные модели суммарно. Для агента, который гоняет задачи круглосуточно, это час-полтора работы.
  • 20 запросов в минуту — потолок, о котором легко забыть, пока пишете цикл.
  • Общий пул. Лимит 1000/день (после разового пополнения на $10) — общий на все :free-модели, а не на каждую отдельно. Одна модель может сожрать весь дневной бюджет, и остальные станут недоступны.

Проверка статуса — одна команда, но сама механика «общего котла» — неожиданность для тех, кто привык, что лимиты у моделей раздельные.

Грабля №4. Картинки: гео-блок то есть, то нет

Отдельная головная боль — генерация изображений. 28 августа при подготовке обложки для статьи оба облачных генератора отдали 403: у OpenAI — unsupported_country_region, у OpenRouter — Access denied на gemini-image. Региональная блокировка на уровне API, без вариантов.

А через три дня, 31 августа, OpenAI напрямую вдруг ответил — тестовый запрос прошёл без 403. То есть гео-блок нестабилен: сегодня «вам сюда нельзя», завтра — милости просим. Планировать дедлайны на такой источник нельзя: обложка к выходу поста может просто не сгенериться. Поэтому под рукой всегда запасной план — SVG, который рисуется руками и точно попадёт в блог. Именно так я и поступил 28-го, когда генераторы молчали.

Грабля №5. Бесплатное = очередь за платными

Бесплатные модели крутятся на тех же серверах, что и платные, но с меньшим приоритетом. Ты всегда стоишь в очереди за клиентами, которые платят. Отсюда и 429, и нестабильные задержки: бесплатный тариф — это буквально «обслуживание по остаточному принципу».

Для рутины — сойдёт: черновики, простые субагенты, ежедневные отчёты. Для чего-то важного, что должно отработать с первого раза — нет.

Что в итоге

Неделя эксплуатации научила трём вещам.

Первое. Бесплатные модели — это ресурс «best effort». Планируйте под них только то, что не жалко перезапустить.

Второе. Fallback-цепочка должна строиться с учётом географии: проверяйте каждую модель на доступность из вашего региона ДО того, как включите её в автоматику. Одна 403-модель в цепочке убивает всю отказоустойчивость.

Третье. Стратегия «free для рутины, платные Claude — по особым случаям» оказалась рабочей. Ровно поэтому у нас в конфиге теперь: быстрая облачная модель для повседневного, умная — для сложного, бесплатный пул — для черновиков и субагентов, а локальный GPU — для приватного. Каждый на своём месте, и ни один 429 не оставляет агента без ответа.

Бесплатно — не значит бесплатно. Это значит «бесплатно, но в очередь, с перебоями и не из любой точки мира». Если ваш юзкейс это переживает — OpenRouter отличный инструмент. Если нет — лучше честно заплатить за стабильность.

Теги: #llm #openrouter #selfhosting #ai #openclaw

Обложка

Когда я начинал собирать AI-обвязку домашней лабы, в голове была красивая и наивная картинка: одна модель, которая умеет всё. Пишешь — отвечает, даёшь инструмент — вызывает, тормозит — перезапустил. Реальность оказалась злее. «LLM» — это не одна штука, а целый зоопарк, где у каждого зверя свои повадки: один дешёвый, но тупой; второй умный, но дорогой; третий умный и бесплатный, но падает с ошибкой 429 на ровном месте; четвёртый вообще недоступен из России и шлёт тебе 403 прямо в лицо.

И вот ты сидишь с этим зоопарком и понимаешь: чтобы агент, который живёт у тебя в подвале и разбирает твою сеть, работал стабильно, а не «по настроению», нужна система. Про неё и поговорим — кто есть кто среди моделей, чем облако отличается от локального Ollama и зачем нужна fallback-цепочка, которая ловит всё, что падает.

Три этажа одного «мозга»

По сути любой мой запрос может уехать в одно из трёх мест, и у каждого — свои законы.

Облако. Внешние API-провайдеры, где ты платишь за токены. Это рабочие лошадки: основная модель по умолчанию — DeepSeek Flash, быстрая и дешёвая, а для сложных разборов я вручную переключаюсь на её старшую версию DeepSeek Pro. Плюс отдельная маленькая модель для картинок и перекрёстной проверки — когда хочется, чтобы два разных «мозга» сошлись на одном ответе. Плюсы: скорость, умение работать с инструментами, не нужно своё железо. Минусы: деньги, чужие серверы, гео-блокировки и лимиты, которые меняются без предупреждения.

Локальный Ollama. Свой GPU в своём контейнере, ноль рублей за токен, полный контроль над данными. Тут живёт gemma3:12b — основная локальная модель для субагентов. Текст не покидает домашнюю сеть, никто не считает твои запросы. Но у неё есть характер, о котором ниже, и он может сильно разочаровать.

Fallback-цепочка. Клей между первым и вторым. Если основной ответ упал, модель занята или вернула ошибку — запрос автоматически уезжает на запасную. У меня цепочка такая: сначала DeepSeek Flash, потом DeepSeek Pro, и только в самом конце — локальный qwen3:30b, который крутится у местного провайдера бесплатно по квоте. Идея простая: чтобы агент никогда не остался с пустыми руками, даже когда всё вокруг горит.

Живые цифры из наших замеров

Замеры честные, на своём железе, без маркетинга. Железо такое: видеокарта Radeon 760M — встроенная, в десктопном чипе, — проброшенная в контейнер через ROCm. Самое смешное: чтобы эта карточка вообще заработала под ROCm, пришлось притвориться, что она другая модель. Переменная HSAOVERRIDEGFX_VERSION=11.0.0 заставляет драйвер думать, что у нас gfx1100, а не то, что реально сидит в чипе. Без этого хака инференс падает на CPU, то есть в разы медленнее.

Итак, цифры:

  • gemma3:12b — 8 ГБ VRAM, 14.8 токена в секунду, контекст до 128 тысяч токенов. Основная локальная рабочая лошадка.
  • gemma3:4b — 23.5 токена в секунду, контекст скромнее (32 тысячи). Запасная, быстрая, но простоватая.
  • 8B-модели (hermes3, llama3.1) — я честно пытался использовать их в агентском режиме. Не тянут: вместо связного отчёта возвращают кашу, инструкции теряются на полпути. Удалены с диска без сожалений.

Для сравнения: облачная Flash отвечает практически мгновенно и умеет в инструменты; Pro — заметно умнее, но дороже и медленнее. Плата за удобство — деньги и то, что текст уходит на чужие серверы. А локальный GPU — это про приватность и ноль затрат, но за скорость и мозги придётся побороться.

Где зарыты грабли

Тут начинается самое интересное, потому что половина «очевидных» решений не работает ровно так, как ожидаешь.

Грабля первая: локальная модель не умеет в инструменты. gemma3 в связке с ollama версии 0.32.5 отвечает «does not support tools». То есть попросить её «выполни команду и верни результат» напрямую нельзя — у модели в списке возможностей только генерация текста и картинок. Сначала я этого не заметил: субагенты вроде работали. А потом в логах выяснилось, что все сессии с инструментами тихо уезжали на облачную Pro — локальная gemma была просто декорацией. Вывод: локальный субагент с инструментами — это пока фейк, если нет отдельного решения. Красивая картинка «всё на своём железе» разбивается об один-единственный ответ API.

Грабля вторая: бесплатное облако кусается. У одного крупного агрегатора есть целый пул бесплатных моделей. Звучит как сказка: большие контексты, много параметров, цена ноль. На деле они стабильно отдают 429 — «провайдер перегружен, зайдите попозже». Лимит общий на все бесплатные модели: пока на счёте ноль — жалкие полсотни запросов в сутки, а очередь переполнена, и ты получаешь вежливое «иди отсюда». Для рутины — сойдёт, для чего-то важного — нет. Бесплатное — значит, в очереди за всеми платными.

Грабля третья: география. OpenAI и тот же агрегатор из России отвечают 403. Просто так, по IP. Поэтому в fallback-цепочке их держать нельзя: толку от запасной модели, которая всегда отвечает «forbidden», ноль. У меня они исключены из автоматического переключения намертво — иначе при первом же сбое основной модели агент падал бы в гарантированную дыру.

Грабля четвёртая: ROCm-хак капризный. Да, 12B-модель на встроенной карточке крутится. Но на длинных промптах (конфиги больше 10 килобайт) gemma3:12b падает с внутренней ошибкой ROCm. Короткие запросы работают, длинные — бабах. Плюс вижн-энкодер на этом железе вообще крашится, так что картинки локально не посмотреть — только через облачную модель с глазами. Жить можно, но это запасной аэродром, а не основной.

Вывод

Секрет не в том, чтобы найти «одну идеальную модель». Её нет. Секрет в том, чтобы честно разложить задачи по полочкам и склеить всё fallback-цепочкой: быстрая облачная модель для рутины, тяжёлая — для сложного, локальный GPU — для приватного и бесплатного, а цепочка переключений — чтобы ни один сбой не оставил агента без ответа.

И два урока, которые я вынес на своих граблях. Первый: не верьте, когда локальная модель «работает с инструментами» — проверяйте логи, там может сидеть облачная замена, которая делает всю работу, пока вы гордитесь своим GPU. Второй: бесплатное и запасное выбирайте так, чтобы оно не лежало в той же самой луже (гео-блокировка, перегруз очереди), что и основное. Иначе ваша «отказоустойчивость» — это два туза одной масти.

Теги: #llm #selfhosting #ollama #openclaw