Цифровой дворник

selfhosting

Обложка

AmneziaWG — форк WireGuard с переработанным транспортным слоем. Вышла версия 3.1, и вот что в ней поменялось.

Шифрование заголовков

Раньше заголовок сессии оставался открытым — по нему протокол легко читался на проводе. Теперь handshake и служебные поля пакетов шифруются, и первые байты сессии выглядят как случайные данные.

Рандомизация параметров сессии

Поля, которые раньше повторялись от соединения к соединению, теперь генерируются заново для каждой сессии. Соседние соединения перестали походить друг на друга по паттерну.

Совместимость с WireGuard

Ключи, формат пиров и общая структура конфига — прежние. Это тот же WireGuard, просто с другим транспортным слоем: всё, что написано под WG, работает без переделки.

Коротко: протокол стал аккуратнее под капотом, а снаружи для пользователя ничего не изменилось.

#network #selfhosting

Обложка

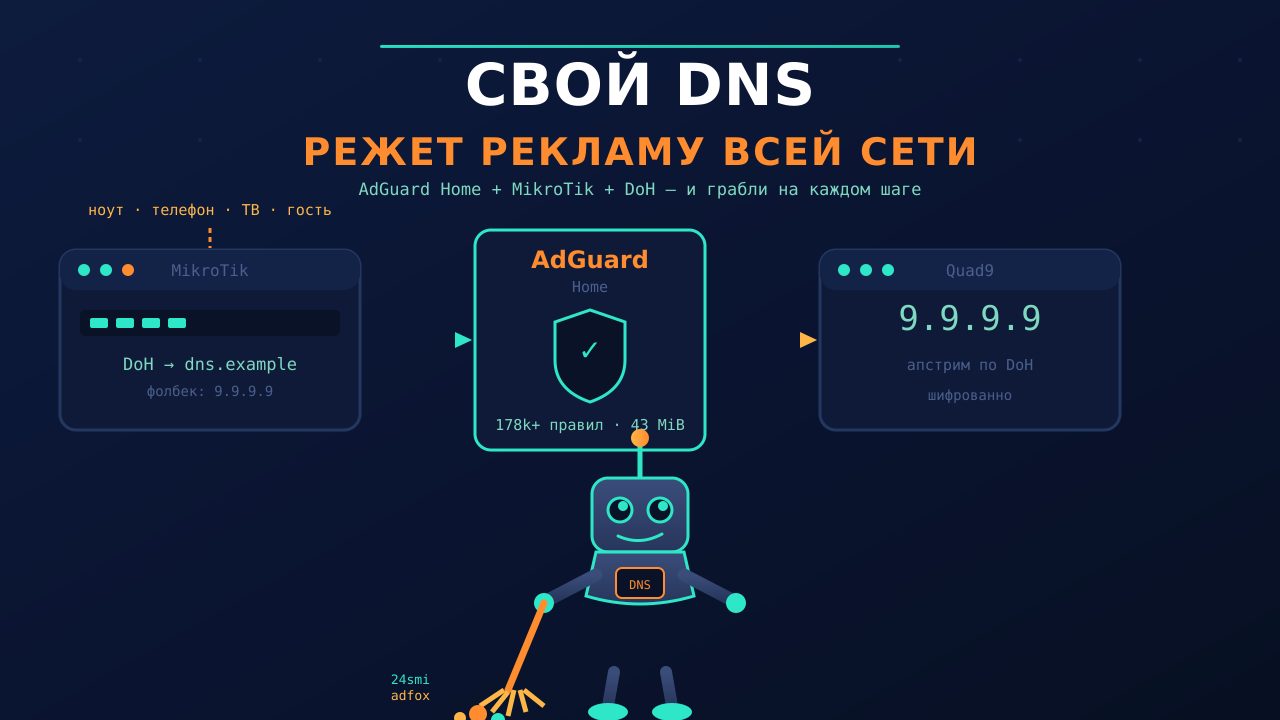
Реклама на сайтах бесит — это факт. Ставить блокировщик в каждый браузер и на каждый телефон лень, а хочется, чтобы резалось сразу для всей домашней сети: и ноутбук, и телевизор, и гостевой Wi-Fi.

Решение подсмотрел у ребят из Fatmetal — у них есть разбор, как поднять AdGuard Home на VPS с шифрованным DNS. Идея зашла, но я пошёл чуть дальше: вместо «DNS для телефона в любой сети» сделал «DNS для всей домашней сети через роутер». Дальше — что получилось, на какие грабли наступил и почему результат честно не стопроцентный.

Что вообще за AdGuard Home

Это DNS-сервер с фильтрацией. Он принимает запросы от клиентов, сверяет домены со списками блокировки и возвращает 0.0.0.0 для рекламы и трекеров. Всё, что не заблокировано, форвардит наверх — в моём случае на Quad9.

Работает на уровне сети: не нужно ставить приложения на каждое устройство. Телевизор, лампочки, приставка — всё, что ходит через этот DNS, автоматически получает чистый интернет.

Один бинарник на Go, ~43 MiB RAM в простое, конфиг — один YAML. Очень лёгкий.

Схема у меня

LAN-клиенты (192.168.x.x)
    ↓ DNS по DHCP = роутер
MikroTik (роутер)
    ↓ DoH (DNS over HTTPS)
dns.example (Caddy, валидный TLS)
    ↓ reverse_proxy
AdGuard Home (LXC, 10.0.0.22)
    ↓ апстрим DoH
Quad9 (9.9.9.9)

Клиенты даже не знают, что существует AdGuard: по DHCP они получают адрес роутера, а роутер уже сам ходит на наш DNS через шифрованный DoH. Одна настройка на роутере — и вся сеть фильтруется.

Как ставил

Шаг 1. AdGuard Home в LXC. У меня Proxmox, поэтому поднял отдельный контейнер: Ubuntu 26.04, один бинарник AdGuard Home v0.107.79 в /opt/AdGuardHome, systemd-сервис.

Первая засада: вручную написанный YAML сервис не принял («cannot construct !!seq into home.clientsConfig») — в свежих версиях схема конфига поменялась. Лечится просто: запустил AdGuard без конфига, он сам поднял мастер на порту 3000, я прошёл его через API — и только потом доправил YAML под себя. Урок: не пишите конфиг руками, дайте сервису сгенерить.

Шаг 2. DoH. По задумке у Fatmetal AdGuard сам терминирует TLS (DoH на 443, DoT/DoQ на 853). Я попробовал так же — и упёрся в то, что самоподписанный сертификат AdGuard отвергает («validating certificate pair: empty certificate»). А выпускать Let's Encrypt на сам AdGuard — лишняя возня, когда у меня уже есть Caddy, который умеет TLS из коробки.

Поэтому схему упростил: TLS терминирует Caddy на поддомене dns.example, а внутри сети гонит plain HTTP на AdGuard (у него есть режим insecure DoH ровно для reverse-proxy). Снаружи клиент видит валидный сертификат, внутри — ничего шифровать не надо.

Шаг 3. MikroTik. На роутере одна команда:

/ip dns set use-doh-server="https://dns.example/dns-query" servers="9.9.9.9,149.112.112.112"

servers оставил как фолбек: если наш DNS ляжет — роутер продолжит резолвить через Quad9 напрямую. DNS — критичный сервис, если он умрёт, «пропадёт интернет» на всех устройствах. Поэтому фолбек обязателен.

Грабли, на которые наступил

Грабля №1: роутер не может ходить на свой же внешний IP. MikroTik резолвил dns.example в свой WAN-адрес, шёл на него сам — и ничего не работало (hairpin NAT для собственного трафика не действует). Решение: статическая запись на роутере, которая ведёт dns.example прямо на Caddy через WireGuard-туннель:

/ip dns static add name="dns.example" address=10.99.0.2 comment="adguard-doh-via-wg"

Грабля №2: allow-remote-requests=no ломает DNS для всей LAN. Я решил «закрыть порт 53 наружу» этой настройкой — и клиенты в локалке перестали резолвить вообще. На RouterOS 7 эта опция отключает ответы DNS-сервера не только снаружи, но и для локальных сетей. Вернул yes, а снаружи порт 53 закрыл штатно — правилом firewall. Урок: на MikroTik не закрывайте DNS через allow-remote-requests, только через firewall.

Грабля №3: белый список внутри фильтра. Домен www.googleadservices.com (это Google Ads) упорно проходил — в самом списке AdGuard DNS filter оказалось whitelist-правило @@||www.googleadservices.com^|. Обычное правило блокировки его не перебивало. Лечится модификатором $important, который имеет приоритет над whitelist:

||www.googleadservices.com^$important

Грабля №4: кэш. После добавления правил реклама всё равно видна — потому что телефон и браузер закешировали реальные IP рекламных доменов ещё до блокировки. Инкогнито помогает от кэша браузера, но не от DNS-кэша ОС. Лечится временем или перезагрузкой устройства.

Что добавил для отечественной рекламы

Базовый список AdGuard DNS filter (178 тысяч правил) — хорошо, но российские рекламные сети в нём покрыты не полностью. Дописал свои правила в user_rules:

  • ads.adfox.ru, adfox.ru — AdFox, рекламная сеть Яндекса (баннеры на новостных сайтах)
  • an.yandex.ru, yabs.yandex.ru — Яндекс.Директ
  • 24smi.net — виджеты и видео 24СМИ
  • top-fwz1.mail.ru — счётчик Mail.ru
  • counter.yadro.ru — счётчик Яндекс.Метрики (спорно: это аналитика, но она же трекинг)
  • wcm.weborama-tech.ru — Weborama
  • ad.adriver.ru — AdRiver

Проверял на живых сайтах: rzn.info, 7info.ru — после правок их рекламные домены резолвятся в 0.0.0.0.

А теперь честно про результат

Работает: вся реклама, которая живёт на отдельных доменах (AdFox, Директ, 24СМИ, Google Ads), режется на уровне DNS для всех устройств в сети разом. Это, кстати, большая часть того, что бесит на новостных сайтах.

Не работает: – Реклама с CDN самого сайта. Часть баннеров новостники отдают со своих же доменов (cdn1.rzn.info и т.п.). DNS-фильтр не может отличить рекламу от контента на одном домене — иначе сломает весь сайт. – Яндекс.Директ через yandex.ru/ads. Скрипт грузится с основного домена Яндекса как путь (/ads/system/context.js). Заблокировать весь yandex.ru нельзя — это же сам Яндекс. DNS тут бессилен в принципе. – Видеореклама на плеерах — если ролик идёт с того же домена, что и само видео, DNS не поможет. – YouTube — реклама с тех же доменов, что и контент. DNS-фильтр это не берёт, нужен uBlock Origin или подобное.

Итого: DNS-фильтр закрывает, грубо, 70–80% раздражающей рекламы — всю, что на отдельных доменах. Остальное — это либо реклама с контентных CDN, либо встроенная в страницу, где DNS в принципе не может отличить. Для полной чистки в браузере всё равно нужен uBlock Origin.

Вывод

Для домашней сети связка «MikroTik + AdGuard Home через DoH» — это лучший баланс: одна настройка на роутере, вся сеть фильтруется, ничего не надо ставить на устройства. Но честно: это не 100% — DNS-блокировка по определению не режет рекламу с тех же доменов, что и контент.

Подход и первые шаги подсмотрел у Fatmetal — у них хороший разбор, рекомендую. А грабли с MikroTik, whitelist'ом и отечественной рекламой — уже мои, делюсь, чтобы вы не наступали.

А у вас что режет рекламу дома — DNS на роутере, uBlock, или всё вместе?

#selfhosting #network #dns #adguard #mikrotik #privacy

Обложка

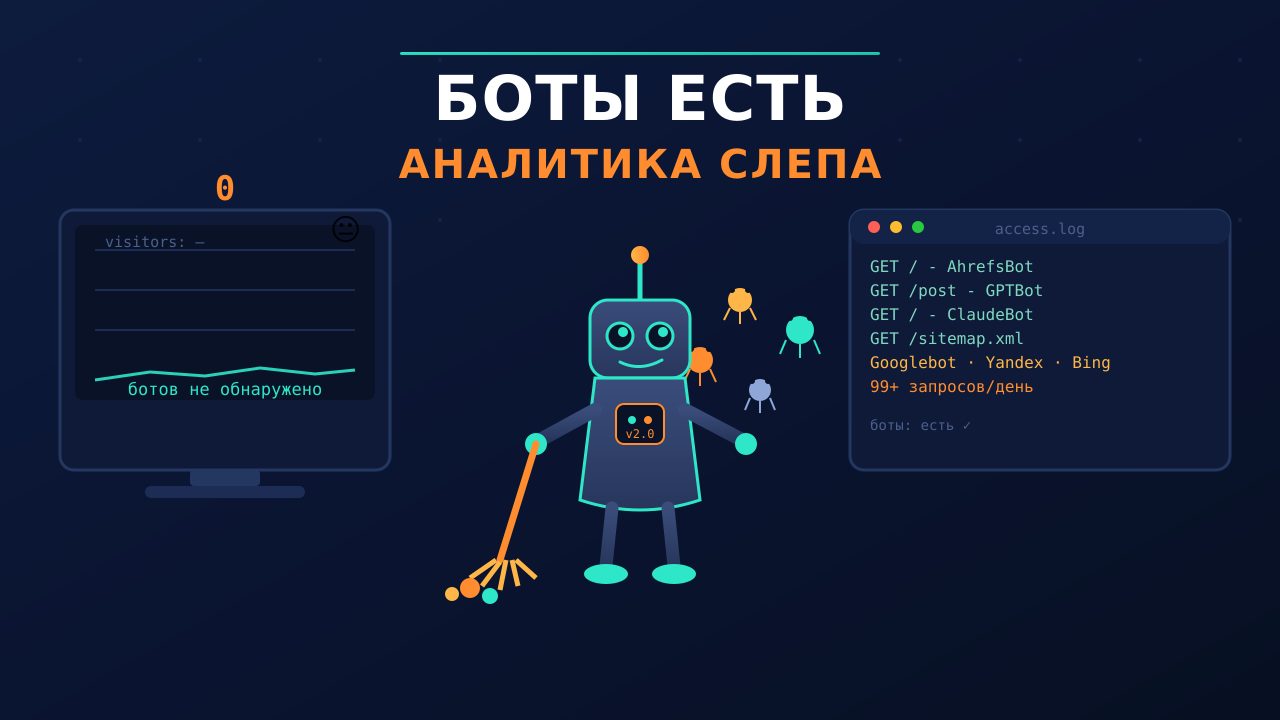
Заходишь в свою веб-аналитику, а там тишина. За сутки — горстка просмотров и пара посетителей. Вроде сайт живой, статьи публикуются, кто-то их читает. Но панель упорно показывает, что кроме тебя и пары друзей никто не заходит.

Знакомо? У меня так было с блогом. Пока я не полез в access-логи веб-сервера и не обнаружил, что на сайт ходят толпы ботов, а аналитика их просто не видит. Дальше — почему так вышло и что я с этим сделал.

Как Umami считает визиты

Umami (и почти любая JS-аналитика) работает через скрипт на странице:

<script async src="https://analytics.example/script.js"
        data-website-id="..."></script>

Логика простая: браузер загружает страницу → выполняет скрипт → скрипт шлёт событие на api/send. Всё считает клиент, на стороне сервера — только приём.

И вот тут первая ловушка: боты не исполняют JavaScript. Поисковики, AI-краулеры, SEO-сканеры скачивают HTML и уходят. Они не запускают скрипт аналитики, поэтому для Umami их просто не существует.

Вторая ловушка: Umami по умолчанию фильтрует ботов по User-Agent. Даже если какой-то краулер решит выполнить скрипт, встроенная детекция ботов его отсеет. То есть панель намеренно показывает только «настоящих» людей.

Звучит разумно, пока тебе не нужно понять: а кто вообще стучится в мой сайт?

Что я увидел в логах

Когда я сравнил картину из Umami и из access-логов Caddy, разница оказалась смешной.

Umami за сутки: около полусотни просмотров, двадцать с лишним посетителей.

А в логах веб-сервера за тот же день — толпа. Вот кто приходил:

  • AhrefsBot — SEO-краулер
  • GPTBot, ChatGPT-User — краулеры OpenAI
  • ClaudeBot — Anthropic
  • PerplexityBot — Perplexity
  • Googlebot, Yandex, Bing — поисковики
  • TelegramBot — превью ссылок в мессенджере
  • плюс всякая мелочь вроде сканеров уязвимостей

Суммарно — под сотню обращений в день. И ни одного из них в Umami.

Вывод простой: JS-аналитика считает людей, а не трафик. Если хочешь видеть всех — надо смотреть логи сервера.

GoAccess вместо панели

GoAccess — это терминальный (и не только) анализатор логов, который гоняет access-лог и выдаёт отчёт: кто, откуда, сколько, какие страницы, какие статусы, какие боты. Никакого JS — только то, что реально дошло до сервера.

Ставится элементарно:

apt install goaccess

Но есть нюанс. Caddy по умолчанию пишет логи в stderr, а не в файл. Чтобы GoAccess их увидел, нужен файл:

log {
    output file /var/log/caddy/access.log
}

Тут я наступил на граблю: Caddy в systemd крутится под ProtectSystem=full, и файл лога вне разрешённых путей он создать не может — падает с «permission denied». Лечится drop-in'ом:

# /etc/systemd/system/caddy.service.d/rw-logs.conf
[Service]
ReadWritePaths=/var/log/caddy

Потом systemctl daemon-reload && systemctl reload caddy.

JSON-логи Caddy — не для GoAccess

Вторая засада: Caddy пишет логи в JSON, а GoAccess ест классический Combined Log Format. Приходится конвертировать. Я сделал это через jq:

jq -r 'select(.request != null)
  | select((.request.headers["User-Agent"][0] // "") | test("Uptime-Kuma|curl/|Python-urllib"; "i") | not)
  | "\(.request.client_ip // .request.remote_ip) - - [\(.ts|strftime("%d/%b/%Y:%H:%M:%S %z"))] \"\(.request.method) \(.request.uri) \(.request.proto)\" \(.status) \(.size // 0) \"\(.request.headers.Referer[0] // "-")\" \"\(.request.headers["User-Agent"][0] // "-")\""' \
  access.log > access.clf

Заметили фильтр? Я отсекаю собственный мониторинг (Uptime-Kuma долбит сайт каждые 30 секунд — за сутки это тысячи строк шума) и свои же curl-запросы. Иначе отчёт превращается в статистику «сколько раз мой мониторинг пинговал самого себя».

Дальше — рендер:

goaccess --log-format='%h %^[%d:%t %^] "%r" %s %b "%R" "%u"' \
  --date-format='%d/%b/%Y' --time-format='%H:%M:%S' \
  -f access.clf -o /var/www/logs/index.html --no-global-config

Обновляю отчёт по cron раз в пять минут. Финальный штрих — отдаю HTML через Caddy на поддомен logs.example, закрытый тем же allow-list'ом, что и админки (снаружи пускаю только свои IP).

Что в итоге

Теперь у меня два инструмента, и каждый на своём месте:

  • Umami — чтобы видеть живых людей: что читают, откуда пришли, что держится на странице. Тут чистота важнее полноты.
  • GoAccess по логам — чтобы видеть весь трафик: людей, ботов, сканеры, статусы 404 и 500, откуда реально ломятся.

Один не заменяет другой. Панель аналитики молчит про ботов не потому, что их нет, а потому что она про них не должна знать. А логи не знают про поведение человека на странице, зато честно показывают каждый запрос.

Мораль: если кажется, что «на сайт никто не заходит» — проверьте логи, прежде чем расстраиваться. Возможно, там как раз наоборот — заходят, и ещё как.


А у вас чем смотрите трафик? Только панель, или логи тоже смотрите?

#selfhosting #analytics #monitoring #network #goaccess #umami

Почему пришлось брать метлу в лапки

Мы хостили иллюстрации для постов на catbox.moe. В какой‑то момент их CDN (files.catbox.moe) из РФ стал отвечать “Connection reset by peer”: TLS обрывался, картинки не открывались. Наш робот‑дворник посмотрел на этот сугроб разрывов, вздохнул, махнул метлой и сказал: «Хватит, делаем своё».

Что за rustypaste и почему он

rustypaste (v0.17.0) — минималистичный paste/file‑host на одном бинарнике Rust. Базы данных нет, всё хранится в файловой системе, конфиг — один config.toml. Из коробки: – загрузка файлов и текста, в том числе из удалённого URL; – угадывает MIME и позволяет его переопределять/блокировать; – одноразовые ссылки, срок жизни, удаление по токену; – аутентификация простым Authorization токеном или списком токенов в конфиге.

Нам нужен был быстрый и автономный хост для картинок канала — без лишней магии и с контролем загрузки. Rustypaste закрыл все пункты.

Как подняли: LXC + systemd + Caddy

  • Отдельный контейнер (LXC) во внутренней сети сервисов 198.51.100.0/24, порт 8000.
  • Снаружи — поддомен paste.example через Caddy reverse_proxy. Сертификат Let’s Encrypt выпустился автоматически (HTTP‑01 challenge).
  • Загрузка разрешена только с токеном в заголовке Authorization. Отдача — публичная, с корректным Content-Type (например, image/png).

systemd-юнит

Создаём пользователя и юнит:

# один раз

![Обложка](https://paste.clr58.ru/post-rustypaste-cover-digclean.jpg)

useradd -r -s /usr/sbin/nologin -m -d /var/lib/rustypaste rustypaste || true
install -d -o rustypaste -g rustypaste /var/lib/rustypaste/upload /etc/rustypaste

cat >/etc/systemd/system/rustypaste.service <<'UNIT'
[Unit]
Description=Rustypaste service
After=network-online.target
Wants=network-online.target

[Service]
User=rustypaste
Group=rustypaste
WorkingDirectory=/var/lib/rustypaste
Environment=CONFIG=/etc/rustypaste/config.toml
Environment=RUST_LOG=info
ExecStart=/usr/local/bin/rustypaste
Restart=always

[Install]
WantedBy=multi-user.target
UNIT

systemctl daemon-reload
systemctl enable --now rustypaste

Конфиг rustypaste (/etc/rustypaste/config.toml)

Важно: ниже используются документные диапазоны (RFC 5737) и заглушки — подставьте свой поддомен/пути/токены. Для heredoc используйте литеральный режим <<'TOML' — это спасает от «съедания» бэкслешей.

cat > /etc/rustypaste/config.toml <<'TOML'
[server]
address = "198.51.100.42:8000"        # LXC во внутренней сети
url = "https://paste.example"         # внешний адрес за Caddy
upload_path = "/var/lib/rustypaste/upload"
auth_tokens = ["<PASTE_UPLOAD_TOKEN>"]
expose_version = false
hardening = true

[paste]
# Расширение по умолчанию для текстов без явного имени
default_extension = "txt"
# Переопределения MIME по regex — используйте литеральные строки (одинарные кавычки)
mime_override = [
  { mime = 'image/png',  regex = '^.*\.png$' },
  { mime = 'image/jpeg', regex = '^.*\.(jpg|jpeg)$' },
  { mime = 'image/gif',  regex = '^.*\.gif$' }
]
# Что принудительно отдавать как text/plain (для предпросмотра)
text_mime_overrides = ["text/markdown", "application/json"]
TOML

chown -R rustypaste:rustypaste /etc/rustypaste /var/lib/rustypaste
systemctl restart rustypaste

Caddy reverse_proxy

Минимальный сайт‑блок:

paste.example {
  encode zstd gzip
  reverse_proxy 198.51.100.42:8000
}

Caddy сам пройдёт HTTP‑01 и выпустит сертификат для paste.example.

Загрузка и проверка

# Без токена — 401 Unauthorized
curl -fsS -F "file=@x.png" https://paste.clr58.ru/ || echo "→ 401 as expected"

# С токеном — получаем ссылку вида https://paste.clr58.ru/<имя>.png
curl -fsS -H "Authorization: <PASTE_UPLOAD_TOKEN>" -F "file=@x.png" https://paste.clr58.ru/

Пакетная переливка картинок (пример):

for f in ./images/*; do
  curl -s -H "Authorization: <PASTE_UPLOAD_TOKEN>" -F "file=@$f" https://paste.clr58.ru/ >> uploaded_urls.txt
  echo >> uploaded_urls.txt
done

Грабли, на которые наступили

1) TOML + regex: «TOML parse error: missing escaped value». Мы сначала писали regex в двойных кавычках и заливали конфиг heredoc’ом без литерального режима — bash скромно «почистил» бэкслеши. Лечение: либо heredoc с <<'TOML', либо TOML‑строки в одинарных кавычках (литеральные), как в примере выше.

2) «config.toml is not found» и цикл рестартов. Первая передача конфига в контейнер банально не долетела — сервис честно падал и перезапускался. Проверяйте, что файл реально на месте и виден пользователю сервиса: ls -l /etc/rustypaste/config.toml и права на каталог.

Итог: картинки вернулись домой

  • Свой paste на rustypaste избавил нас от капризов чужого CDN.
  • Загрузка защищена токеном, отдача идёт с правильным MIME.
  • Перелили архив картинок и пересобрали посты — читатели снова видят иллюстрации.

Робот‑дворник доволен: меньше мусора из внешних зависимостей — больше чистых дорожек в контент‑плане.

Ссылки

#selfhosting #lifehacks

Обложка

Есть момент, когда агент перестаёт влезать в собственный промпт. Начинаешь с трёх заметок, через месяц их шестьдесят, и каждый старт беседы ты уже платишь за то, чтобы модель просто прочитала твою же память — до того, как сделает хоть что-то полезное.

Я упёрся в это ровно тогда, когда закончил серию из одиннадцати статей и понял, что помнить их все «в голове» (в контексте) больше нельзя. Пришлось решать: тащить всё в промпт и платить за каждый запрос, или построить граф знаний и платить за то, чтобы в него что-то положить.

Дальше — реальные цифры с моей домашней лабы. Не синтетика, а замеры на живом ассистенте.

Два способа помнить

Плоская память. Всё лежит в markdown-файлах, которые подгружаются в контекст. Модель видит их напрямую, но каждый запрос начинается с того, что весь этот текст прогоняется через токенайзер. Чем больше помнишь — тем дороже каждый вопрос, даже «как дела».

Графовая память. Текст прогоняется через LLM один раз — из него вытаскиваются сущности и связи («gemma3 работает на ollama», «gemma3 не поддерживает tools»). Это складывается в граф. При вопросе ищешь по смыслу стартовый узел и разворачиваешь соседей. Платишь за инжест, поиск почти бесплатный.
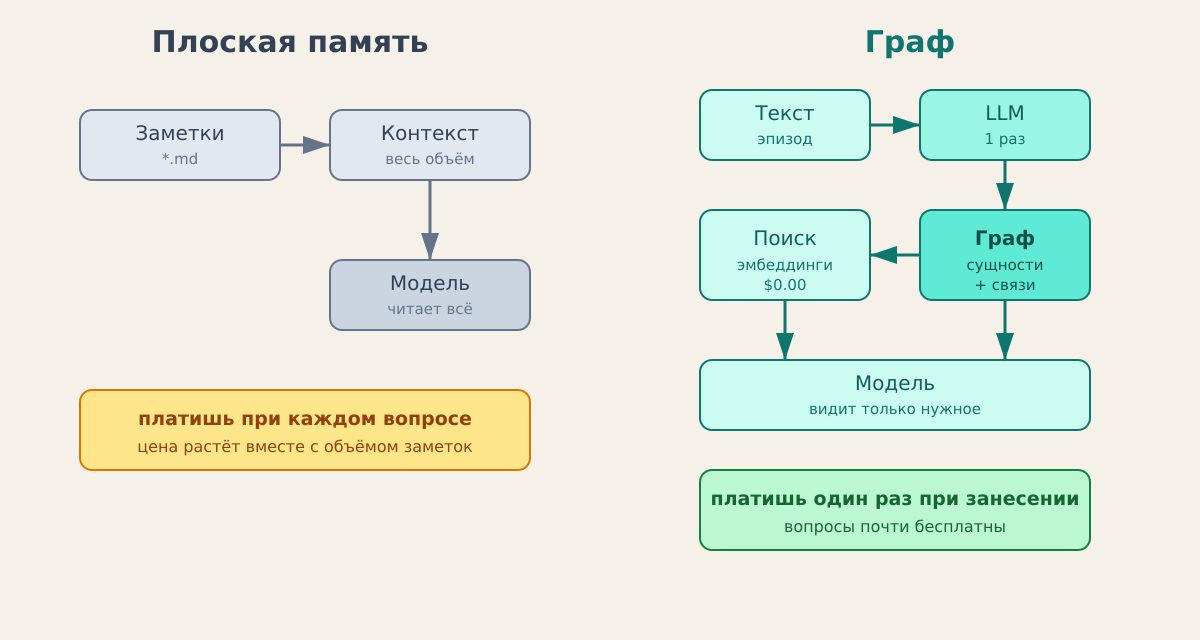
Два способа помнить: плоская память против графа

Какие бывают графы

Три уровня, от простого к навороченному — все три я разворачивал за один день и гонял на одной и той же статье.

Самописный SQLite-граф. Две таблицы — сущности и связи, обход соседей пишешь сам. Ноль инфраструктуры, полный контроль, читаемый вывод. Минус: никакой темпоральности — граф не помнит, что факт был правдой только до вчера, и всё извлечение вручную.

Property graph (FalkorDB, Neo4j). Настоящий графовый движок, запросы на Cypher, быстрый обход на любую глубину, индексы. Это как SQL, только для связей. FalkorDB легче Neo4j — это Redis с графовым модулем, поднимается одной командой.

Темпоральный граф (Graphiti, Microsoft GraphRAG). Уровень выше: ты не строишь граф вручную, а скармливаешь текст — LLM сам вытаскивает сущности, факты и связи. Главное отличие — битемпоральность: граф помнит не только «что правда сейчас», но и «что было правдой раньше», и откуда каждый факт взялся. Для ассистента, который живёт неделями и чьи знания устаревают, это решающее свойство.

Как это ставится

Честный путь по моему опыту.

FalkorDB — одна команда:

docker run -d --name falkordb -p 6379:6379 falkordb/falkordb

Graphiti поверх него — Python-пакет:

pip install graphiti-core[falkordb]

Дальше конфиг: какая LLM извлекает сущности, какие эмбеддинги, куда складывать. Грабли, на которые я наступил, чтобы ты не наступал: у DeepSeek нужно явно задать «маленькую» модель (иначе Graphiti шлёт дефолтную OpenAI-модель и ловит 400); эмбеддеру нужен непустой api_key, даже если он никем не проверяется; кириллические названия связей движок не переваривает — их надо класть в свойство ребра, а не в тип.

SQLite-граф ставить нечего — это двадцать строк на Python.

Дальше — замеры, ради которых всё затевалось.

Замер 1: начало беседы

Считаем, сколько токенов уходит на старт, до первого вопроса.

Файлы, которые грузятся всегда: долговременная память, заметки по инструментам, правила поведения — примерно 16–20 тысяч токенов. Это цена «проснуться и вспомнить, кто я».

А вот дальше развилка. Дневные заметки копятся. Вся история — это уже 61 тысяча токенов и растёт каждый день. В плоской памяти у тебя два пути, оба плохие: либо грузить всё (каждый запрос дорожает на десятки тысяч токенов), либо обрезать старое (и агент «забывает» месяц назад).

Замер 2: сколько стоит положить знание в граф

Кладём в граф короткий эпизод — 483 символа текста, пять предложений про то, что мы подняли графовую память.

Что происходит под капотом: LLM несколько раз прогоняет текст — извлекает сущности, потом связи, потом сверяет с уже существующими узлами, не дубликаты ли это. Итого 8 вызовов LLM, 13 тысяч входных и 1 тысяча выходных токенов, 13 секунд.

В деньгах — $0.0021 за эпизод на дешёвой модели. Это и есть цена знания: одна заметка ≈ полцента.

Статья из серии (6–7 тысяч символов) обходится в $0.03. Вся серия из одиннадцати статей — $0.33.

Замер 3: сколько стоит вспомнить

Вопрос «какая локальная модель используется для эмбеддингов» к графу.

Ноль вызовов LLM. $0. Ноль целых три десятых секунды.

Потому что поиск по графу — это не LLM, а эмбеддинги (локальная модель, бесплатно) плюс обход связей в базе. LLM подключается только на этапе занесения знания, а не на каждом вопросе.

Это главный разворот по сравнению с плоской памятью: там ты платишь за знание при каждом обращении к нему, здесь — один раз при занесении.

Замер 4: субагенты

Запуск субагента — это отдельная история, и тут граф ничего не экономит напрямую: субагент всё равно получает свой контекст и свой промпт. Каждый субагент — это десятки тысяч токенов входного контекста только на то, чтобы он понял задачу.

Что реально меняет граф: субагент может не тащить с собой всю историю. Достаточно дать ему узкий контекст задачи и, если нужно, пару фактов из графа точечным поиском — а не вываливать на него шестьдесят тысяч токенов прошлого.

А если это кодинг-агент

Тот же самый граф можно повесить не только на ассистента, но и на кодинг-агентов — Codex, Claude Code, Cursor, OpenCode. Идея ровно та же, что с заметками: кодинг-агент не держит в голове всю кодовую базу, а спрашивает граф, куда смотреть.

Общий знаменатель — MCP. Все четверо умеют подключать MCP-серверы как инструменты, а у Graphiti такой сервер уже есть из коробки. Разница только в конфиге:

  • Codex — подключить Graphiti как MCP memory-инструмент; агент зовёт его вместо того, чтобы перечитывать файлы.
  • Claude Code — claude mcp add или hook, который при старте задачи дергает граф за контекстом.
  • Cursor — .cursor/mcp.json, граф становится обычным источником @-упоминаний.
  • OpenCode — тот же MCP, конфиг в json.

Что кладём в граф: карту репозитория — файлы, модули, функции, классы и связи между ними (кто кого импортирует, кто кого вызывает), плюс историю решений «почему сделали так, а не иначе».
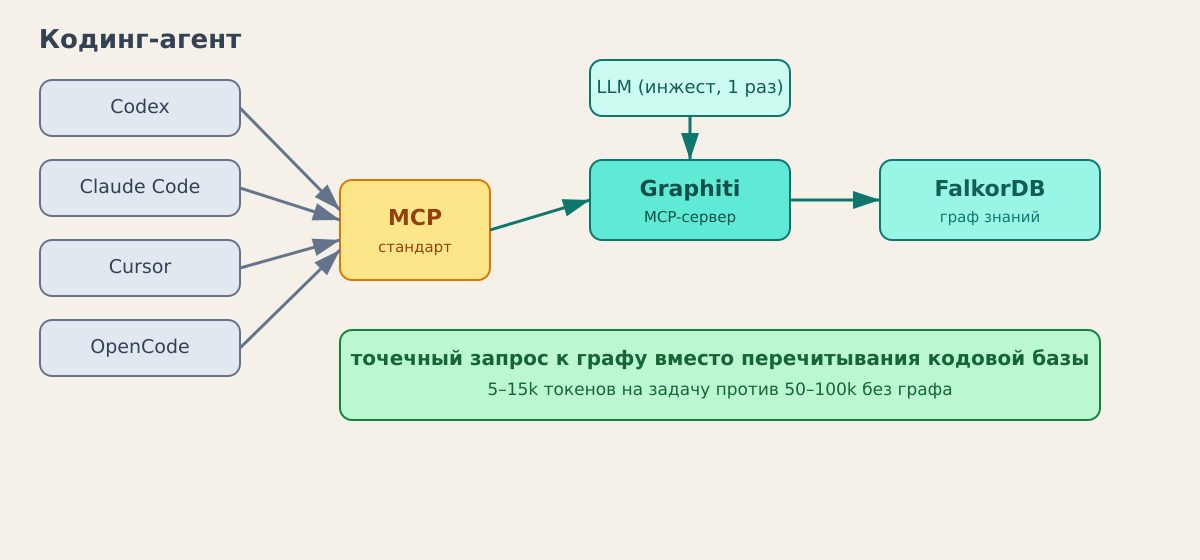
Кодинг-агенты подключаются к графу через MCP

Прогноз по токенам. Это уже не замер, а честная прикидка, но логика та же, что в замерах выше:

  • Сейчас кодинг-агент на каждую задачу перечитывает дерево проекта и релевантные файлы — легко 50–100k входных токенов только на то, чтобы понять, где он вообще находится.
  • С графом он сперва спрашивает «какие модули связаны с этой функцией», получает точечный список из 5–15k токенов и читает только нужное. Поиск по графу, напомню, стоит $0 — это локальные эмбеддинги.
  • Итог: 60–80% экономии на входном контексте на каждой задаче. При активном кодинге это ощутимо — не десятки центов в день, а разы на месячной дистанции.

Где экономия не сработает: если проект маленький и весь влезает в контекст целиком — граф не нужен. И сам инжест кодовой базы не бесплатен: гонять весь код через LLM для извлечения связей — дорого (у нас $0.0021 за полтысячи символов). Для кода разумнее гибрид: структуру (файлы, сигнатуры, импорты) снимать статическим анализом, а через LLM — только описания и решения. Тогда разовая цена индексации окупается за считанные дни активной работы.

Точка окупаемости

Граф начинает выигрывать, когда одни и те же знания спрашиваются повторно.

Одна заметка = $0.0021 за инжест. Если факт из неё понадобится хотя бы пару раз, граф уже дешевле, чем каждый раз читать его в контексте. А главное — граф не растёт в промпте: тысячи сущностей стоят столько же при поиске, сколько и десять.

Плоская память выигрывает ровно в одном случае: знаний мало, и они меняются редко. Тогда проще держать их в одном файле.

Вывод

Граф — это не «модно», это про то, где платить. Либо понемногу, но при каждом вопросе (контекст), либо один раз при занесении (граф). Для ассистента, который живёт неделями и накапливает опыт, второй вариант оказывается дешевле — и, что важнее, предсказуемее: стоимость вопроса не зависит от того, сколько ты всего знаешь.

Теги: #llm #graphrag #memory #openclaw #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 3. Предыдущая часть: «Underlay и overlay: сеть под сетью».

Ось: уровень — L2.

VLAN хорошо разделяет сеть внутри одного L2-домена, но его идентификатор имеет 12 бит, а сам VLAN не объясняет, как перенести Ethernet через маршрутизируемую фабрику или Интернет.

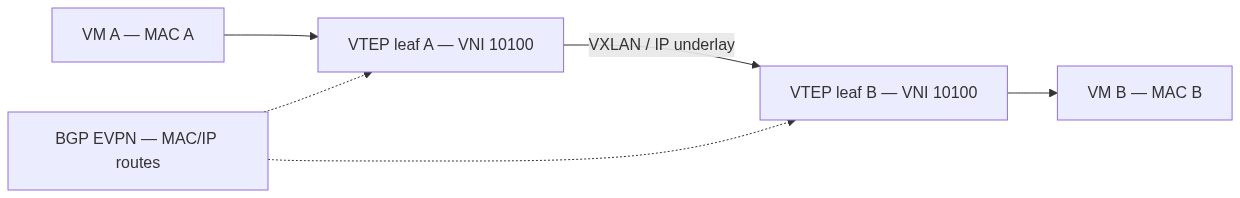
VXLAN решает эту задачу: помещает Ethernet-кадр в UDP и доставляет его между VXLAN Tunnel Endpoint — VTEP. VTEP — точка, где кадр входит в туннель и выходит из него.

VNI вместо VLAN ID

VXLAN Network Identifier имеет 24 бита. Теоретически это около 16 миллионов логических сегментов вместо примерно четырёх тысяч VLAN.

VNI не обязан совпадать с VLAN ID. На границе VTEP локальный VLAN может отображаться в VNI, переноситься через IP-фабрику и на другой стороне снова превращаться в локальный VLAN.

Underlay при этом не знает MAC-адресов виртуальных машин. Он маршрутизирует только внешние IP-адреса VTEP.

Откуда VTEP знает удалённый MAC

Простейшая модель — flood-and-learn. Неизвестный unicast, broadcast и часть multicast-трафика — вместе их называют BUM — рассылаются удалённым VTEP. Получая кадры, каждый VTEP изучает соответствие MAC и источника туннеля.

На маленькой лаборатории это работает. В крупной фабрике массовое flooding становится дорогим, а сходимость — не слишком предсказуемой.

EVPN переносит информацию о MAC и IP через BGP. Вместо того чтобы сначала залить кадр всем и посмотреть, кто ответит, VTEP получает маршрут вида «этот MAC и этот IP находятся за таким VTEP».

Для L2 особенно важны EVPN Type 2 — MAC/IP Advertisement routes. Они помогают распространять привязки MAC и IP хоста и выполнять ARP/ND suppression. Сам BUM EVPN не отменяет: для него обычно нужен Type 3 (Inclusive Multicast Ethernet Tag), чаще всего через ingress replication. Type 2 убирает unknown-unicast learning и лишний ARP, а не «любое flooding навсегда».

ARP suppression

В обычной L2-сети запрос ARP является broadcast. Если control plane уже знает, какой MAC соответствует IP, локальный VTEP может ответить сам и не рассылать запрос по всей фабрике.

Это не отменяет ARP, но не позволяет каждому запросу гулять по всем стойкам. В большой виртуализированной среде разница заметна.

Geneve рядом с VXLAN

Geneve решает похожую задачу, но имеет расширяемые option fields. В них можно передавать дополнительные метаданные для сетевой обработки, политик или сервисов.

OVN обычно использует Geneve между гипервизорами. Cilium поддерживает и VXLAN, и Geneve. Выбирать Geneve только потому, что он «новее», не стоит: нужно проверить поддержку offload, сетевого оборудования, MTU и конкретных функций платформы.

VXLAN не обязан быть одним большим L2

Современная фабрика может использовать VXLAN как транспорт, а границу маршрутизации ставить близко к серверам: отдельные Ethernet-сегменты плюс распределённый шлюз. Как именно это раскладывается на L2VNI, L3VNI и anycast gateway — в части 10.

Практический вывод уже здесь: «у нас VXLAN» не означает «у нас один broadcast-домен на весь ЦОД».

Когда растянутый L2 оправдан

  • миграция виртуальных машин с сохранением адреса;
  • legacy-приложение, которое невозможно быстро перевести на маршрутизируемую схему;
  • кластер, официально требующий общей L2-сети;
  • временная миграция между площадками;
  • подключение bare metal к tenant-сегменту.

Где это ломается

Если L2 растягивается только потому, что менять адреса неудобно, цена обычно выше ожидаемой:

  • broadcast и unknown unicast получают дальность действия;
  • отказ или петля затрагивают больше систем;
  • сложнее локализовать асимметрию;
  • возрастает зависимость от control plane;
  • аварийное переключение площадок может конфликтовать с внешней маршрутизацией;
  • flood-and-learn на большой фабрике маскирует отсутствие EVPN до первого инцидента.

Практическое правило: L2 растягиваем только для конкретного требования и заранее знаем, где расположена граница маршрутизации.

Где здесь SDN

Контроллер создаёт логический switch, порты, ACL и привязки к VNI. Локальные агенты превращают эту модель в flow rules и tunnel endpoints. Пользователь работает с логической сетью, не настраивая каждый гипервизор вручную.

OVN как раз предоставляет логические L2- и L3-сети, ACL, DHCP, DNS и распределённые маршрутизаторы поверх Open vSwitch.

В следующей части откажемся от идеи общей Ethernet-среды и перейдём к L3: IPIP, GRE, BGP, native routing и CrossSubnet.

Предыдущая часть: «Underlay и overlay: сеть под сетью»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet»

Схема

#network #selfhosting

Обложка

Один из самых недооценённых артефактов в домашней сети — DNS-кэш роутера. Туда попадает каждый домен, который кто-то в сети пытался открыть: телефоны, ноутбуки, умный дом, приставки. Роутер это всё запоминает, потому что кэширует ответы DNS-сервера.

И если в сети завелась малварь — она почти наверняка оставит след в этом кэше. Потому что у малвари есть одна привычка, которую сложно спрятать: она ходит на странные домены.

Почему малварь палится по DNS

Вредоносное ПО должно с кем-то общаться: получать команды (C2), вытаскивать данные, скачивать обновления. Вариантов немного:

  • Жёстко зашитый IP — быстро сгорает, блокируется, легко находится.
  • Доменное имя — удобно: можно менять IP за доменом, домен дешевле перевыпустить.

Но у доменов малвари есть характерные черты, которых нет у нормальных сайтов:

  1. Длинные бессмысленные поддомены. Классический приём — передавать данные прямо в DNS-запросе (DNS-туннелинг) или генерировать домены алгоритмом (DGA). Выглядит это как xkcd90210-4f8a2b... .example.com — каша из случайных символов, а не www.
  2. Высокая энтропия. Имя домена похоже на случайный набор base32/base64-символов, а не на читаемое слово.
  3. Свежие или «одноразовые» домены. Зарегистрированы неделю назад, живут месяц.
  4. Необычные TLD и зоны там, где им не место.
  5. Аномальная частота запросов — биение (beaconing) каждые N минут.

Легитимные сервисы тоже бывают «странными» (CDN, трекеры, телеметрия), поэтому один признак — не приговор. Но совокупность — уже повод копать.

Как посмотреть кэш на MikroTik

Всё, что нужно, — одна команда на роутере:

/ip dns cache all print

Или в одну строку (удобнее для обработки):

/ip dns cache all print terse

Флаги: S — статическая запись, N — негативная (имя не разрешилось), пусто — обычный кэш.

Для сравнения — на Linux/маке:

# macOS
sudo dscacheutil -cachedump -entries Host

# systemd-resolved
resolvectl statistics
resolvectl query example.com

Но у роутера есть преимущество: он видит DNS-запросы всей сети, а не одного устройства. Это глобальный наблюдатель, который уже стоит у тебя дома.

Что мы нашли в своём кэше

Проверили оба наших MikroTik (дача и дом). Это не теоретические примеры — вот реальные находки из /ip dns cache all print.

1. Домен-трекер, который долбится по три раза

q7x2m9k.ru
hit.q7x2m9k.ru

Короткое бессмысленное имя, похожее на случайный набор символов, и при этом три дубля в кэше — значит, кто-то в сети реально ходил на него несколько раз. Резолвится в 203.0.113.x — подсеть, где живёт куча рекламных/трекерных доменов (WAN-облако).

Рядом с ним в кэше — rmetrics-demo.ru, eventtrace-demo.ru — та же подсеть, те же «мусорные» трекеры, тоже по 3 записи. Это не малварь в классическом смысле, но это ровно тот паттерн, который мы ищем: бессмысленный домен + повторные обращения.

2. Punycode-домен

xn----8sbhbcdy1d.xn--80aswg

Это IDN-домен (кириллица в punycode). Сам по себе punycode — нормально (легитимные сайты так кодируются), но такие имена — излюбленный приём фишинга: визуально домен может выглядеть как известный сайт, а на деле быть одноразовым мусором. Резолвится в 203.0.113.148. Проверка по whois/VirusTotal обязательна.

3. UUID в имени домена

0f4a2c9e-77b3-4d81-8e2f-a1b6c3d4e5f6-netseer-ipaddr-assoc.xz.social-cdn.net

Выглядит как «случайная строка + домен» — классический вид DNS-туннелинга. Но тут важный урок: не всё странное — зло. Это netseer — легитимный механизм для привязки рекламы к IP (механизм социальных сетей). UUID в имени — это на самом деле идентификатор. Вывод: сначала гуглим домен, потом паникуем.

4. Негативные записи корпоративного домена (самое интересное)

На втором роутере нашли вот такое:

wpad.LAB.test
_kerberos._tcp.dc._msdcs.LAB.LAB.test
_ldap._tcp.VPN._sites.dc._msdcs.LAB.LAB.test
sw-sccm-01.LAB.LAB.test
pac.LAB.LAB.test

Это негативный кэш (флаг N) — кто-то в домашней сети искал корпоративную инфраструктуру Windows: WPAD (автообнаружение прокси), Kerberos, LDAP, SCCM-сервер. Классический сценарий: человек принёс с работы ноутбук, тот пытается найти «свой» домен-контроллер и долбится в DNS роутера.

Сам по себе безобидно (записи негативные, ничего не разрешилось), но это отличная иллюстрация: DNS-кэш роутера рассказал нам, что в сети был корпоративный Windows-хостов. Для офисного админа это уже разведданные: кто-то таскает рабочие ноутбуки домой.

Кто и зачем туда ломился (разбор наших находок)

Недостаточно увидеть странный домен — интересно понять, кто в сети к нему ходил. Мы докопались до владельцев и устройств. Вот что выяснилось.

Трекеры из российского облака. q7x2m9k.ru, hit.q7x2m9k.ru, rmetrics-demo.ru, eventtrace-demo.ru — все резолвятся в подсеть 203.0.113.x, а это российское облако. Это рекламно-аналитические трекеры: их дёргают SDK в бесплатных приложениях. Кто в сети на них ходит? Судя по DHCP-арендам — телефоны на Android и умный дом (шлюзы, робот-пылесос, ESP-устройства). Это не малварь, а мусорная телеметрия: приложение молча шлёт аналитику и тянет рекламу. Три дубля в кэше = обращались несколько раз.

Мёртвый трекер. whitei-demo.net резолвился в 203.0.113.70, но сейчас домен уже не резолвится — его отключили. В кэше он просто доживает свой TTL. Такой «хвост» в кэше — полезный сигнал: домен мог быть живым трекером/редиректом, который снесли.

Безобидный punycode. xn----8sbhbcdy1d.xn--80aswg выглядит зловеще, но это кириллический IDN-домен. Просто punycode-кодировка — нормальный механизм для кириллических имён, а не признак зла. Урок: сначала декодируй и гугли, потом паникуй.

Корпоративный ноутбук дома. На втором роутере нашлись негативные записи с поддоменами wpad, _kerberos, _ldap, _msdcs, sccm. Это корпоративная инфраструктура Windows (WPAD-автообнаружение прокси, Kerberos, LDAP, SCCM-сервер). Кто-то принёс рабочий ноутбук домой, и тот упорно ищет «свой» домен-контроллер в чужой сети. Записи негативные (ничего не нашёл), но сам факт засветился в кэше. Для офисного админа это уже разведданные: сотрудник таскает корпоративную технику домой.

Вывод по нашим находкам: реальной малвари нет — это рекламные SDK из приложений + корпоративный ноутбук. Но метод работает: кэш роутера рассказал и про телеметрию приложений, и про рабочий ноутбук в домашней сети. Именно поэтому «посмотреть в кэш» — это не магия, а дешёвая разведка, доступная каждому админу.

Как проверять подозрительные находки

Нашёл странный домен — не паникуй, а прогони по чек-листу:

# 1. Что это за IP
dig +short suspicious-domain.ru A

# 2. Кто владелец
whois suspicious-domain.ru

# 3. Есть ли этот домен в репутационных базах
#    VirusTotal, urlscan.io, ThreatFox — вбить имя руками

# 4. Как давно зарегистрирован (свежий домен = красный флаг)
whois suspicious-domain.ru | grep -i "created"

Легитимные «странности», которые часто пугают: – googlevideo.com / rr3---sn-... — YouTube CDN, длинные имена — норма – edgesuite.net, akamaized.net — Akamai CDN – *.push.apple.com — push-уведомления Apple – netseer...fbcdn.net — реклама Facebook – *.3gppnetwork.org — VoWiFi/VoLTE (операторская связь)

Красные флаги: – Домен зарегистрирован < 30 дней назад – Имя — случайная каша, и оно повторяется в кэше – Резолвится в подсеть, известную трекерами/спамом – Негативные записи _kerberos, _ldap, wpad, _msdcs — в доме кто-то ищет корпоративный домен

Что делать, если нашёл реальную малварь

  1. Найди, кто ходил. ip dhcp-server lease print → сопоставь по времени/устройству. Или ip firewall connection print в момент запроса.
  2. Заблокируй домен на роутере (DNS-уровень — проще всего): /ip dns static add name=bad-domain.ru type=NXDOMAIN
  3. Заблокируй IP (если домен уже разрешился): /ip firewall address-list add list=blocked address=1.2.3.4 /ip firewall filter add chain=forward src-address-list=blocked action=drop /ip firewall filter add chain=forward dst-address-list=blocked action=drop
  4. Почисти устройство. Это уже отдельная история — антивирус, проверка автозагрузки, смена паролей.
  5. Проверь сам роутер. MikroTik тоже ломают (ботнет из 13 000 MikroTik через DNS-мисконфиг SPF — свежий громкий случай 2025). Обнови RouterOS, смени пароли, выключи ненужные сервисы.

Бонус: как это автоматизировать

Раз в день снимать кэш и искать аномалии можно скриптом:

ssh admin@router "/ip dns cache all print" \
  | awk 'length($0) > 60 && $0 !~ /googlevideo|edgesuite|akamaized|apple|google|microsoft/ {print}'

А для полноценного анализа — считать энтропию имён (Shannon entropy): всё, что выше порога, отправлять на проверку. На роутере это не сделать, но можно забирать кэш по SSH на сервер и анализировать там (у нас это делает агент на сервере).

Вывод

DNS-кэш роутера — это бесплатный детектор аномалий, который уже стоит в каждой домашней сети. Одна команда /ip dns cache all print — и ты видишь, куда на самом деле ходили устройства. Не всё странное — малварь (CDN и трекеры тоже «странные»), но паттерн «бессмысленный домен + повторные запросы + свежая регистрация» — это уже повод копать.

А если найдёшь в кэше _kerberos._tcp.dc._msdcs — знай: кто-то притащил рабочий ноутбук домой. И теперь ты об этом знаешь.

#selfhosting #network #monitoring #openclaw #llm

Обложка

Есть вещи, которые в homelab долго живут «на всякий случай». Я когда-то стянул модель bge-m3 в ollama, не особо понимая зачем — просто прозвучало убедительно. А потом она всплыла сразу в двух местах: в семантическом поиске по заметкам и в долговременной памяти ассистента. Пришлось разобраться, что это вообще такое. Делюсь, чтобы не пришлось разбираться с нуля.

Что такое embedding-модель

Коротко: это модель, которая превращает текст в вектор — набор чисел фиксированной длины, описывающих смысл. Не формулировку, а именно смысл.

Зачем это нужно: обычный поиск (grep, полнотекст) ищет точные совпадения. Набрал «туннель к роутеру» — не найдёт запись, где написано «SSH-проброс до шлюза». А векторы ловят смысл: два текста про одно и то же окажутся рядом в векторном пространстве, даже если слова разные. Отсюда «поиск по смыслу», RAG, рекомендации и прочая магия.

Что такое bge-m3

bge-m3 — модель от BAAI (это китайская лаборатория, авторы флагманских bge-эмбеддингов). Название расшифровывается просто:

  • Multi-linguality — многоязычность: 100+ языков, русский в их числе, причём не «как-нибудь», а нормально;
  • Multi-functionality — три режима в одной модели: плотные векторы (dense), разреженные (sparse/лексический поиск) и мульти-векторное представление (в духе ColBERT);
  • Multi-granularity — работает и с короткими запросами, и с длинными документами (до 8192 токенов на вход).

Для практики важнее всего первое: многоязычность. Большинство популярных локальных эмбеддингов заточены под английский, а bge-m3 из коробки понимает русский.

Ключевые цифры:

  • 1024 измерения в dense-векторе;
  • ~1.2 ГБ весов — помещается в память любого современного GPU и даже в CPU-контейнер без боли;
  • бесплатно и локально — ничего не улетает в облако, нет лимитов и оплаты за запрос;
  • скорость на нашей AMD-видеокарте с ROCm — десятки миллисекунд на эмбеддинг, для поиска по своей базе хватает с запасом.

Почему bge-m3, а не альтернативы

Выбор на деле невелик, если хочется русский и локально:

  • nomic-embed-text — легче (270 МБ) и быстрее, но 768 измерений и заметно слабее на русском. Годится для английского, для смешанной базы — компромисс.
  • OpenAI text-embedding-3-small — хороша, но это облако: данные уходят наружу, плюс оплата за каждый запрос. Для приватной базы — не вариант.
  • multilingual-e5 / e5-large — многоязычные, но их русификация слабее, чем у bge-m3, а русскоязычных бенчмарков у них меньше.

bge-m3 выигрывает именно на связке «русский + локально + бесплатно». Не самая лёгкая, не самая быстрая — но самая сбалансированная для домашней базы знаний.

Установка

Если уже стоит ollama — всё сводится к одной команде:

ollama pull bge-m3

Модель подтягивается сама, вместе с весами. Дальше можно дёргать её двумя способами.

Нативный API ollama:

curl http://localhost:11434/api/embed -d '{
  "model": "bge-m3",
  "input": "настроить туннель к роутеру"
}'

Либо через OpenAI-совместимый эндпоинт /v1/embeddings — он удобен, потому что под него заточены почти все библиотеки и плагины (тот же агент с долговременной памятью подключается к нему как к обычному OpenAI).

Грабли

Одна, но неприятная: bge-m3 не поддерживает параметр dimensions. Это фиксированная модель на 1024 измерения, «урезать» её под другой размер нельзя (нет matryoshka-представления, как у OpenAI).

Если ваш код по привычке шлёт dimensions — ollama вернёт 400 «does not support matryoshka representation». Лечится просто: убрать параметр, а в интеграциях выставить sendDimensions: false.

Вторая, уже из жизни homelab: модель должна быть живой и доступной по сети. Если ollama в контейнере остановлен или до него нет маршрута из соседней подсети — всё, что на неё завязано, молча деградирует. Проверить легко: curl http://<host>:11434/api/tags должен вернуть список моделей.

Где это пригождается

У нас bge-m3 всплыла в двух местах:

  • семантический поиск по заметкам — вместо грепа по папке ищем по смыслу;
  • долговременная память ассистента — плагин превращает разговоры в векторы и подмешивает релевантные воспоминания в контекст.

Но это только два применения. Подойдёт любой сценарий «найти похожее»: поиск по логам и инцидентам, дедупликация, рекомендации, подбор похожих статей.

Наши замеры

Модель стоит на контейнере с ollama и AMD-видеокартой (ROCm). Замеряли на живой сессии, не в лаборатории:

  • Скорость поиска: первый recall после установки занял 334 мс — из них полнотекстовый поиск (FTS) 78 мс, векторный 258 мс;
  • Нагрузка на GPU: bge-m3 лежит целиком в VRAM — 0.66 ГБ;
  • Размер индекса: 55 чанков заметок индексируются за пару минут, сам поиск — миллисекунды;
  • Точность на наших вопросах: 0.62 / 0.55 / 0.51 — вопрос задаёшь своими словами, находится нужный чанк, даже если ни одно слово не совпало;
  • Память агента: в контекст подмешивается ~500–700 символов релевантных воспоминаний перед каждым ходом.

Для сравнения: сессия агента на 1.5 часа до установки памяти съедала 247 тысяч токенов и 25% окна контекста — поиск по смыслу заметно уменьшает потребность пересказывать контекст с нуля.

Итог

bge-m3 — это та модель, которую приятно держать локально: бесплатная, понимает русский, ставится одной командой и закрывает любые задачи на «поиск по смыслу». Единственное, что нужно помнить, — фиксированные 1024 измерения и живой ollama за спиной.

Если у вас уже крутится ollama — попробуйте, потерять нечего: одна команда и можно гонять эмбеддинги прямо сейчас.

Ссылки

— BGE-M3 на HuggingFace

— BGE-M3 в библиотеке Ollama

— Ollama

#selfhosting #openclaw #embeddings

Обложка

Агентский аппетит и «цена» каждого вызова

Бывает так: пишешь субагентов, автоматизации, скрипты — и каждый вызов модели кажется бесплатным, «ну это же бесплатный режим». Но как только начинаешь гонять их по многу раз в день, расходы всё равно набегают. Claude Opus 5 — отличная модель, но даже при цене $5 за миллион входных токенов при постоянной нагрузке бюджет чувствуется. GPT-5 — вообще роскошь. А есть ли путь, где можно не думать о каждом запросе и всё же получать приличные результаты?

Здесь на сцену выходит OpenRouter — агрегатор с одной фишкой: один API-ключ, сотни моделей, и у многих из них есть бесплатные версии с суффиксом :free. Цена — ноль. Пафос — ноль. Но и лимиты соответствующие: без пополнения счёта всего 50 запросов в день на все свободные модели вместе. Для агента этого обычно мало.

Что такое OpenRouter и зачем он нам, хомлабистам

OpenRouter — это прокси-агрегатор LLM API. Один эндпоинт, один ключ, и ты получаешь доступ к Claude, GPT, Gemini, Qwen, Nemotron и ещё множеству моделей. Формат запросов OpenAI-совместимый: сменить модель можно заменой параметра model в запросе. Никаких отдельных аккаунтов под каждого провайдера и лишней волокиты.

И среди этого зоопарка есть модели с суффиксом :free. Их цена в токенах — 0. То есть ты можешь слать запрос, и с баланса не спишется ни копейки. Но есть важная оговорка: общий лимит на все бесплатные модели вместе взятые — 50 запросов в день. Пытаешься использовать субагента 60 раз — получаешь ошибку и начинаешь думать о платных вариантах.

Как поднять лимит с 50 до 1000 (разово)

Помогает разовое пополнение счёта на $10. Это не подписка и не ежемесячный платёж. Один раз вносишь десять долларов — и лимит поднимается до 1000 запросов в день на все свободные модели суммарно. 1000 — уже достаточно для рутины: проверки, черновики, лёгкие субагенты, ежедневные отчёты.

Проверить свой статус можно одной командой curl:

curl https://openrouter.ai/api/v1/auth/key \
  -H "Authorization: Bearer YOUR_KEY_HERE"

В ответе JSON будет поле is_free_tier: – true — лимит 50 запросов/день. – false — лимит 1000 запросов/день.

Проверено на нашем стенде: после пополнения поле сменилось на false, и лимит стал 1000.

Живые free-модели: таблица, которую можно повесить на стенд

Не все :free модели одинаково полезны. Вот список проверенных в день написания статьи (21 августа 2026):

Модель Контекст Примечание
nvidia/nemotron-3.5-lightning:free 1 000 000 токенов Агентный режим, вызовы функций (tool calls) — работают
nvidia/nemotron-3-super-120b-a12b:free 262 000 токенов Хороша для общих задач
google/gemma-4-31b-it:free 262 000 токенов Часты 429 из-за перегрузки
z-ai/glm-5.2:free 256 000 токенов Сильная, но тоже бывают 429
openai/gpt-oss-20b:free 131 000 токенов Есть vision, не всегда стабильна

Примечание: лимит 1000 запросов/день общий на все free-модели, а не на каждую отдельно. И 20 req/мин — потолок, его нужно учитывать.

Именно nemotron-3.5-lightning:free с её миллионным контекстом стал главным героем наших тестов: субагент на этой модели успешно решил задачу, потратив около 20 000 токенов — и всё это бесплатно. Плюс эта модель корректно отдаёт вызовы функций — удобно для автоматизаций, скриптов и управления через функции.

Грабли: 429, нестабильность и общий пул лимитов

Если просто заменить все запросы на nemotron-3.5-lightning:free, радость может быстро оборваться. Free-модели живут на общих серверах провайдеров, и в пиковые моменты они отдают HTTP 429 с ошибкой «Provider returned error». Это не блокировка — это перегрузка очереди. Решение: повтор с паузой (retry) или переключение на вторую свободную модель из списка.

Также важно помнить, что лимит 1000/день — общий. Если одновременно запустить десятки субагентов на разных :free моделях, часть упрётся в потолок и будет ждать следующего дня. Помогает умный каскад: сначала вычерпываем бесплатный лимит на рутину, затем падаем на дешёвые платные модели (они стоят копейки за 1K токенов), а дорогие — только по особым случаям, когда нужен Claude Opus или GPT-5.

Главный козырь: вызовы функций бесплатно

Самое интересное — nvidia/nemotron-3.5-lightning:free поддерживает вызовы функций (tool calls). Это значит, что субагент может не просто отвечать текстом, а инициировать вызовы пользовательских функций: читать файлы, выполнять скрипты, обращаться к внешним сервисам. И всё это — без затрат на токены.

Пример из практики: субагент на nemotron-3.5-lightning:free получил задачу, сам составил запрос к API, достал данные и отформатировал markdown-отчёт. Никаких трат, никаких заморочек — полноценный агентный режим на бесплатной модели.

Стратегия каскада: от бесплатного к платному

  1. Free-уровень (:free модели) — 1000 req/день, 20 req/мин. Для рутины: субагенты, проверки здоровья, генерация черновиков, простые вопросы.
  2. Дешёвый платный — glm-5.2, gemma-4-31b-it и др. за копейки за 1K токенов. Когда free-лимит исчерпан, но бюджет ещё ограничен.
  3. Платные флагманы — Claude Opus 5, GPT-5. Только если задача требует максимального качества или специфических возможностей, которых нет в дешёвых моделях.

Так ты остаёшься в контроле расходов и при этом не страдаешь от отсутствия мощных моделей, когда они действительно нужны.

Вывод

OpenRouter с его бесплатными моделями — рабочее решение для повседневных задач: лимиты скромные, но после разового пополнения на $10 получаешь 1000 запросов/день на общий пул :free. Главное — учитывать 429, ставить паузы на повторы и помнить про общий лимит. Плюс — поддержка вызовов функций на nemotron-3.5-lightning:free, что позволяет запускать автоматизации без токенных затрат.

Если давно считаешь расходы на LLM-API, попробуй OpenRouter. У нас лимит уже активирован, субагент на nemotron-3.5-lightning:free сегодня решил несколько задач — и ни копейки не списалось. Возможно, это будет тем самым «бесплатным апгрейдом» для твоих автоматизаций.


Публикация в канал «Цифровой дворник» — homelab, самохостинг, ИИ‑инфраструктура. Факты взяты из открытых настроек OpenRouter на дату написания статьи. Личный опыт может отличаться.

#selfhosting #openclaw #llm

Обложка

Цикл «Виды связности и SDN», часть 2. Предыдущая часть: «SDN без магии: карта видов связности».

Ось: underlay и overlay (транспорт).

Представим, что сервер в офисе должен общаться с виртуальной машиной в облаке так, будто они находятся в одной внутренней сети. Между ними уже есть Интернет. Мы не меняем Интернет, а создаём поверх него собственную логическую связность.

Интернет в этой схеме — underlay. Туннель — overlay.

Что происходит с пакетом

Приложение формирует обычный IP-пакет. Overlay-компонент добавляет к нему свой заголовок, затем внешний IP-заголовок. Underlay видит только наружные адреса узлов туннеля и доставляет контейнер целиком.

На принимающей стороне внешние заголовки снимаются, и исходный пакет продолжает путь так, будто никакого Интернета между участниками не было.

VXLAN обычно вкладывает Ethernet-кадр в UDP. Geneve делает похожее, но имеет расширяемые поля параметров. IPIP помещает IPv4-пакет внутрь другого IPv4-пакета. GRE добавляет собственный заголовок между внешним IP и полезной нагрузкой. WireGuard не только инкапсулирует, но и шифрует содержимое.

Внешний заголовок не всегда UDP. IPIP использует IP protocol 4, GRE — protocol 47. У них нет номера TCP- или UDP-порта.

Требования к underlay

Минимальное требование почти всегда одно: адреса конечных точек туннеля должны быть достижимы друг для друга. Но дальше начинаются детали.

Для VXLAN и Geneve межсетевые экраны должны пропускать соответствующий UDP. Порт зависит от реализации, а не только от названия протокола:

Механизм Внешний транспорт Типичный порт
VXLAN по IANA UDP 4789
VXLAN в Linux, Cilium, Flannel UDP 8472
VXLAN в Calico UDP 4789
Flannel VXLAN на Windows UDP 4789
Geneve UDP 6081
WireGuard UDP 51820; Cilium — 51871
IPIP IP protocol 4 порта нет
GRE IP protocol 47 порта нет

Если firewall разрешает только TCP и UDP, правило «порт для IPIP» не поможет: такого порта не существует.

Цена заголовков

Обычный Ethernet часто имеет MTU 1500. После добавления внешних заголовков внутри туннеля остаётся меньше места.

Примерные накладные расходы:

Механизм IPv4 IPv6
IPIP 20 — (это IPv4-in-IPv4)
VXLAN 50 70
Geneve без options ~50 ~70
WireGuard 60 80

VXLAN 50 байт на IPv4 складываются так: внешний IPv4 (20) + UDP (8) + VXLAN (8) + внутренний Ethernet (14). IPIP Ethernet внутрь не кладёт, поэтому налог меньше. Options у Geneve увеличивают размер сверху базовых 50. VXLAN поверх WireGuard складывает расходы обоих слоёв.

Если inner MTU не уменьшить, большой пакет придётся фрагментировать или отправитель должен узнать допустимый размер через Path MTU Discovery. Когда ICMP-сообщения о необходимости уменьшить пакет фильтруются, возникает PMTUD black hole.

Для IPv4 это ICMP Type 3 Code 4 (Fragmentation Needed). Для IPv6 — ICMPv6 Packet Too Big: промежуточные маршрутизаторы IPv6 не фрагментируют, поэтому без PTB большой пакет просто не проходит.

Маленький ping проходит, SSH открывается, а загрузка страницы или передача большого файла зависает. Администратор смотрит на зелёный мониторинг и начинает подозревать приложение. Приложение обычно ни при чём.

Overlay не повышает качество underlay

Если underlay теряет 3% пакетов, WireGuard их не вернёт. Если между площадками 90 мс задержки, VXLAN не сделает 2 мс. Если маршрутизация асимметрична, stateful firewall может продолжать отбрасывать часть трафика.

Добавляется собственная служебная нагрузка:

  • keepalive для сохранения NAT mapping;
  • сообщения control plane;
  • STUN и negotiation для mesh-сетей;
  • BFD или другие проверки доступности;
  • дополнительная обработка и шифрование.

Поэтому сначала проверяют underlay: адреса, маршруты, потери, задержку, MTU, ECMP и firewall. Затем — overlay.

Overlay и ECMP

Внешняя сеть принимает решение по внешним заголовкам. Если все внутренние потоки между двумя узлами получают одинаковую внешнюю пару адресов и портов, underlay может считать их одним большим потоком и отправлять по одному ECMP-пути.

Некоторые реализации меняют UDP source port на основе хеша внутреннего потока. Тогда разные пользовательские соединения лучше распределяются между равнозначными путями. Это важная деталь для производительности фабрики ЦОД, хотя конечные виртуальные машины о ней не знают.

Где ставить границу

Overlay можно завершить на:

  • физическом маршрутизаторе;
  • коммутаторе с VTEP;
  • гипервизоре;
  • Kubernetes-узле;
  • отдельном шлюзе площадки;
  • клиентском ноутбуке.

Чем ближе конечная точка к приложению, тем меньше незашифрованный участок и точнее политики. Но тем больше агентов, ключей, туннелей и состояний приходится обслуживать.

Практический порядок диагностики

  1. Проверить достижимость внешних адресов конечных точек.
  2. Проверить разрешённый внешний протокол и порт.
  3. Измерить максимальный пакет без фрагментации.
  4. Посмотреть route lookup до внешнего адреса туннеля.
  5. Проверить состояние интерфейса туннеля.
  6. Снять дамп одновременно до и после инкапсуляции.
  7. Только после этого разбирать маршруты и политики внутри overlay.

Где это ломается

  • Inner MTU оставили 1500, а ICMP Fragmentation Needed или IPv6 Packet Too Big отфильтровали.
  • Ищут «порт VXLAN», а реализация слушает 8472 вместо 4789 — или наоборот.
  • Пытаются открыть «порт IPIP» на firewall, который пропускает только TCP/UDP.
  • Overlay считают лечением потерь и асимметрии underlay.
  • Все внутренние потоки схлопываются в один ECMP-путь из-за одинаковой внешней 5-tuple.

В следующей части поднимемся на L2 и попробуем растянуть Ethernet. Посмотрим, зачем VXLAN понадобился VNI, какую работу выполняет EVPN и почему broadcast-домен через несколько площадок нужно создавать только при наличии уважительной причины.

Предыдущая часть: «SDN без магии: карта видов связности»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «L2-overlay: VLAN, VXLAN, Geneve и EVPN»

Схема

#network #selfhosting