Почём токены для памяти: граф против контекста
Есть момент, когда агент перестаёт влезать в собственный промпт. Начинаешь с трёх заметок, через месяц их шестьдесят, и каждый старт беседы ты уже платишь за то, чтобы модель просто прочитала твою же память — до того, как сделает хоть что-то полезное.
Я упёрся в это ровно тогда, когда закончил серию из одиннадцати статей и понял, что помнить их все «в голове» (в контексте) больше нельзя. Пришлось решать: тащить всё в промпт и платить за каждый запрос, или построить граф знаний и платить за то, чтобы в него что-то положить.
Дальше — реальные цифры с моей домашней лабы. Не синтетика, а замеры на живом ассистенте.
Два способа помнить
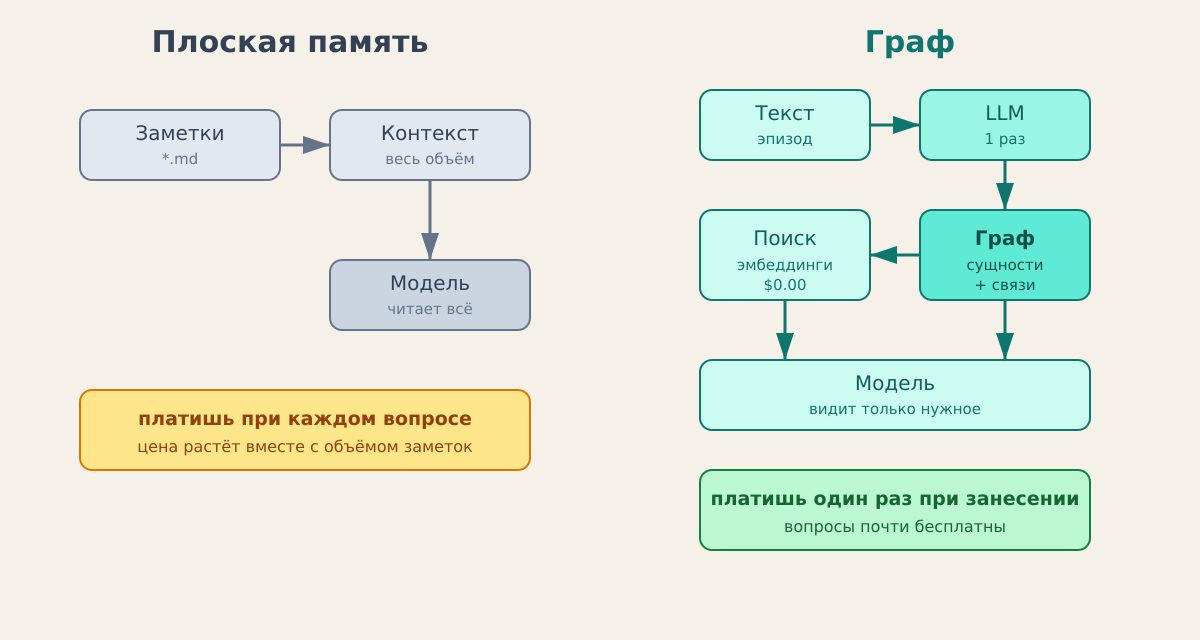
Плоская память. Всё лежит в markdown-файлах, которые подгружаются в контекст. Модель видит их напрямую, но каждый запрос начинается с того, что весь этот текст прогоняется через токенайзер. Чем больше помнишь — тем дороже каждый вопрос, даже «как дела».
Графовая память. Текст прогоняется через LLM один раз — из него вытаскиваются сущности и связи («gemma3 работает на ollama», «gemma3 не поддерживает tools»). Это складывается в граф. При вопросе ищешь по смыслу стартовый узел и разворачиваешь соседей. Платишь за инжест, поиск почти бесплатный.
Какие бывают графы
Три уровня, от простого к навороченному — все три я разворачивал за один день и гонял на одной и той же статье.
Самописный SQLite-граф. Две таблицы — сущности и связи, обход соседей пишешь сам. Ноль инфраструктуры, полный контроль, читаемый вывод. Минус: никакой темпоральности — граф не помнит, что факт был правдой только до вчера, и всё извлечение вручную.
Property graph (FalkorDB, Neo4j). Настоящий графовый движок, запросы на Cypher, быстрый обход на любую глубину, индексы. Это как SQL, только для связей. FalkorDB легче Neo4j — это Redis с графовым модулем, поднимается одной командой.
Темпоральный граф (Graphiti, Microsoft GraphRAG). Уровень выше: ты не строишь граф вручную, а скармливаешь текст — LLM сам вытаскивает сущности, факты и связи. Главное отличие — битемпоральность: граф помнит не только «что правда сейчас», но и «что было правдой раньше», и откуда каждый факт взялся. Для ассистента, который живёт неделями и чьи знания устаревают, это решающее свойство.
Как это ставится
Честный путь по моему опыту.
FalkorDB — одна команда:
docker run -d --name falkordb -p 6379:6379 falkordb/falkordb
Graphiti поверх него — Python-пакет:
pip install graphiti-core[falkordb]
Дальше конфиг: какая LLM извлекает сущности, какие эмбеддинги, куда складывать. Грабли, на которые я наступил, чтобы ты не наступал: у DeepSeek нужно явно задать «маленькую» модель (иначе Graphiti шлёт дефолтную OpenAI-модель и ловит 400); эмбеддеру нужен непустой api_key, даже если он никем не проверяется; кириллические названия связей движок не переваривает — их надо класть в свойство ребра, а не в тип.
SQLite-граф ставить нечего — это двадцать строк на Python.
Дальше — замеры, ради которых всё затевалось.
Замер 1: начало беседы
Считаем, сколько токенов уходит на старт, до первого вопроса.
Файлы, которые грузятся всегда: долговременная память, заметки по инструментам, правила поведения — примерно 16–20 тысяч токенов. Это цена «проснуться и вспомнить, кто я».
А вот дальше развилка. Дневные заметки копятся. Вся история — это уже 61 тысяча токенов и растёт каждый день. В плоской памяти у тебя два пути, оба плохие: либо грузить всё (каждый запрос дорожает на десятки тысяч токенов), либо обрезать старое (и агент «забывает» месяц назад).
Замер 2: сколько стоит положить знание в граф
Кладём в граф короткий эпизод — 483 символа текста, пять предложений про то, что мы подняли графовую память.
Что происходит под капотом: LLM несколько раз прогоняет текст — извлекает сущности, потом связи, потом сверяет с уже существующими узлами, не дубликаты ли это. Итого 8 вызовов LLM, 13 тысяч входных и 1 тысяча выходных токенов, 13 секунд.
В деньгах — $0.0021 за эпизод на дешёвой модели. Это и есть цена знания: одна заметка ≈ полцента.
Статья из серии (6–7 тысяч символов) обходится в $0.03. Вся серия из одиннадцати статей — $0.33.
Замер 3: сколько стоит вспомнить
Вопрос «какая локальная модель используется для эмбеддингов» к графу.
Ноль вызовов LLM. $0. Ноль целых три десятых секунды.
Потому что поиск по графу — это не LLM, а эмбеддинги (локальная модель, бесплатно) плюс обход связей в базе. LLM подключается только на этапе занесения знания, а не на каждом вопросе.
Это главный разворот по сравнению с плоской памятью: там ты платишь за знание при каждом обращении к нему, здесь — один раз при занесении.
Замер 4: субагенты
Запуск субагента — это отдельная история, и тут граф ничего не экономит напрямую: субагент всё равно получает свой контекст и свой промпт. Каждый субагент — это десятки тысяч токенов входного контекста только на то, чтобы он понял задачу.
Что реально меняет граф: субагент может не тащить с собой всю историю. Достаточно дать ему узкий контекст задачи и, если нужно, пару фактов из графа точечным поиском — а не вываливать на него шестьдесят тысяч токенов прошлого.
А если это кодинг-агент
Тот же самый граф можно повесить не только на ассистента, но и на кодинг-агентов — Codex, Claude Code, Cursor, OpenCode. Идея ровно та же, что с заметками: кодинг-агент не держит в голове всю кодовую базу, а спрашивает граф, куда смотреть.
Общий знаменатель — MCP. Все четверо умеют подключать MCP-серверы как инструменты, а у Graphiti такой сервер уже есть из коробки. Разница только в конфиге:
- Codex — подключить Graphiti как MCP memory-инструмент; агент зовёт его вместо того, чтобы перечитывать файлы.
- Claude Code —
claude mcp addили hook, который при старте задачи дергает граф за контекстом. - Cursor —
.cursor/mcp.json, граф становится обычным источником@-упоминаний. - OpenCode — тот же MCP, конфиг в json.
Что кладём в граф: карту репозитория — файлы, модули, функции, классы и связи между ними (кто кого импортирует, кто кого вызывает), плюс историю решений «почему сделали так, а не иначе».
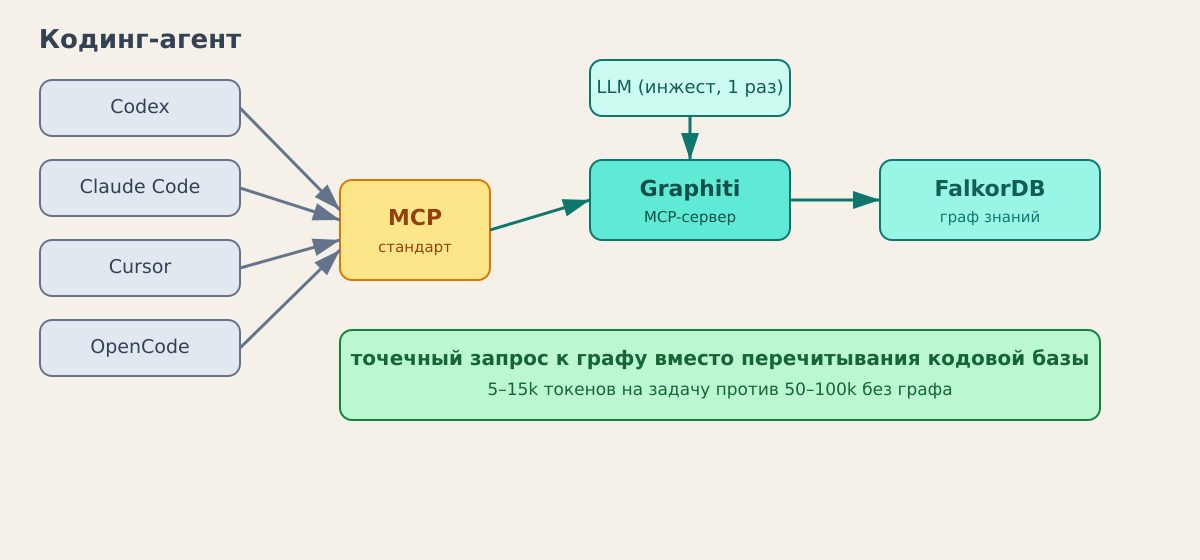
Прогноз по токенам. Это уже не замер, а честная прикидка, но логика та же, что в замерах выше:
- Сейчас кодинг-агент на каждую задачу перечитывает дерево проекта и релевантные файлы — легко 50–100k входных токенов только на то, чтобы понять, где он вообще находится.
- С графом он сперва спрашивает «какие модули связаны с этой функцией», получает точечный список из 5–15k токенов и читает только нужное. Поиск по графу, напомню, стоит $0 — это локальные эмбеддинги.
- Итог: 60–80% экономии на входном контексте на каждой задаче. При активном кодинге это ощутимо — не десятки центов в день, а разы на месячной дистанции.
Где экономия не сработает: если проект маленький и весь влезает в контекст целиком — граф не нужен. И сам инжест кодовой базы не бесплатен: гонять весь код через LLM для извлечения связей — дорого (у нас $0.0021 за полтысячи символов). Для кода разумнее гибрид: структуру (файлы, сигнатуры, импорты) снимать статическим анализом, а через LLM — только описания и решения. Тогда разовая цена индексации окупается за считанные дни активной работы.
Точка окупаемости
Граф начинает выигрывать, когда одни и те же знания спрашиваются повторно.
Одна заметка = $0.0021 за инжест. Если факт из неё понадобится хотя бы пару раз, граф уже дешевле, чем каждый раз читать его в контексте. А главное — граф не растёт в промпте: тысячи сущностей стоят столько же при поиске, сколько и десять.
Плоская память выигрывает ровно в одном случае: знаний мало, и они меняются редко. Тогда проще держать их в одном файле.
Вывод
Граф — это не «модно», это про то, где платить. Либо понемногу, но при каждом вопросе (контекст), либо один раз при занесении (граф). Для ассистента, который живёт неделями и накапливает опыт, второй вариант оказывается дешевле — и, что важнее, предсказуемее: стоимость вопроса не зависит от того, сколько ты всего знаешь.