Цифровой дворник

selfhosting

Обложка

Каждый новый релиз языковой модели начинается с одной и той же цифры, и с каждым разом она всё нелепее: «контекст теперь 128к», «256к», «миллион токенов!». Звучит как обещание вечной памяти: закинул в чат всю свою жизнь — и модель всё помнит. На деле миллион токенов — это не память. Это рабочий стол. Огромный, но всё ещё рабочий стол, который протирают тряпкой после каждой смены.

Я это выучил на своей шкуре, когда завёл домашнего агента на локальных моделях и начал ждать от него памяти. Спустя пару недель стало очевидно: агент помнит ровно до перезапуска. Дальше — чистый лист, хоть ты ему вчера целый дневник в окно загрузил.

Что такое окно контекста на самом деле

Окно контекста — это не жёсткий диск и не долговременная память. Это оперативка. Все токены, которые модель видит прямо сейчас — твой вопрос, её ответы, системный промпт, история переписки — лежат в одном буфере. Пока буфер жив, модель «в курсе». Как только буфер пересоздаётся — сессия умерла, и контекст испарился бесследно.

Отсюда и та самая амнезия после рестарта. Агент не «забыл», что мы вчера настраивали туннель. Он этого никогда и не знал: в новом запуске буфер пуст, а на диск контекст сам по себе не пишется. Никто не обещал, что оперативка переживёт выключение питания.

Тут обычно вступает маркетинг и шепчет: «ну так загрузи всё обратно, окно-то вон какое». И вот тут начинается самое интересное.

Компакция: сжатие вместо памяти

Чтобы хоть как-то удержать длинный разговор, придумали компакцию. Когда диалог перерастает окно, агент берёт старые сообщения, сжимает их в краткое резюме и подсовывает его модели вместо полного текста. Звучит разумно: вместо десяти экранов — один абзац «мы обсуждали туннель, решили X».

Только это не память, а игра в испорченный телефон. Резюме теряет детали — имена файлов, точные команды, оговорки, «а потом я передумал». С каждой итерацией сжатия смысл понемногу плывёт. Через три компакции агент уверенно «вспоминает», что ты просил удалить сервер, хотя ты просил его перезапустить. Красиво, но бесполезно, если работаешь с инфраструктурой.

Внешняя память в файлах — вот где собака зарыта

Настоящая память агента живёт не в окне, а на диске. В моей лабе это три простые штуки, и ни одна не просит «миллион токенов».

Дневники. Файлы вида memory/YYYY-MM-DD.md, куда сыпятся сырые логи дня: что делали, что сломали, что починили. Это черновик, не парадная память — грязный, но настоящий.

Кураторская память. Один файл, в который вручную отбирается только то, что жалко потерять: решения, выводы, грабли, на которые уже наступили. Не лог, а дистиллят. Перечитывать его целиком — быстро, потому что он короткий.

Векторный поиск. Когда нужно найти «ту самую мысль», но не помнишь, в каком файле и какими словами она записана. Эмбеддинги раскладывают заметки по смыслу, и вопрос тянет к нужному месту даже при полном несовпадении формулировок. У меня это bge-m3 на локальном железе — ничего в облако не уезжает.

Вся схема держится на простом принципе: записал — значит помню. Окно контекста — это краткосрочка, файлы — долговременная память. Одно не заменяет другое, как стикер на мониторе не заменяет записную книжку.

Наши цифры: что реально тянет локальное железо

Маркетинг обещает миллионы, а локальный инференс на AMD-графике честно показывает, где границы. Моя основная модель — gemma3 на 12 миллиардов параметров — формально имеет окно в 131072 токена. Запасная, на 4 миллиарда, — 32768. Разница в четыре раза, и это чувствуется.

Средняя 8B-модель, которую я держал для простых вопросов, вообще живёт в окне около 33 тысяч токенов и требует свежей сессии: зашёл в длинный разговор — и всё, буфер забит, агент начинает путаться и нести мусор. Приходилось перезапускать сессию, чтобы вернуть его в чувство.

А теперь самое смешное. ROCm-хак на этой связке нестабилен ровно там, где окно пытаются использовать на полную: 12B-модель падает с ROCm error: CUBLAS_STATUS_INTERNAL_ERROR на промптах больше десяти килобайт. Короткие вопросы — летает. Сунул длинный конфиг — здравствуй, ошибка. Младшая 4B те же тридцать килобайт переваривает, но так медленно, что проще сходить заварить чай. То есть на бумаге окно большое, а по факту длинный контекст на локальном железе — это либо падение, либо ожидание.

Цена длинного контекста

Даже если железо тянет и ничего не падает, длинный контекст не бесплатен. Три счёта, которые редко считают вслух.

Кэш. Каждый раз, когда ты досылаешь в окно новое сообщение, модель перечитывает всё, что уже лежит в буфере. Промахи по кэшу — это пересчёт одних и тех же токенов снова и снова. Чем длиннее контекст, тем дороже каждое следующее сообщение, даже если ты просто написал «ок».

Деньги. В облаке за это платят буквально: входные токены тарифицируются, и миллион токенов контекста — это не «бесплатная память», а счёт, который растёт с каждым поворотом диалога.

Внимание. И самая коварная часть — «потеря в середине». Модель лучше всего помнит начало и конец окна, а всё, что в середине, — в тумане. Загрузил три конфига, короткий вопрос в конце, и ответ строится по первому файлу и последней фразе, а ключевая строка из середины благополучно проигнорирована. Длинный контекст не делает модель внимательнее — он размазывает внимание по большему полю.

Что реально помогает

Никаких секретов, всё скучное и рабочее.

Короткие файлы-заметки вместо гигантского промпта. Вместо того чтобы впихнуть в окно полконфига роутера, кладу его в файл, а в окно — ссылку и пару строк сути. Агент читает файл, когда нужно, а не держит всё в голове.

Дисциплина «записал — значит помню». Всё, что важно, оседает в дневнике или кураторской памяти в тот же день. Тогда «память» агента не зависит от того, уцелела ли сессия после рестарта. Сессия может умереть — файлы останутся.

Поиск по памяти вместо раздувания промпта. Когда нужно что-то вспомнить, не тащу всю базу в окно. Прогоняю вопрос через векторный поиск, получаю пару релевантных кусков — и только их кладу в контекст. Окно остаётся коротким, а память — полной.

Итог

Контекстное окно — это кратковременная память: большой, но эфемерный буфер. Миллион токенов в нём не делает агента умнее, зато делает запросы дороже и рассеивает внимание. Настоящая память — это дисциплина: короткие файлы, дневники, кураторская выборка и поиск по смыслу. Окно теряется при каждом рестарте, а файл, записанный вчера, будет ждать агента и послезавтра. «Записал — значит помню» работает надёжнее любого маркетингового «миллион токенов».
#llm #openclaw #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 13. Предыдущая часть: «SD-WAN: связность филиалов, ЦОДов и облаков».

Сводка: диагностика по всем осям.

SDN добавляет удобную абстракцию: логический switch, сеть, policy или service. При аварии приходится аккуратно спускаться обратно к пакетам.

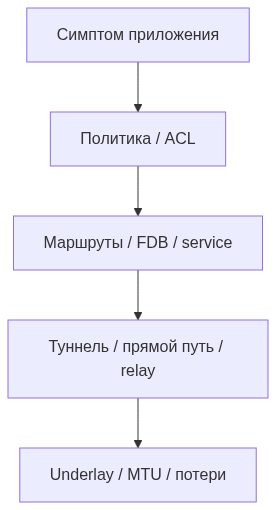
Симптом фиксируем сверху: какой клиент, к какому имени, порту и в какое время не смог подключиться. Искать причину идём снизу вверх: underlay → туннель → маршруты → политики → приложение.

Уровень 1: underlay

Сначала проверяем внешнюю IP-связность конечных точек:

  • route lookup;
  • ARP/ND до next hop;
  • доступность внешнего адреса;
  • loss и latency;
  • ECMP;
  • firewall;
  • максимальный пакет без фрагментации;
  • проходят ли ICMP Fragmentation Needed и IPv6 Packet Too Big.

Если underlay не доставляет UDP/6081, нет смысла начинать с OVN logical flows.

Уровень 2: туннель

Проверяем:

  • создан ли интерфейс;
  • локальный и удалённый endpoint;
  • VNI или tunnel ID;
  • handshake и время последнего обмена;
  • счётчики RX/TX и drops;
  • прямой путь или relay;
  • внешний протокол и порт;
  • выбранный MTU.

Дамп на внешнем интерфейсе показывает инкапсулированный поток. Дамп на интерфейсе нагрузки — исходный пакет. Снимать их полезно одновременно.

Уровень 3: forwarding

Для L2 смотрим FDB, MAC learning, ARP/ND и flooding.

Для L3 — RIB/FIB, policy routing, VRF, BGP routes и next hop.

В EVPN проверяем наличие нужного MAC/IP или prefix route и Type 3 для BUM. В Kubernetes — маршруты pod CIDR, endpoint identity и service backend.

Уровень 4: политики

Пакет может быть доставлен до узла и отброшен локальной ACL, NetworkPolicy, eBPF policy или distributed firewall.

Проверяем политики с обеих сторон. В ZeroTier и некоторых mesh-системах правила применяются локально отправителем и получателем. В Kubernetes ingress и egress policies независимы.

Уровень 5: приложение

Только после сети проверяем listener, DNS, сертификат, proxy и само приложение.

Лаборатория

Для сравнения платформ используется один стенд:

  • офис за NAT;
  • ЦОД с публичным адресом;
  • второй ЦОД за CGNAT;
  • облачная VM;
  • ноутбук, меняющий Wi-Fi/LTE;
  • два Kubernetes-узла;
  • два контроллера и два relay, где это поддерживается.

Канонический список профилей — в tables/lab-protocol.md. Статья и протокол должны совпадать.

Профили отказа

  1. Один публичный узел, второй за обычным NAT.
  2. Оба участника за обычным NAT.
  3. Оба участника за CGNAT.
  4. Hairpin: оба за одним NAT.
  5. Address-and-port-dependent mapping с двух сторон.
  6. Запрещены все входящие соединения.
  7. Полностью запрещён UDP.
  8. Разрешены только TCP/80 и TCP/443.
  9. Доступ наружу возможен через HTTP-прокси.
  10. Недоступен публичный relay.
  11. Недоступен собственный relay.
  12. Недоступен контроллер.
  13. Один узел меняет внешний адрес во время сессии.
  14. Между площадками MTU 1400.
  15. PMTUD black hole: фильтр ICMP Fragmentation Needed / IPv6 PTB.
  16. Один ECMP-путь теряет пакеты.
  17. Отозван узел и изменена ACL.
  18. Underlay только IPv6.

Что измерять

  • время первого соединения;
  • прямой или relay путь;
  • время failover;
  • сохраняется ли открытый SSH;
  • открывается ли новый SSH;
  • можно ли подключить новый узел;
  • применяется ли новая ACL;
  • RTT, jitter и loss;
  • TCP/UDP throughput;
  • CPU;
  • рабочий inner MTU.

Почему дата обязательна

Поведение SaaS-контроллеров, публичных relay и операторских сетей меняется. Результат «работает через TCP/443» должен содержать версию, дату, оператора, регион, тип ограничения и фактический транспорт data plane. Без этого таблица быстро превращается в собрание воспоминаний. Чеклист свойств транспорта — в части 7.

Набор инструментов

  • ip route get, ip rule, ip neigh;
  • bridge fdb;
  • ss, conntrack;
  • tcpdump/Wireshark;
  • tracepath, ping с DF и изменяемым размером;
  • iperf3;
  • wg show;
  • birdc, vtysh, BGP looking glass;
  • ovs-vsctl, ovs-ofctl, ovn-trace;
  • cilium status, Hubble;
  • журналы контроллера, signal и relay.

Можно использовать свой скрипт проверки доступности для регулярной проверки TCP/HTTP/HTTPS endpoints с разных узлов, но она не заменяет анализ конкретного overlay-протокола.

Где это ломается

  • Панель зелёная, а смотрели только ICMP.
  • Пинг есть — значит «сеть жива», при этом HTTPS рвётся на MTU.
  • UDP/443 записали как HTTPS.
  • Профиль отказа в статье не совпал с протоколом лаборатории.
  • Результат без даты, версии и оператора перенесли в сравнительную матрицу.

Итог цикла

Универсального победителя нет.

Внутри ЦОД разумно смотреть на native routing, EVPN/VXLAN и OVN. В Kubernetes — на возможности underlay и требования к policy/observability. Для удалённых узлов за NAT — на управляемый mesh с хорошим relay. Для сервисного доступа — на identity-based overlay. Для филиалов — на SD-WAN-политику и реальные измерения каналов.

Правильный выбор начинается не с логотипа, а с пяти вопросов: уровень, underlay, управление, топология и граница шифрования.

Предыдущая часть: «SD-WAN: связность филиалов, ЦОДов и облаков»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: —

Схема

симптом фиксируем сверху, причину ищем снизу.

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 12. Предыдущая часть: «SDN в Kubernetes: Flannel, Calico, Cilium и OVN-Kubernetes».

Ось: область — филиалы и выбор пути (SD-WAN).

Если между офисом и ЦОДом поднять два VPN-туннеля, мы получим резервную связность. SD-WAN появляется, когда система централизованно описывает политики, измеряет качество путей и автоматически выбирает транспорт для разных потоков.

Underlay остаётся разным

Филиал может иметь:

  • проводного оператора;
  • LTE/5G;
  • второго локального провайдера;
  • спутниковый канал;
  • L3VPN;
  • обычный Интернет.

SD-WAN строит общий overlay и скрывает различия от приложений, но учитывает реальное качество каждого канала.

Active/standby

Основной туннель используется постоянно, резервный включается после отказа. Просто и предсказуемо, но оплаченный резерв большую часть времени простаивает.

Критично правильно определить отказ. Наличие линка Ethernet и даже доступность gateway не означают, что удалённый сервис достижим.

Active/active

Несколько путей используются одновременно. Потоки распределяются по политике, ECMP или измеренным характеристикам.

Нельзя бездумно отправлять пакеты одного TCP-сеанса разными маршрутами с сильно отличающейся задержкой: reordering ухудшит производительность. Обычно путь выбирается на поток или применяется специальная техника packet steering.

Пробы SLA

Система измеряет:

  • loss;
  • latency;
  • jitter;
  • доступность конкретного назначения;
  • иногда реальную производительность.

Для голоса важны задержка и jitter, для резервного копирования — полоса, для терминального доступа — loss и latency. Один универсальный показатель «канал зелёный» недостаточен.

Маршрутизация по приложению

Политика может сказать:

  • голос идёт по каналу с минимальным jitter;
  • корпоративные приложения — через ЦОД;
  • обновления ОС — через локальный Интернет;
  • backup использует дешёвый канал ночью;
  • при деградации SaaS трафик переключается на другого оператора.

Для этого нужны классификация, измерения и механизм безопасно изменить forwarding.

Локальный выход (local breakout)

Не весь Интернет-трафик нужно возить через центральный ЦОД. Локальный выход снижает задержку и нагрузку на backbone.

Но политики безопасности, DNS, фильтрация и журналирование должны работать одинаково на всех филиалах. Иначе local breakout превращает каждый офис в отдельный маленький периметр, который надо обслуживать.

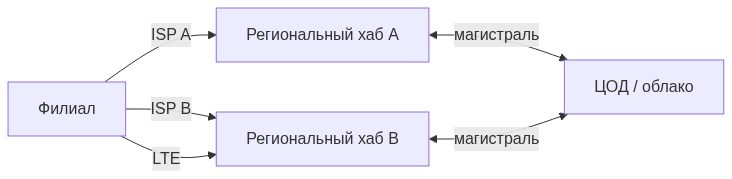
Топология

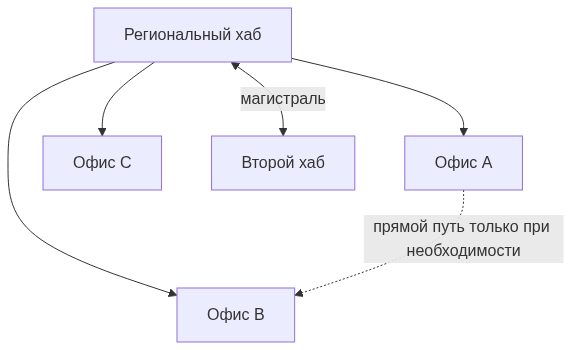
Небольшая сеть может использовать два центральных хаба.

Распределённая компания — региональные хабы и контролируемый inter-region backbone.

Прямые dynamic tunnels между филиалами полезны для голоса и локального обмена, но не обязаны подниматься между каждой парой.

Control plane и отказ

Orchestrator хранит намерение (intent) и распространяет конфигурацию. Локальное устройство должно продолжать forwarding по последней рабочей политике при потере управления.

Проверяем отдельно:

  • существующие сессии;
  • новые сессии;
  • переключение при отказе underlay;
  • обновление политики;
  • возврат основного канала;
  • split brain между контроллерами.

Что можно собрать самостоятельно

Базовый вариант:

  • VyOS/Linux/маршрутизатор на филиале;
  • туннели WireGuard или IPsec;
  • BGP/OSPF внутри overlay;
  • BFD или активные probes;
  • policy routing;
  • Ansible/API для конфигурации;
  • Prometheus/Zabbix для измерений.

Это уже способно дать хорошую связность. Но придётся самостоятельно решать orchestration, безопасное обновление политик, инвентарь, откат и единое представление состояния.

Коммерческий SD-WAN продаёт именно эту операционную упаковку, а не неизвестный науке вид туннеля.

Где это ломается

  • «Канал зелёный», потому что ping до gateway есть, а SaaS уже недоступен.
  • Local breakout включили без единого DNS и журналирования.
  • Один TCP-сеанс размазали по двум каналам с разной задержкой.
  • Контроллеры в split brain раздают разные политики.
  • Три туннеля называют SD-WAN, хотя выбора пути по SLA нет.

В финальной части соберём программу диагностики и начнём ломать нашу лабораторию одинаковыми способами.

Предыдущая часть: «SDN в Kubernetes: Flannel, Calico, Cilium и OVN-Kubernetes»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Диагностика SDN и лаборатория отказов»

Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 11. Предыдущая часть: «SDN в ЦОД: spine-leaf, EVPN/VXLAN и OVN».

Ось: область — Kubernetes.

Kubernetes задаёт простую модель: pods должны иметь сетевую связность без ручного NAT между каждым контейнером. Как именно пакет попадёт с одного узла на другой, решает CNI и нижележащая сеть.

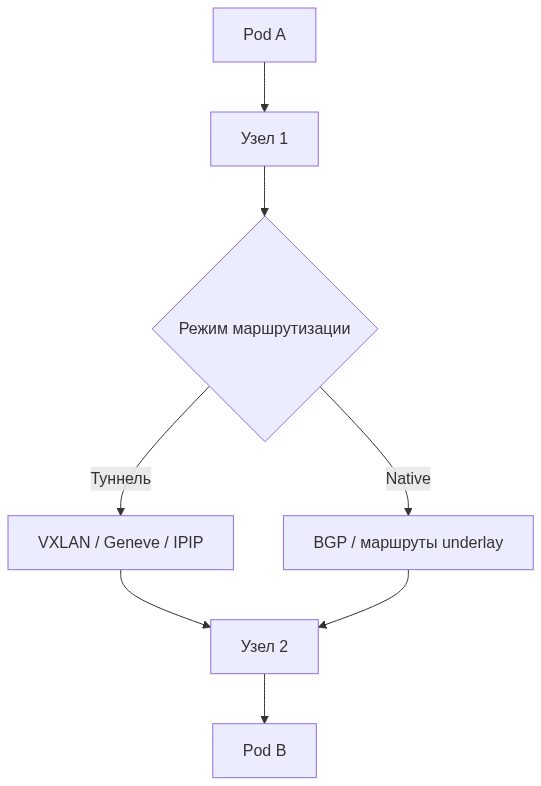
Режим CrossSubnet и выбор IPIP/VXLAN как транспорта — в части 4. Двойная инкапсуляция WireGuard поверх VXLAN/Geneve — в части 8. Здесь смотрим, что именно прячет слово «CNI».

Flannel

Flannel решает базовую задачу связности pod. Наиболее известный backend — VXLAN. Каждый узел получает свой pod CIDR, а пакеты к удалённому CIDR инкапсулируются и отправляются VTEP другого узла.

Кроме VXLAN есть host-gw: overlay нет, underlay должен маршрутизировать pod CIDR между узлами. Есть backend WireGuard. У VXLAN есть DirectRouting — близкий родственник Calico CrossSubnet: внутри подсети напрямую, через границу — туннель.

Linux Flannel VXLAN обычно слушает UDP/8472, Windows — 4789.

Это хороший вариант, когда нужна понятная базовая сеть, а сложные policies реализуются отдельным компонентом. Возможностей маршрутизации, identity и observability меньше, чем у Calico или Cilium.

Calico

Calico сочетает networking и NetworkPolicy.

Основные варианты data plane:

  • BGP/native routing без overlay;
  • IPIP;
  • VXLAN;
  • VXLAN/IPIP CrossSubnet;
  • eBPF или стандартный Linux dataplane;
  • WireGuard для шифрования.

VXLAN использует UDP/4789 и подходит большему числу сред. В VXLAN mode Calico может не использовать BGP для overlay.

В eBPF mode Calico рекомендует native routing, а если overlay необходим — VXLAN обычно предпочтительнее IPIP. Ограничения IPIP (IPv4, protocol 4, облака) разобраны в части 4.

Cilium

Cilium использует eBPF для forwarding, policies, service load balancing и observability. Он может заменить kube-proxy.

Режимы связности:

  • tunnel mode с VXLAN или Geneve;
  • native routing через обычную таблицу Linux;
  • BGP control plane для анонса сетей и сервисов;
  • прозрачное шифрование WireGuard или IPsec.

В tunnel mode Cilium строит сетку VXLAN/Geneve между узлами. В native mode underlay должен маршрутизировать pod CIDR.

WireGuard не всегда заменяет tunnel protocol. При tunnel mode Cilium сначала инкапсулирует трафик pod в VXLAN/Geneve, затем защищает межузловой поток WireGuard. При native routing остаётся одна инкапсуляция WireGuard. Firewall должен пропускать UDP/51871.

Hubble даёт наблюдаемость на уровне flows и identity, что особенно полезно, когда внешний firewall видит только зашифрованные пакеты между узлами.

OVN-Kubernetes

OVN-Kubernetes использует OVN и Open vSwitch: logical switches, routers, ACL и Geneve overlay. Это мощная модель, близкая к виртуальным сетям OpenStack.

Она удобна для сложной сегментации, logical routing и интеграции с OpenShift. Цена — больше компонентов и необходимость понимать OVN databases, logical flows и поведение gateway.

NetworkPolicy не является шифрованием

NetworkPolicy определяет, кто может обращаться к кому. Она не обязана шифровать разрешённый поток.

Шифрование не заменяет policy: зашифрованный пакет от неразрешённого workload всё равно должен быть заблокирован.

Нужны обе оси:

  • кто к кому может ходить;
  • конфиденциальность и целостность транспорта.

Как выбирать

Нужна простая базовая overlay-сеть: Flannel VXLAN.

Нужны BGP, гибридные режимы и зрелая NetworkPolicy: Calico.

Нужны eBPF, observability, service load balancing и identity-aware policy: Cilium.

Нужна модель logical switches/routers OVN или используется OpenShift: OVN-Kubernetes.

Но продукт выбирают после проверки среды:

  • размер кластера;
  • IPv4/IPv6;
  • Windows nodes;
  • возможности underlay;
  • требования к encryption;
  • доступ к физическому BGP;
  • MTU облака;
  • требования к observability;
  • компетенции команды.

Минимальная проверка перед production

  1. Pod-to-pod между узлами.
  2. Service и NodePort при локальном и удалённом backend.
  3. MTU и большие TCP-пакеты.
  4. NetworkPolicy для ingress и egress.
  5. Отказ одного node.
  6. Смена маршрута или AZ.
  7. Шифрование и фактический внешний transport.
  8. Throughput, PPS и CPU.

Где это ломается

  • NetworkPolicy есть, шифрования нет — или наоборот; оси путают.
  • Windows-узлы и IPv6 всплывают после выбора CNI.
  • MTU облака не совпадает с VXLAN/WireGuard, HTTPS «иногда зависает».
  • Cilium tunnel + WireGuard включают как «просто шифрование» без учёта двойного заголовка.
  • Underlay не маршрутизирует pod CIDR, а CNI уже перевели в native routing.

Кластер закончился, каналов между площадками несколько — дальше это уже выбор пути. В следующей части выйдем к SD-WAN.

Предыдущая часть: «SDN в ЦОД: spine-leaf, EVPN/VXLAN и OVN»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «SD-WAN: связность филиалов, ЦОДов и облаков»

Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 10. Предыдущая часть: «Self-hosted mesh: Headscale, NetBird, Netmaker, Nebula, ZeroTier и OpenZiti».

Ось: область — ЦОД.

Фабрика ЦОД строится вокруг простой идеи: underlay должен быстро и предсказуемо доставлять IP-пакеты между leaf-коммутаторами, а tenant-сети и политики живут поверх него.

Spine-leaf

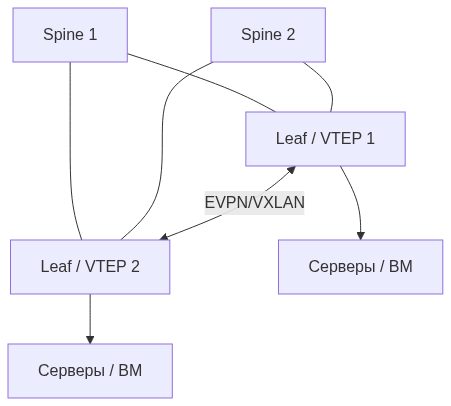
Каждый leaf подключён к каждому spine. Сервер обычно подключают к одному leaf или к паре. Путь между стойками имеет одинаковое число L3-переходов.

ECMP распределяет потоки по нескольким равнозначным путям. Отказ одного линка или spine уменьшает доступную полосу, но не обязан разрывать связность.

Underlay часто использует eBGP или OSPF/IS-IS. Его задача — маршрутизация loopback/VTEP-адресов и стабильная IP-доставка.

VXLAN data plane

Leaf или гипервизор выступает VTEP. Ethernet или IP-трафик tenant помещается в VXLAN и идёт к удалённому VTEP.

Underlay не хранит MAC конечных VM. Он видит только IP VTEP и UDP-потоки.

EVPN control plane

BGP EVPN распространяет информацию, необходимую overlay.

Коротко по типам маршрутов, которые здесь важны:

  • Type 1 — Ethernet Auto-Discovery, в том числе для ESI и multi-homing;
  • Type 2 — MAC и, при наличии, IP хоста (привязка ARP/ND); next-hop — VTEP, а не «IP endpoint»;
  • Type 3 — Inclusive Multicast Ethernet Tag, обычно ingress replication для BUM;
  • Type 4 — Ethernet Segment;
  • Type 5 — IP prefix routes для L3.

EVPN уменьшает flood-and-learn, но BUM не исчезает: Type 3 как раз про него. Type 2 убирает unknown-unicast learning и даёт ARP suppression, а не «больше никакого flooding».

L2VNI и L3VNI

L2VNI соответствует логическому Ethernet-сегменту.

L3VNI связывается с VRF и используется для маршрутизации между сетями. Tenant может иметь несколько L2VNI внутри одной VRF.

Distributed anycast gateway размещает одинаковый gateway IP/MAC на leaf. VM отправляет пакет ближайшему leaf, и inter-VLAN routing происходит локально.

Symmetric и asymmetric IRB

IRB — Integrated Routing and Bridging: leaf одновременно коммутирует внутри сегмента и маршрутизирует между сегментами.

При asymmetric IRB ingress leaf должен знать L2VNI назначения. Он маршрутизирует пакет и затем передаёт кадр в удалённый L2-сегмент.

При symmetric IRB оба leaf делают IP lookup, а между ними ходит L3VNI. Egress leaf переводит пакет в нужный L2VNI. Такая модель обычно лучше масштабируется по числу tenant-сегментов: ingress не обязан знать все удалённые L2VNI.

Border leaf

Overlay должен соединяться с внешним миром: Интернетом, MPLS, firewall, физическими серверами и legacy VLAN. Это выполняют border leaf или gateway routers.

Именно здесь часто появляется централизованный транзит, NAT, service chaining и дополнительная точка отказа. Красивый distributed east-west не отменяет проектирование north-south.

OVN и виртуальная сеть гипервизоров

OVN создаёт logical switches, logical routers, ACL, DHCP и DNS поверх Open vSwitch.

Distributed logical router реализуется на гипервизорах. East-west пакет может маршрутизироваться на исходном compute, не проходя через центральный network node. Для выхода к физической сети используются gateway chassis.

В OpenStack Neutron ML2/OVN создаёт tenant networks, ports, routers и security groups, а OVN переводит желаемую модель в logical flows и правила OVS.

Geneve удобен OVN из-за передачи metadata. VXLAN применяется при взаимодействии с VTEP и в отдельных сценариях.

Связь EVPN и OVN

Это не взаимоисключающие системы.

  • EVPN/VXLAN может работать в физической fabric.
  • OVN создаёт overlay между гипервизорами.
  • Gateway связывает виртуальные logical networks с физическими VLAN/VXLAN/EVPN.
  • Более новые интеграции позволяют динамически рекламировать маршруты через BGP.

Главное — не построить два независимых control plane, каждый из которых считает себя главным владельцем одного маршрута.

Что резервировать

  • spine и leaf links;
  • BGP route reflectors, если используются;
  • border leaf;
  • OVN Northbound/Southbound databases;
  • gateway chassis;
  • внешние BGP-сессии;
  • DHCP/DNS и metadata services;
  • физические подключения storage и management.

Где это ломается

  • Два control plane рекламируют один и тот же маршрут в разные стороны.
  • EVPN включили, а Type 3/BUM и ARP suppression не проверили.
  • Anycast gateway есть, а north-south всё равно едет в один незарезервированный border leaf.
  • Все RR и контроллеры OVN стоят в одной стойке.
  • MTU фабрики оставили 1500 при VXLAN между leaf.

В следующей части перенесём эти понятия в Kubernetes, где роль endpoints выполняют pods, а выбор между VXLAN, Geneve, IPIP и native routing часто скрыт за одной настройкой CNI.

Предыдущая часть: «Self-hosted mesh: Headscale, NetBird, Netmaker, Nebula, ZeroTier и OpenZiti»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «SDN в Kubernetes: Flannel, Calico, Cilium и OVN-Kubernetes»

Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 9. Предыдущая часть: «Шифрование в SDN: MACsec, IPsec, WireGuard и mTLS».

Срез по продуктам: уровень, NAT/relay, управление, HA.

Список функций mesh-платформ выглядит одинаково: зашифрованная сеть, простое подключение, ACL, DNS, NAT traversal. Различия начинаются после вопросов о data plane, relay и отказе управления. Типы HA и тесты отказа — в части 5; свойства NAT и TCP/443 — в части 7.

Headscale

Headscale — self-hosted реализация control server для клиентов Tailscale. Клиенты используют WireGuard, пытаются построить прямой UDP-путь и при необходимости работают через DERP.

Сильные стороны:

  • знакомые клиенты Tailscale;
  • собственный control plane;
  • ACL и OIDC;
  • возможность своего DERP;
  • сравнительно простая установка.

Ограничения:

  • проект ориентирован на один tailnet, self-hosters и небольшие организации;
  • официально рекомендуется SQLite; PostgreSQL в режиме сопровождения;
  • штатного active-active control plane нет;
  • интерфейсы управления в основном сторонние;
  • DERP — отдельный компонент, его нет внутри бинарника Headscale.

Хороший выбор для лаборатории, небольшой команды и собственной инфраструктуры, если один контроллер с нормальным резервным копированием допустим.

NetBird

NetBird строит L3-сеть на WireGuard. Management управляет узлами, адресами и policies, Signal помогает установить P2P, Relay используется при неудачном прямом соединении.

Плюсы:

  • полноценный self-hosting;
  • web-интерфейс и identity integration;
  • прямой WireGuard data plane;
  • relay с QUIC и запасным WebSocket;
  • несколько relay;
  • маршрутизация сетей за routing peers.

Нюанс HA: Community — один Management. Active-active Management и Signal — Enterprise (PostgreSQL, Redis, NATS). Несколько собственных relay доступны в обеих редакциях.

Netmaker

Netmaker автоматизирует WireGuard между серверами, площадками и пользователями. Он удобен для full mesh и site-to-site, предоставляет gateways, egress и remote access.

Сильная сторона — использование kernel WireGuard и ориентация на производительный L3 overlay.

UDP/443 в конфигурации WireGuard остаётся UDP. TCP/443 у Netmaker — UI, API и служебные каналы, а не универсальный data fallback. При сравнении редакций отдельно смотрят failover, расширенные ACL и observability.

Nebula

Nebula использует собственный зашифрованный UDP overlay, сертификаты и локальный firewall. Lighthouses помогают участникам найти друг друга, но не обязаны пропускать data plane.

Можно указать несколько lighthouses. Для сложного NAT существуют UDP relays. Управление в большей степени файловое и распределённое: нет обязательной тяжёлой панели и центральной базы для каждого изменения.

Это нравится тем, кто предпочитает понятные конфиги и PKI. Обратная сторона — больше собственной автоматизации, а полный запрет UDP не переживается штатным TCP fallback. Несколько lighthouses — это HA discovery, а не HA data plane.

ZeroTier

ZeroTier предоставляет виртуальный Ethernet-порт поверх зашифрованной P2P-сети. Это делает его удобным там, где нужна L2-подобная модель, multicast или подключение приложений, ожидающих обычный сетевой интерфейс.

Для discovery используются публичные root servers (planet). Private moons официально deprecated и для новых внедрений не рекомендуются. Политики применяются распределённо на endpoints. При проблемах с UDP разворачивают отдельный TCP relay через HTTPS — это не тот же механизм, что UDP-ретрансляция через roots.

С версии 1.16 контроллер больше не входит в дефолтные пакеты по умолчанию: self-host control plane возможен, но это отдельное решение по поставке и лицензии.

OpenZiti

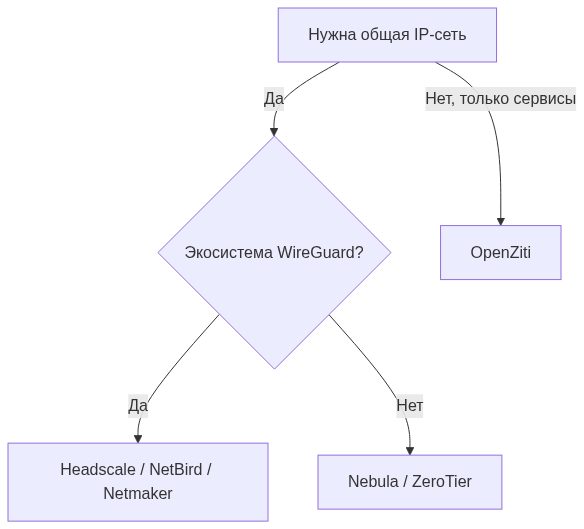
OpenZiti стоит в другой колонке. Он не обязан создавать общую IP-сеть между устройствами. Пользователь или приложение получает доступ к разрешённому сервису через fabric routers.

Есть tun/tproxy intercept, но это не делает OpenZiti IP-mesh в смысле WireGuard.

Преимущества:

  • identity-based policy;
  • сервисы не требуется публиковать в обычной IP-сети;
  • endpoints инициируют исходящие соединения;
  • edge router может использовать TCP/443;
  • контроллеры поддерживают RAFT-кластер.

Цена — более сложная архитектура и иной способ мышления. Это не «быстро заменить WireGuard», а построить сервисный overlay.

Короткая матрица

Решение Модель Оба узла за NAT Relay Data fallback через TCP/443 HA управления
Headscale WireGuard L3 да DERP отдельно от control plane да нет active-active
NetBird WireGuard L3 да да QUIC / запасной WebSocket Community: нет; Enterprise: да
Netmaker WireGuard L3 условно gateway/relay нет штатного TCP data fallback Pro/внешнее
Nebula собственный L3 условно UDP relay нет несколько lighthouses
ZeroTier виртуальный Ethernet да UDP через roots + отдельный TCP relay отдельный TCP relay зависит от схемы
OpenZiti сервисный overlay да fabric routers TCP/443 RAFT-кластер

Полная таблица — в tables/solution-matrix.md. Оценки архитектурные, до лаборатории.

Как выбирать

Небольшой self-hosted tailnet: Headscale.

Современная панель, identity и хорошие relay-механизмы: NetBird.

Производительный WireGuard site-to-site/full mesh: Netmaker, но с проверкой редакции.

Минимум центральной панели и собственная PKI: Nebula.

Нужна виртуальная Ethernet-модель: ZeroTier.

Доступ строится вокруг сервисов и identity, а не общей IP-сети: OpenZiti.

Окончательный выбор делаем не по таблице возможностей, а после лаборатории: два CGNAT, запрет UDP, потеря контроллера, отказ relay и измерение рабочего MTU.

Где это ломается

  • Панель зелёная, а data plane сидит на далёком relay.
  • Community принимают за HA, потому что «есть Postgres».
  • UDP/443 Netmaker записывают как HTTPS fallback.
  • Private moon ZeroTier поднимают как актуальный способ self-host discovery.
  • OpenZiti сравнивают с WireGuard mesh как с взаимозаменяемыми продуктами.

В следующей части те же оси — уровень, VTEP, control plane — появятся в фабрике ЦОД, уже без mesh-панели.

Предыдущая часть: «Шифрование в SDN: MACsec, IPsec, WireGuard и mTLS»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «SDN в ЦОД: spine-leaf, EVPN/VXLAN и OVN»

Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 8. Предыдущая часть: «NAT, CGNAT и ограниченные сети: где заканчивается прямая связность».

Ось: шифрование.

Шифрование — не переключатель «безопасно». Нужно знать границы защищённого участка.

MACsec

MACsec защищает Ethernet между непосредственно соединёнными устройствами на конкретном линке. Это hop-by-hop, а не шифрование всего VLAN.

Он полезен для межкоммутаторных и серверных линков в контролируемой инфраструктуре. Глобальную overlay-сеть и NAT traversal MACsec не строит. На каждом маршрутизируемом переходе граница шифрования заканчивается.

IPsec

IPsec работает на L3. ESP защищает содержимое IP-пакета, tunnel mode добавляет внешний IP-заголовок. IKE управляет согласованием ключей.

Для NAT применяется NAT-T, обычно UDP/4500. IPsec широко поддерживается маршрутизаторами и аппаратным ускорением, удобен для site-to-site и нормативно закреплённых решений.

Цена — сложная матрица режимов, предложений (proposals), сроков жизни ключей, сертификатов и поведения разных вендоров. Когда туннель не поднялся, журнал часто уверен, что администратор уже знает все аббревиатуры.

WireGuard

WireGuard использует компактную модель публичных ключей и UDP. Он хорошо подходит как защищённый L3 data plane между узлами.

Сам протокол не содержит полноценного управления участниками, выдачи адресов, ACL, NAT discovery и relay. Эту часть добавляют Tailscale, Headscale, NetBird, Netmaker и другие системы.

WireGuard не маскирует протокол и не поддерживает TCP mode. Это осознанное архитектурное решение.

mTLS

mTLS взаимно аутентифицирует приложения или сервисные proxies. Защищается конкретное соединение между нагрузками, а решение о доступе может приниматься по identity сервиса, а не IP-адресу.

Это сильная модель для микросервисов и service mesh, но она не заменяет базовую IP-связность. Сначала пакету всё равно нужно добраться до удалённой стороны.

Шифрование поверх overlay

Возможны варианты:

  1. Native routing и WireGuard между узлами.
  2. IPsec между площадками, внутри — обычный VXLAN.
  3. VXLAN/Geneve между узлами и прозрачное WireGuard-шифрование поверх.
  4. Приложение использует mTLS, а межузловой транспорт дополнительно защищён IPsec.

Cilium в tunnel mode сначала помещает pod-трафик в VXLAN/Geneve, затем шифрует межузловой поток WireGuard. Получается двойная инкапсуляция.

В native routing Cilium может шифровать WireGuard без VXLAN/Geneve: тогда налог один, а не два. WireGuard не всегда заменяет tunnel protocol — это отдельный переключатель.

Двойная инкапсуляция работает, но внешний MTU должен вместить оба слоя. Если underlay имеет MTU 1500, MTU нагрузки придётся уменьшить сильнее, чем при одном VXLAN. Цифры накладных расходов — в части 2.

Кто хранит ключи

При ручном WireGuard ключи создаются на узлах, а публичные части распространяются администратором.

В управляемом mesh контроллер хранит или распространяет публичную информацию, policy и сроки действия. Приватный ключ должен оставаться на endpoint.

Нужно проверить:

  • как добавляется новый узел;
  • можно ли быстро отозвать потерянное устройство;
  • как ротируются ключи;
  • что происходит при недоступном identity provider;
  • может ли контроллер выдать peer лишней группе;
  • применяются ли ACL локально с обеих сторон.

Шифрование и наблюдаемость

Внешний firewall видит адреса конечных точек туннеля, объём и время трафика, но не внутренние порты и назначения. Это хорошо для конфиденциальности и неудобно для старых средств анализа.

Наблюдаемость приходится переносить внутрь endpoints: flow logs, eBPF/Hubble, журналы policy engine и метрики туннеля.

Производительность

На современных CPU WireGuard обычно быстр, IPsec может использовать аппаратное AES-ускорение и offload. Но результат зависит от:

  • размера пакетов;
  • PPS;
  • числа участников;
  • ядра и драйвера;
  • наличия GRO/GSO/TSO;
  • NUMA и размещения очередей;
  • двойной инкапсуляции.

Сравнивать только гигабиты в одном iperf3 недостаточно. Нужны ещё PPS, latency, CPU и поведение при нескольких потоках.

Где это ломается

  • «Зелёный замок» в панели, а пакет открыт до VTEP или внутри хоста.
  • MACsec принимают за защиту всей L2-сети, а не линка.
  • Cilium tunnel + WireGuard включают без уменьшения MTU.
  • Приватные ключи оказываются на контроллере или в общем хранилище конфигов.
  • Шифрование путают с политикой доступа: зашифрованный запрещённый поток всё равно должен отбрасываться.

В следующей части соберём эти свойства в продуктовую матрицу и сравним self-hosted mesh-решения.

Предыдущая часть: «NAT, CGNAT и ограниченные сети: где заканчивается прямая связность»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Self-hosted mesh: Headscale, NetBird, Netmaker, Nebula, ZeroTier и OpenZiti»

Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 7. Предыдущая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh».

Ось: underlay с ограничениями (NAT, CGNAT, фильтрация).

Фраза «работает за NAT» звучит уверенно, но описывает слишком много разных ситуаций.

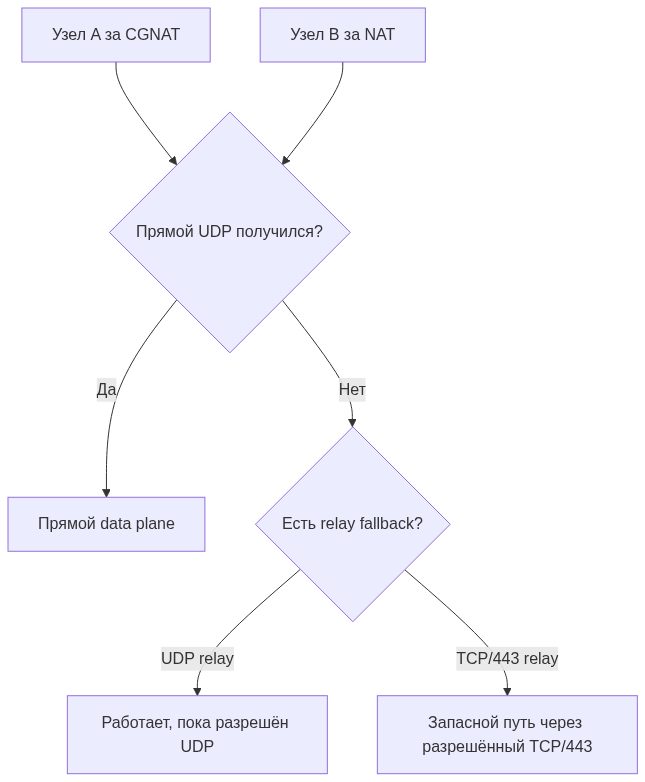
Если сервер имеет белый адрес, а клиент находится за домашним роутером, достаточно исходящего соединения клиента и сохранения NAT mapping. Если оба участника за CGNAT, ни к одному нельзя сделать обычный port forwarding. Если обе стороны находятся за symmetric NAT, внешний порт может зависеть от назначения, и простого обмена наблюдаемыми адресами недостаточно.

Отдельно проверяют hairpin NAT: два узла за одним и тем же маршрутизатором часто не могут достучаться друг до друга по внешнему адресу, пока устройство не умеет возвращать такой трафик внутрь.

Ещё одна ловушка адресации: диапазон 100.64.0.0/10 занят и операторским CGNAT (RFC 6598), и многими mesh — Tailscale и Headscale по умолчанию живут в нём же. Если адреса overlay пересекаются с underlay, маршруты ломаются неочевидно.

NAT mapping и keepalive

Stateful NAT запоминает исходящий поток и временно разрешает обратные пакеты. Когда трафика нет, запись удаляется.

WireGuard умеет отправлять PersistentKeepalive, чтобы mapping не исчезал. Но чистый WireGuard не содержит центрального механизма знакомства двух неизвестных участников, автоматического hole punching и relay. Как минимум одна сторона должна иметь известный достижимый endpoint либо нужен внешний координатор.

Если у узла сменился внешний адрес и он отправил пакет первым, пир WireGuard может обновить endpoint по входящему пакету. Это roaming, а не NAT traversal для двух неизвестных сторон.

STUN, ICE и hole punching

Полезно разделять mapping и filtering — так делает RFC 4787. Hole punching обычно ломается на address-and-port-dependent mapping: внешний порт зависит от назначения. Endpoint-independent mapping при более строгом filtering часто всё же пробивается взаимными проверками.

STUN помогает узлу узнать, какой внешний адрес и порт видит сервер в Интернете. Сам по себе STUN путь не строит. ICE добавляет взаимные проверки связности. Если прямой путь не получается, нужен ретранслятор: в IETF это TURN, в продуктах — DERP, NetBird Relay или отдельный TCP relay.

Controller или signal service обменивает наблюдаемые адреса между участниками. Затем оба почти одновременно отправляют UDP друг другу, создавая подходящие состояния NAT.

При обычном NAT это часто даёт прямое соединение. При address-and-port-dependent mapping — не всегда.

Relay

Если прямой путь не построен, оба участника устанавливают исходящие соединения к публичному relay. Он пересылает уже зашифрованные пакеты и не обязан знать их содержимое.

Relay повышает вероятность связности, но добавляет:

  • дополнительную задержку;
  • ограничение пропускной способности;
  • расходы на сервер и трафик;
  • новую точку отказа;
  • зависимость от адреса и транспорта relay.

Поэтому важно резервировать relay и уметь видеть, какая пара работает напрямую, а какая через него.

UDP/443 не является HTTPS

Номер 443 не превращает произвольный протокол в веб-трафик.

WireGuard на UDP/443 остаётся WireGuard по UDP. Сеть, в которой разрешён только TCP/443, его не пропустит. Межсетевой экран с анализом протокола также не обязан доверять пакету только из-за номера порта.

Настоящий fallback через TCP/443 означает, что data plane умеет работать поверх разрешённого TCP-транспорта — например HTTPS, TLS или WebSocket. Это повышает совместимость с жёсткими egress-правилами, но не гарантирует работу при белых списках, блокировке домена, SNI или адреса сервиса.

Как ведут себя разные семейства решений

Tailscale пытается построить прямой WireGuard-путь по UDP, а при неудаче использует DERP через TCP/443.

Headscale применяет те же клиенты; можно использовать публичные DERP или собственный сервер. Сам Headscale остаётся control plane, а не обязательным транзитом данных и не содержит DERP внутри бинарника.

NetBird использует STUN/ICE для прямых соединений и собственный relay. Основной транспорт relay — QUIC, запасной — WebSocket при недоступном UDP.

Nebula умеет hole punching и UDP relay. Такой relay помогает при сложном NAT, но для его работы UDP всё равно должен проходить.

ZeroTier преимущественно строит P2P по UDP; публичные roots могут и обнаруживать, и ретранслировать. Для сетей без UDP отдельно разворачивают TCP relay через HTTPS — это другой компонент, не «тот же root на порту 443».

Netmaker автоматизирует WireGuard и умеет работать с gateway/relay, но UDP/443 в конфигурации остаётся UDP и не является универсальным TCP fallback.

OpenZiti использует другую модель: endpoints подключаются к публичным edge routers, а трафик проходит через fabric. Это не direct mesh, зато TCP/443 является штатным транспортом edge listener.

Почему нельзя поставить вечную галочку «проходит ТСПУ»

ТСПУ и белые списки применяются неодинаково у разных операторов и в разных регионах. Правила меняются. Могут ограничиваться:

  • весь UDP;
  • отдельные сигнатуры;
  • адреса публичных контроллеров и relay;
  • DNS;
  • SNI или домены;
  • соединения, не соответствующие разрешённому приложению.

Поэтому вместо рекламной галочки нужно фиксировать свойства:

  1. Нужен ли произвольный UDP?
  2. Может ли data plane перейти на TCP/443?
  3. Можно ли поднять собственные контроллер, STUN и relay?
  4. Что продолжает работать после потери контроллера?
  5. Какие адреса и домены обязательны?
  6. Когда, где и на каком операторе проводился тест?

Цель такой проверки — диагностика и обеспечение разрешённой корпоративной связности, а не обещание универсального обхода ограничений.

Наша лаборатория

Каждое решение нужно прогонять через одинаковые профили: оба узла за CGNAT, hairpin за одним NAT, symmetric NAT, полный запрет UDP, только TCP/80/443, отказ основного relay, потеря контроллера, смена внешнего адреса во время SSH-сеанса и PMTUD black hole. Полный список — в программе испытаний.

В итоговой таблице появятся не мнения, а наблюдаемые результаты: прямой путь или relay, время установления, failover, RTT, throughput и рабочий MTU.

Где это ломается

  • «Работает за NAT» проверяли, когда одна сторона была с белым адресом.
  • Symmetric NAT / EDM путают с обычным masquerade; STUN есть, прямого пути нет.
  • Два ноутбука в одном офисе не видят друг друга из-за hairpin NAT.
  • UDP/443 принимают за HTTPS и удивляются при запрете UDP.
  • Overlay-адреса из 100.64.0.0/10 пересекаются с CGNAT оператора.

В следующей части разберём шифрование: от MACsec до WireGuard и mTLS, а также цену двойной инкапсуляции.

Предыдущая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Шифрование в SDN: MACsec, IPsec, WireGuard и mTLS»

Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 6. Предыдущая часть: «Кто управляет сетью: контроллер, BGP и локальные агенты».

Ось: топология.

Топология отвечает не на вопрос «чем шифруем», а на вопрос «через кого проходит пакет».

Point-to-point

Один туннель между двумя площадками. Простая адресация, понятный маршрут, минимум служебного состояния.

Проблемы начинаются, когда появляется третья, десятая и сотая площадка. Ручное добавление каждой пары быстро превращается в отдельную профессию.

Hub-and-spoke

Все spokes подключаются к центральному хабу. Филиалу нужен один или два туннеля, политики сосредоточены в одном месте, легко организовать общий выход и журналирование.

Недостатки:

  • трафик филиал—филиал делает крюк;
  • производительность ограничена хабом;
  • отказ центра влияет на всех;
  • растёт задержка;
  • приходится резервировать не только сервер, но и каналы, адреса и маршруты до него.

Два хаба улучшают ситуацию, но добавляют выбор активного маршрута и риск асимметрии.

Full mesh

Каждый узел имеет прямую связь с каждым. Количество пар:

N × (N − 1) / 2.

Для десяти участников — 45, для ста — 4950, для тысячи — 499 500 потенциальных пар.

Это не обязательно означает полмиллиона постоянно активных сокетов. Современный контроллер может выдавать endpoint и ключи по политике, а data plane поднимать связь при появлении трафика.

Но каждому узлу всё равно нужно знать разрешённых участников, их ключи, адреса или способ запроса этой информации. Масштабируется не только трафик, но и состояние.

Partial mesh

Прямые связи создаются только для реально общающихся групп.

Например:

  • серверы резервного копирования имеют прямые пути к ЦОДам;
  • офисы ходят к приложениям через ближайший региональный хаб;
  • администраторы подключаются напрямую к разрешённым узлам;
  • случайные филиалы не образуют туннели друг с другом.

Partial mesh часто оказывается практичнее полного: меньше состояния и радиус аварии при сохранении прямых путей там, где они дают пользу.

Региональная иерархия

Несколько локальных хабов соединяются между собой mesh или магистралью. Пользователь подключается к ближайшему региону, а межрегиональный трафик проходит по контролируемому backbone.

Такая схема удобна, когда:

  • много филиалов;
  • есть несколько ЦОДов;
  • Интернет неоднороден;
  • нужно локализовать отказ;
  • требуется единая точка выхода в конкретном регионе.

Relay не всегда хаб

Relay может использоваться только тогда, когда два участника не установили прямое соединение из-за NAT или firewall. Остальные пары продолжают общаться напрямую.

Поэтому наличие relay не делает всю сеть hub-and-spoke. Но для конкретной проблемной пары relay временно становится транзитной точкой со всеми последствиями: задержкой, ограничением полосы и требованиями к резервированию.

Кольцо

Кольцевая схема знакома по транспортным сетям, но для программных туннелей используется реже. Она экономит число связей и даёт альтернативный путь, однако увеличивает количество транзитных узлов и усложняет быстрое восстановление без протокола маршрутизации.

Если поверх кольца работает BGP/OSPF и корректно выбирает путь, это уже routed overlay с выбором пути.

Как выбирать

Hub-and-spoke хорош для простого удалённого доступа и централизованного выхода.

Full mesh подходит для небольшого числа равноправных узлов с интенсивным взаимным обменом.

Partial mesh — для большинства неоднородных инфраструктур.

Региональная схема — когда узлов и географии уже достаточно, чтобы один центр стал проблемой.

Решение нужно принимать по реальной матрице потоков. Если из ста площадок девяносто девять ходят только к двум ЦОДам, полный mesh существует главным образом ради красивой схемы.

Где это ломается

  • Хаб становится единственной точкой отказа и узким местом, хотя «все туннели зелёные».
  • Full mesh рисуют для трёх узлов или, наоборот, для тысячи без учёта состояния.
  • Relay стоит далеко и тихо превращает проблемные пары в скрытый hub-and-spoke.
  • Два хаба без продуманного выбора пути дают асимметрию и обрыв сессий.
  • Топологию выбирают по красивой картинке, а не по матрице реальных потоков.

В следующей части добавим NAT, CGNAT и фильтрацию. Именно там выяснится, что нарисованная прямая линия между узлами иногда является пожеланием, а фактический пакет тихо едет через relay.

Предыдущая часть: «Кто управляет сетью: контроллер, BGP и локальные агенты»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «NAT, CGNAT и ограниченные сети: где заканчивается прямая связность»

Схема

#network #selfhosting

Обложка

🔧 Исходные данные

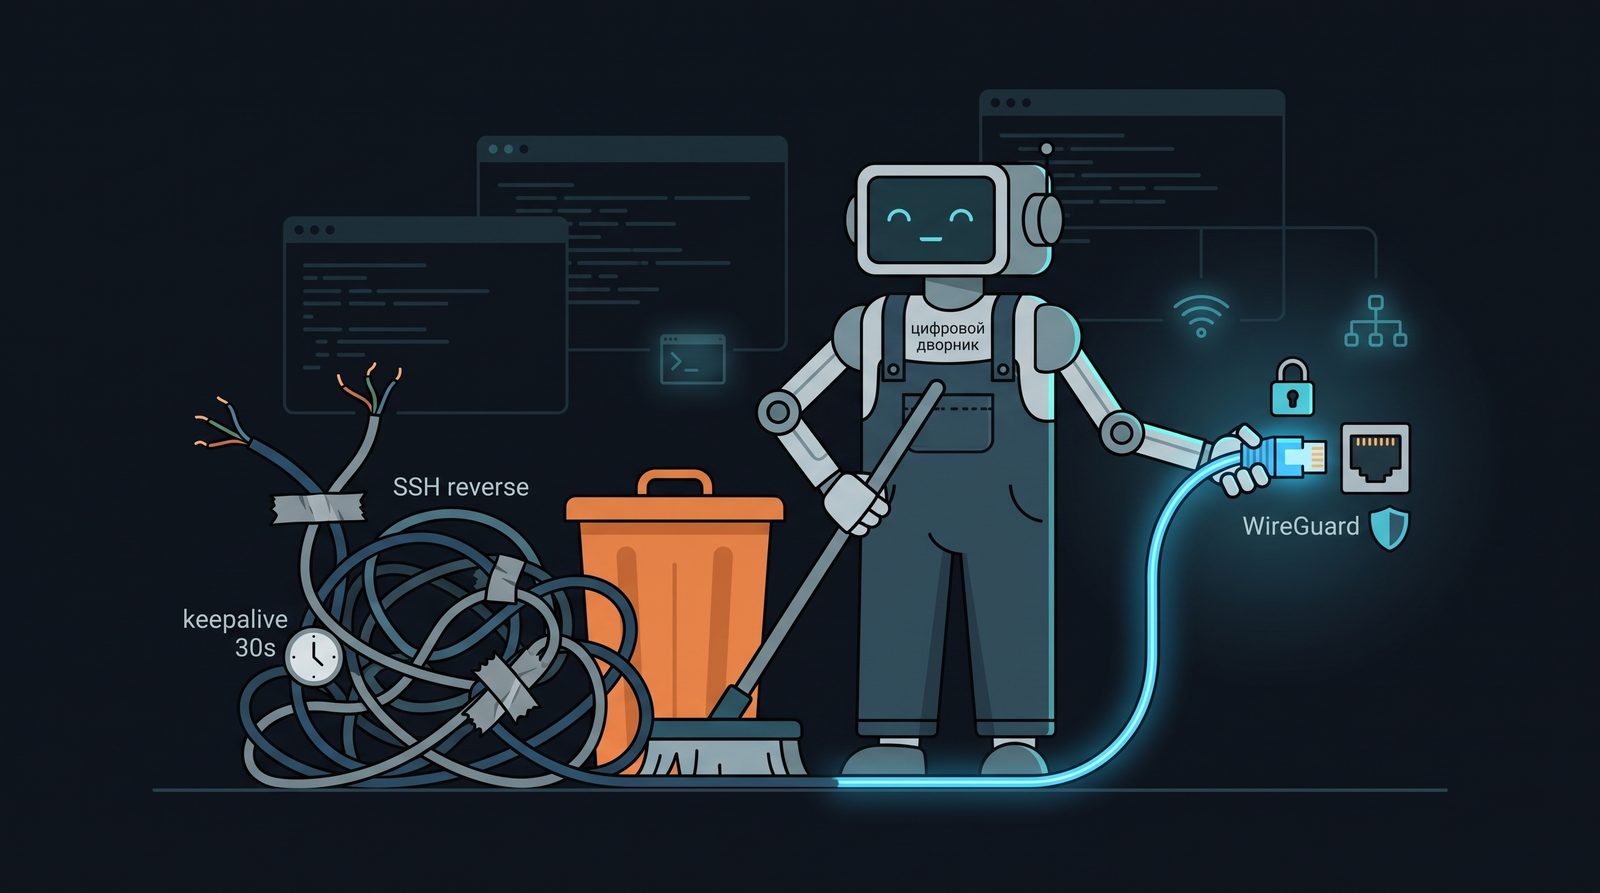
Роутер и сервер у меня в разных сетях: сервер живёт за чужим NAT без белого IP, а у роутера на даче белый IP есть. Все домашние сервисы наружу торчали через SSH reverse-туннель — sshd на роутере, keepalive каждые 30 секунд, dstnat 443→8443 и 8080→8080. Работало, но жило своей жизнью: одно длинное TCP-соединение, которое надо держать живым, ключ от роутера лежит на сервере, а TCP-поверх-TCP на потере пакетов ведёт себя так себе.

Как и что делали

Завёл WireGuard — и упёрся в три грабли.

Грабли 1: интерфейс «есть», а трафика нет. Поднял wg0, handshake 0, пакеты не идут. Оказалось, интерфейс висел без приватного ключа — туннель формально создался, но обменяться ключами не мог.

Грабли 2: wg-quick в LXC падает в segfault. Непривилегированный контейнер без /dev/net/tun. Поднимаю руками через wg setconf + свой systemd-юнит:

wg setconf wg0 /etc/wireguard/wg0.conf
ip link set wg0 up
ip addr add 10.100.0.2/30 dev wg0

Грабли 3: wg setconf не создаёт маршрут до LAN. Туннель поднялся, но до локальной сети за роутером пакеты не доезжали. Добавил маршрут руками:

ip route add 10.0.0.0/24 dev wg0

Отдельный сюрприз — реальные IP клиентов. Снял masquerade на роутере, чтобы видеть, кто стучится, — и всё легло. WG резал входящие пакеты, чей source не в AllowedIPs. Лечение — расширить AllowedIPs до 0.0.0.0/0 и добавить policy-routing, чтобы ответы Caddy уходили обратно в туннель:

ip rule add from 10.100.0.2 lookup 200
ip route add default via 10.100.0.1 dev wg0 table 200

На роутере — peer и dstnat прямо в туннель:

/interface wireguard peers add interface=wg-lab allowed-address=10.100.0.2/32
/ip firewall nat add chain=dstnat protocol=tcp dst-port=443 action=dst-nat to-addresses=10.100.0.2

Что получили

  • SSH-reverse снесён: ни sshd на роутере, ни keepalive, ни dstnat 443→8443/8080→8080
  • Порты на роутере теперь dstnat-ятся прямо в туннель: 443→10.100.0.2:443
  • Сайт отвечает за ~100 мс, реальные IP клиентов видны в логах, ACL работают
  • Один сервис вместо трёх, ноль keepalive, UDP вместо TCP-поверх-TCP

Мораль

WireGuard — это просто, пока не начнёшь. Но когда выкидываешь костыль из трёх сервисов и получаешь один файл конфига — оно того стоит.

А у тебя туннели до сих пор на SSH-reverse, или уже переехал на WireGuard?

#network #selfhosting #openclaw