Кто управляет сетью: контроллер, BGP и локальные агенты
Цикл «Виды связности и SDN», часть 5. Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet».
Ось: управление (control plane).
У SDN есть неприятная особенность: красивая панель управления легко отвлекает от вопроса, кто в действительности пересылает пакет.
Полезно отделять control plane от data plane.
Control plane знает участников, адреса, маршруты, ключи и политики. Data plane принимает конкретный пакет и решает, куда его отправить.
Центральное управление, прямой трафик
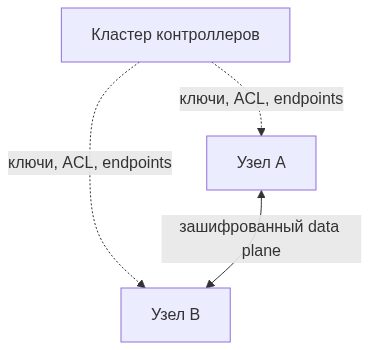
В mesh-системах контроллер часто выполняет роль диспетчера:
- регистрирует узел;
- проверяет пользователя или устройство;
- выдаёт виртуальный адрес;
- сообщает разрешённых участников;
- распространяет публичные ключи и ACL;
- помогает выбрать прямой endpoint или relay.
После этого два узла могут обмениваться зашифрованным трафиком напрямую. Контроллер не видит пользовательских пакетов и не является транзитным хабом.
При его отказе уже созданные туннели могут продолжать работу. Но новый узел не зарегистрируется, изменившийся endpoint не будет распространён, ключи не обновятся, а новая политика не применится.
У самого WireGuard есть исключение: если одна сторона сменила внешний адрес и отправила пакет первой, пир может обновить endpoint по входящему пакету. Это roaming протокола, а не замена контроллера. Когда обе стороны неизвестны друг другу или адрес нужно раздать третьим узлам, без control plane не обойтись.
Один контроллер
Для лаборатории и небольшой некритичной сети это нормальный вариант. Он прост, его легко резервно копировать и обновлять.
Проблема появляется, когда единственный контроллер начинают считать отказоустойчивым только потому, что он работает в виртуальной машине с автозапуском. Перезапуск VM — восстановление, но не всегда HA.
Нужно знать:
- где хранится состояние;
- можно ли поднять второй экземпляр;
- поддерживает ли база конкурентную запись;
- есть ли leader election;
- как клиенты узнают адрес резервного узла;
- можно ли обновить систему без разрыва управления.
Active-standby
Резервный экземпляр запускается после отказа основного или принимает его виртуальный адрес. Такая схема проще active-active, но имеет время обнаружения и переключения.
Если оба экземпляра случайно считают себя основными, можно получить split brain: разные версии политик, адресов и ключей. Поэтому одной репликации базы недостаточно — нужен механизм владения ролью.
Active-active и консенсус
Несколько контроллеров одновременно обслуживают клиентов. Изменения состояния согласуются через общую базу или распределённый журнал.
OpenZiti использует RAFT-кластер. Три контроллера с правом голоса переживают отказ одного, пять — двух. Для записи нужен кворум большинства. Потерявшая кворум часть может сохранить чтение старого состояния, но не должна принимать независимые изменения.
NetBird Community — один экземпляр Management. Active-active для Management и Signal относится к Enterprise: несколько инстансов плюс PostgreSQL, Redis и NATS. Postgres у одного Management высокой доступности не даёт.
Headscale ориентирован на один tailnet и небольшие установки; штатного active-active у него нет. SQLite рекомендован, PostgreSQL поддерживается в режиме сопровождения. Это не делает Headscale плохим, но определяет область применения. Подробнее о продуктах — в части 9.
Распределённый control plane
BGP не требует единого сервера, который знает все маршруты. Участники обмениваются информацией и локально строят RIB/FIB.
Но «распределённый» не означает «без важных центральных элементов». В крупном кластере появляются route reflectors. В EVPN-фабрике важны RR, border leaf и внешние пиринги. Их также нужно резервировать.
Федерация
Несколько площадок могут иметь собственный control plane и обмениваться только частью состояния. Такой подход ограничивает радиус аварии: ошибка одной площадки не обязана немедленно распространяться на все остальные.
Цена — сложнее глобальные политики, адресное планирование и маршрутизация между доменами.
Четыре теста отказа
Для любой SDN-платформы нужно отдельно проверить:
- Продолжается ли существующий поток после потери контроллера?
- Можно ли открыть новый поток между уже известными узлами?
- Можно ли добавить новый узел или распространить изменившийся адрес?
- Что происходит с изменениями ACL и отзывом скомпрометированного устройства?
Ответ «сеть продолжит работать» без уточнения обычно описывает только первый пункт.
Control plane тоже имеет сеть
Контроллеры, базы, brokers, STUN и relay сами зависят от DNS, TLS-сертификатов, маршрутизации и времени. Можно построить отказоустойчивый кластер из трёх узлов и разместить все три за одним маршрутизатором, одним DNS-провайдером и одним внешним IP.
Логическое резервирование не исправляет общую физическую точку отказа.
Где это ломается
- Существующие туннели живы, а новый узел и новая ACL — нет; это принимают за «полное HA».
- Два контроллера без выбора лидера дают split brain.
- Community-редакцию масштабируют «просто Postgres’ом» и ждут active-active.
- Три контроллера в одной стойке и за одним внешним адресом.
- Забывают, что STUN, relay и DNS — тоже control/signalling plane.
В следующей части перейдём от управления к форме сети: hub-and-spoke, partial mesh, full mesh и региональные хабы.
Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet»
Оглавление цикла: «SDN без магии: карта видов связности»
Следующая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh»