Цифровой дворник

Практические заметки о сетях, self-hosting, виртуализации, мониторинге, автоматизации и локальном ИИ.

Telegram: @digclean

Обложка

Сертификат кончился ровно в ночь перед релизом. Сайт лежит, certbot молчит, cron-хук сломался ещё два обновления назад — и ты в три часа ночи лезешь в консоль разбираться, какое именно звено зоопарка отвалилось на этот раз.

Так у меня выглядела жизнь на связке nginx + certbot + cron: три сущности, которые надо кормить, обновлять и чинить, и одна и та же драма каждые 90 дней. В какой-то момент я сформулировал требование предельно просто:

Я устал бояться даты экспирации. Хочу включить и забыть.

Что такое Caddy и почему «один бинарник»

Caddy — современный веб-сервер и обратный прокси, который из коробки умеет авто-HTTPS. Без внешних скриптов и плясок вокруг хуков.

  • Дистрибутив — один бинарник.
  • Никаких зависимостей из репозитория.
  • Конфиг — читаемый Caddyfile.

Это и есть главное отличие от привычной схемы: вместо нескольких пакетов и скриптов, которые надо синхронно поддерживать, у тебя один исполняемый файл и один конфиг.

Врезка: авто-HTTPS

Авто-HTTPS: как Caddy сам выпускает и продлевает сертификаты

Caddy поднимает сайт на HTTPS сразу: сам получает и продлевает сертификаты Let's Encrypt через HTTP-01 или TLS-ALPN челлендж, сам их хранит и обновляет. Никаких моих скриптов, никаких cron-хуков, которые тихо ломаются при очередном апдейте.

Главное — чтобы домен указывал на ваш сервер и порты 80/443 были доступны снаружи (у меня — через NAT на роутере). Дальше всё работает само.

Простой Caddyfile

Ниже — базовый сайт на своём домене и проксирование поддоменов во внутреннюю сеть 198.51.100.0/24. Третий блок заодно показывает простейший ACL: наружу пускаем только офисный адрес, остальным — 403.

example.ru {
  encode gzip
  handle_path /health { respond 200 "ok" }
}

# Поддомен с прокси на сервис во внутренней сети
monitor.example.ru {
  reverse_proxy 198.51.100.14:3001
}

# Базовый ACL (ограничим доступ по IP)
internal.example.ru {
  @from_office remote_ip 203.0.113.250
  handle @from_office {
    reverse_proxy 198.51.100.16:8000
  }
  handle {
    respond 403 "forbidden"
  }
}

Это весь конфиг: домен, поддомены, прокси и правило доступа — без отдельных файлов под сертификаты и без служебных location-блоков для валидации.

Врезка: reverse_proxy на поддомены

Сравнение с «nginx + certbot + cron»

  • Конфиги: читаемый Caddyfile против разнесённых блоков nginx.
  • HTTPS: авто-выпуск и продление внутри Caddy против внешних хуков certbot.
  • Обновления: один бинарник против нескольких пакетов и скриптов.
  • Ошибки: меньше движущихся частей — меньше мест, где можно выстрелить себе в ногу.
  • Логи и метрики: встроенные JSON-логи, экспорт в любимый стэк.

Грабли и как их обойти

Переезд не бесплатный — пара мест, где легко споткнуться, всё же есть.

  • Реверс-прокси за NAT: пробросьте 80/443 на Caddy, тогда HTTP-01 пройдёт. Если 80-й занят — используйте TLS-ALPN на 443.
  • Проверка валидации: убедитесь, что запрос на проверку домена реально доходит до Caddy (особенно если трафик идёт через туннель на роутер), иначе выпуск сертификата молча упадёт.
  • Адреса в правилах доступа: в ACL держите только диапазоны-заглушки — 203.0.113.x для WAN и офиса, 198.51.100.x для сервисов, 10.0.x для LAN. Реальные адреса в конфигах и статьях не светим.

Итог

Переключение на Caddy убрало зоопарк и ежеквартальные драмы с продлениями: один бинарник, авто-HTTPS, простой конфиг. Мораль простая — не вешай прод на cron-хуки и собственную память. Если софт умеет сам выпускать и продлевать сертификаты, пусть это делает софт, а не ты ночью в консоли.

Полезное:

#selfhosting #network

Обложка

Третья часть исследования NetFlow и странных деградаций доступа. В первой части мы научились видеть массовый silent SYN-drop на публичных CGNAT. Во второй — разобрались, почему у ТСПУ нет одного сетевого следа: три соединения, 16 КБ и «сибирская блокировка».

Во второй части у нас оставалась неприятная методологическая дыра. NetFlow хорошо показывал, что с публичным egress происходит что-то странное: росли syn_no_ack, короткие flows, появлялись односторонние обращения к контрольным ресурсам. Но сам по себе этот след всё ещё не отвечал на главный вопрос:

ресурс действительно недоступен именно с этого публичного NAT-адреса — или мы просто неправильно интерпретируем телеметрию?

За следующие два дня мы сильно продвинулись именно здесь. К пассивному наблюдению добавили активную проверку: заставляем сам MikroTik устанавливать соединение с конкретного публичного src-address, а затем прогоняем один и тот же набор целей через весь пул SNAT.

И вот здесь картина стала намного интереснее.


Почему обычного curl с сервера недостаточно

Если проверить сайт с отдельного сервера, мы узнаем только, что ресурс в принципе жив. Для нашей задачи этого мало.

За одним edge-роутером может быть несколько десятков публичных адресов, используемых для SNAT. И мы уже видели ситуацию, когда два соседних адреса одного пула ведут себя совершенно по-разному:

NAT A → Google timeout
NAT A → Cloudflare OK

NAT B → Google OK
NAT B → Cloudflare OK

Маршрут тот же. Роутер тот же. Аплинк тот же. Destination тот же. Меняется только исходный публичный IP.

Поэтому проверку нужно выполнять именно так:

один GW
одна цель
одинаковый способ подключения
разные src-address

На RouterOS это можно сделать штатным /tool fetch с явным src-address.


Минимальная проба на MikroTik

В самом простом виде тест выглядит так:

/tool fetch \
    url="http://connectivitycheck.gstatic.com/generate_204" \
    src-address=203.0.113.x \
    duration=2s \
    keep-result=no

Если fetch завершается, путь с этого source IP до цели существует. Если соседний SNAT тем же способом стабильно получает timeout, уже появляется интересная фактура.

Но при массовом прогоне обнаружилась RouterOS-грабля: failed /tool fetch, запущенный через SSH, пишет в лог:

script,error executing script from sshd failed, please check it manually

Когда таких проверок десятки тысяч, лог роутера превращается в мусор. Поэтому рабочий вариант пробы у нас теперь такой:

:do {
    :local x [/tool fetch \
        url="http://connectivitycheck.gstatic.com/generate_204" \
        src-address=203.0.113.x \
        duration=2s \
        keep-result=no \
        as-value]
    :put ("STATUS=".$x->"status")
} on-error={
    :put "WRAP_FAIL"
};
:put "DONE"

as-value + on-error позволяют получить машинно разбираемый результат и при этом не засыпать системный log сообщениями script,error на каждом timeout.

Это мелочь, но именно такие мелочи становятся важными, когда вместо пяти ручных проб запускается сорок тысяч.


Откуда берём публичные адреса для проверки

Мы не хотим тестировать произвольный список адресов из Excel. Скрипт сам забирает с MikroTik две вещи:

/ip address print where disabled=no
/ip firewall nat print detail where chain=srcnat and disabled=no

Дальше строится пересечение:

local = parse_local_ips(addr_raw, wan)
nat_tos = parse_srcnat_tos(nat_raw)
srcs = sorted(local & nat_tos)

То есть в матрицу попадает адрес, который одновременно:

  1. реально присутствует на данном маршрутизаторе;
  2. реально используется в srcnat to-addresses.

Это важно. На первом этапе мы несколько раз пытались проверять NAT, который видели в NetFlow, но которого физически не было на конкретном GW. После перехода на автоматическую инвентаризацию эта путаница исчезла.

Скрипт умеет разворачивать и диапазоны to-addresses=A-B, поэтому вручную перечислять пул не нужно.

Полный рабочий вариант лежит в scripts/mt_cc_full_matrix_probe.py.


403 цели × весь SNAT-пул

Вторую половину матрицы мы собираем из нашего connect-check.

Отдельный скрипт build_cc_probe_urls.py объединяет:

  • resources.conf;
  • встроенный каталог connect-check;
  • captive-check URL разных ОС;
  • DoH/AI/IoT/update/game endpoints;
  • контрольные зарубежные и российские сервисы.

На текущей версии получилось 403 цели.

Дальше для каждого gateway строится декартово произведение:

каждый src-nat × каждая цель

В последнем полном прогоне:

GW SNAT source Проб OK FAIL
ot1 42 16 926 5 934 10 992
ot2 20 8 060 2 834 5 226
ot3 39 15 717 5 736 9 981
Всего 101 40 703 14 504 26 199

То есть одним запуском мы получаем не «у меня не открылся сайт», а полноценную матрицу:

             NAT-1   NAT-2   NAT-3   NAT-4  ...
T-Банк         FAIL     OK      OK     FAIL
PyPI             OK     OK    FAIL       OK
Azure portal   FAIL   FAIL      OK     FAIL
Google 204     FAIL     OK      OK       OK
...

Результат дописывается в matrix.tsv по мере выполнения. Если процесс прервался, скрипт читает уже готовые пары (src,url) и продолжает с оставшихся. Поэтому сорокатысячный прогон не приходится начинать заново после каждого SSH timeout или рестарта.


Самое ценное — не FAIL, а Selective FAIL

Грубая статистика 26 тысяч FAIL из 40 тысяч сама по себе почти бесполезна.

В каталоге есть цели, которые плохо подходят для /tool fetch: UDP/QUIC, нестандартные протоколы, endpoints с anti-bot, географическими ограничениями или специфичной HTTP-логикой. Поэтому строка «не работает со всех NAT» ещё ничего не доказывает.

Например, в текущем отчёте есть 225 tags с FAIL на всех 101 source IP. В эту группу попадают YouTube, Telegram, Docker Registry, Apple update endpoints, QUIC-тесты и многое другое. Часть такого результата может быть реальным ограничением, а часть — просто несовпадением метода проверки с протоколом/endpoint.

Гораздо сильнее другой класс результата:

одна и та же цель одновременно FAIL с части SNAT и OK с остальных.

В текущей матрице, например:

Azure portal       FAIL 85 / OK 16
Т-Банк             FAIL 82 / OK 19
Ubuntu archive     FAIL 67 / OK 34
PyPI               FAIL 33 / OK 68
Microsoft          FAIL 24 / OK 77
OpenAI             FAIL 22 / OK 79

Здесь origin точно не может быть просто «мёртв для всех»: в ту же минуту часть наших публичных адресов до него достучалась.

Именно поэтому Selective FAIL стал для нас гораздо более полезной фактурой, чем попытка объявить любой timeout «блокировкой ТСПУ».


Три уровня уверенности

После этих экспериментов мы фактически пришли к трёхслойной модели.

1. NetFlow: AT RISK

Пассивная телеметрия видит необычный сетевой след:

syn_no_ack ↑
short flows ↑
много односторонних соединений
CC-маркеры выглядят нездоровыми

Это повод присмотреться к NAT, но ещё не доказательство недоступности.

2. MikroTik active probe: IMPACT

Тот же destination:

с NAT A → FAIL
с NAT B → OK

Это уже подтверждённая зависимость доступности от source IP.

3. Абонентский connect-check: пользовательская фактура

Если тот же публичный NAT одновременно даёт массовые expected_block=0 failures у реального клиента, мы получаем третью независимую точку подтверждения.

Именно комбинация этих трёх слоёв оказалась намного полезнее любого единственного TSPU_SCORE.


Situation Room: что теперь видно в Grafana

После появления активных проверок мы переделали главный дашборд так, чтобы он показывал не отдельные «аномалии», а состояние всего контура сразу.

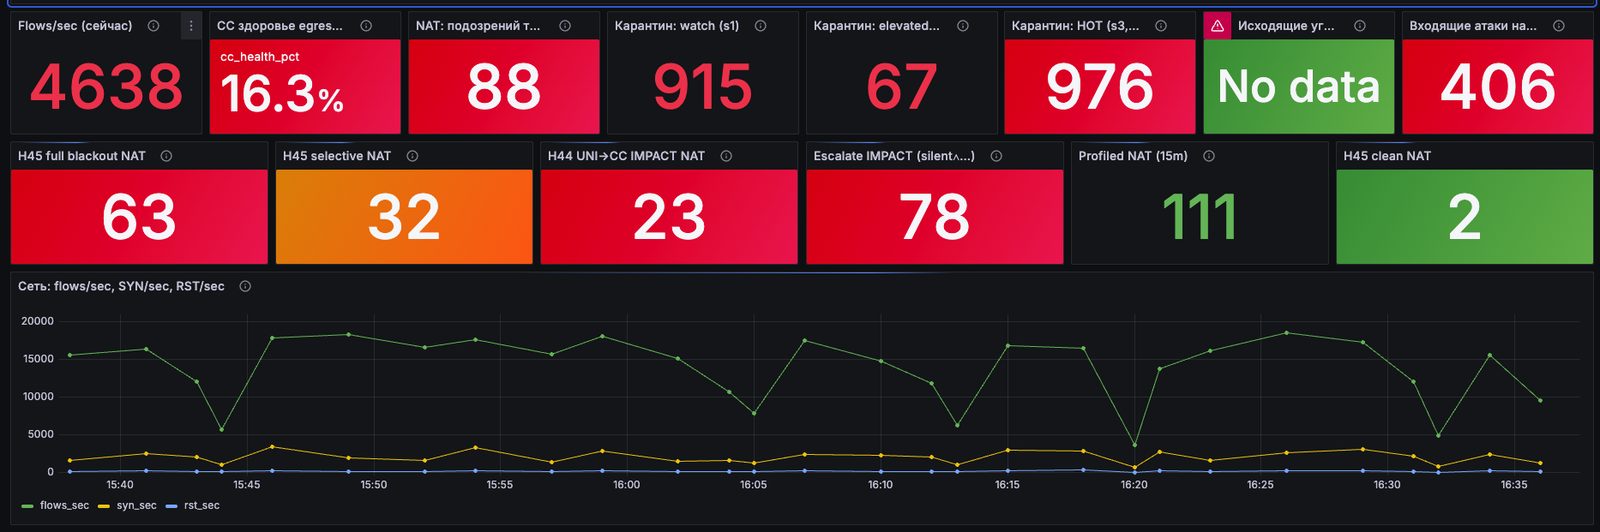
Situation Room — общий вид

Снимок Situation Room. Цифры — состояние конкретного 15-минутного окна, а не постоянные характеристики сети.

На этом снимке сверху видны основные KPI.

Flows/sec

Текущая интенсивность NetFlow. В кадре — около 4638 flows/sec.

Это скорее индикатор того, что измерительный контур жив и какая сейчас нагрузка, чем метрика блокировки.

CC здоровье egress %

На снимке 16.3%.

Очень важно: это не означает, что работает только 16% Интернета.

Сейчас KPI считается как:

cc_healthy_ok / cc_flows_ok

То есть только среди flow, относящихся к whitelist-каталогу connect-check. Раньше знаменателем ошибочно был весь трафик сети, и плитка почти всегда показывала 1–2%, создавая ложное ощущение тотальной катастрофы.

NAT: подозрений тихий дроп

Количество публичных NAT, которые попали под passive-модель silent_syn_drop.

На снимке — 88.

Это именно кандидаты AT RISK, а не 88 доказанно заблокированных адресов.

Карантин: watch / elevated / HOT

Три стадии soft-quarantine для внутренних клиентов:

s1 watch      — наблюдаем
s2 elevated   — повышенный риск
s3 HOT        — сильный/устойчивый источник шума

На снимке соответственно 915 / 67 / 976.

Здесь важно не путать сущности: карантин относится к inside, который создаёт scan/amp/vpn/malware-like активность. Он не означает, что публичный SNAT уже заблокирован.

Исходящие угрозы (NAT)

Число NAT, за которыми есть активные scanner/amplifier/VPN/malware scores выше порога. На конкретном скриншоте панель показывает No data — это не «угроз нет», а отсутствие результата этой выборки в данном кадре.

Входящие атаки на нас

Количество наших публичных активов, которые сами сейчас являются целями внешних scan/amp/malware-паттернов. На снимке — 406.

Эта метрика нужна в первую очередь для того, чтобы не перепутать нашего шумного абонента с атакой снаружи.


H45/H46: отдельный профиль состояния публичного NAT

Вторая строка Situation Room уже ближе к нашему исследованию:

H45 full blackout NAT      63
H45 selective NAT          32
H44 UNI→CC IMPACT NAT      23
Escalate IMPACT            78
Profiled NAT              111
H45 clean NAT               2

H45 full blackout

Плохими выглядят и основные probe-маркеры, и контроль Cloudflare.

В текущей модели маркеры — Google-family, Apple, Quad9, Blizzard. Если хотя бы один маркер достаточно представлен и имеет healthy <=25%, а Cloudflare тоже <=25%, профиль становится full.

Это модель по NetFlow, а не результат полного /tool fetch-прогона.

H45 selective

Маркер выглядит плохо, но Cloudflare остаётся живым либо данных по нему мало.

Именно этот профиль особенно похож на то, что мы увидели активными тестами: один набор destination перестаёт работать с конкретного source IP, другой продолжает открываться.

H44 UNI→CC IMPACT

UNI здесь — устойчивый односторонний трафик к ресурсам из connect-check, когда запросы уходят, но нормального обратного поведения не видно.

Это ещё один независимый passive-сигнал.

Escalate IMPACT

Эта плитка считается жёстче:

silent_syn_drop
AND
(
    CC suspect
    OR full/selective profile
    OR UNI→CC impact
)

То есть одного silent уже недостаточно — NAT должен одновременно подтвердиться ещё одним слоем.

Profiled NAT и clean NAT

Profiled — адреса, по которым в текущем окне вообще хватило маркерного трафика для классификации.

clean — NAT, где Google-family имеет достаточно samples и здоровый процент (>=40%).

На снимке clean всего 2, что само по себе показывает: текущая пассивная модель ещё требует калибровки и не должна использоваться как «истина без активной проверки».


График SYN/RST тоже никуда не делся

Под плитками остаётся базовая временная диаграмма:

flows/sec
SYN/sec
RST/sec

Она нужна для контекста. Если одновременно с ухудшением reachability NAT резко растёт SYN-rate, но RST остаётся почти на нуле, это очень похоже на уже знакомую картину незавершённого handshake и ретраев.

Но теперь мы не пытаемся по одному этому графику сказать «это ТСПУ». График только объясняет, какой сетевой след сопровождает подтверждённый active-probe FAIL.


Drill-down: из плохого NAT — к конкретному inside

Ниже Situation Room появились две таблицы.

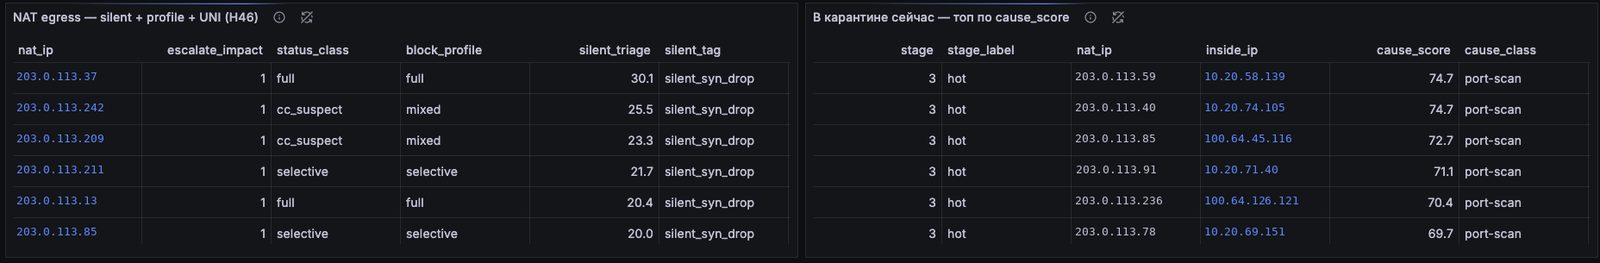
NAT egress и виновники внутри NAT

Таблица NAT egress — silent + profile + UNI

В ней сводится всё, что известно про публичный адрес:

Поле Что означает
nat_ip публичный SNAT
escalate_impact сработало ли усиленное условие silent AND дополнительное подтверждение
status_class итоговый класс: full, selective, cc_suspect, uni_cc, silent_only, watch
block_profile H45-профиль full/selective/clean/mixed/unknown
silent_triage балл passive-модели тихого SYN-drop
silent_tag текстовая причина попадания в silent-кандидаты
google_healthy_pct здоровье Google-family маркеров
apple_healthy_pct здоровье Apple-маркеров
quad9_healthy_pct здоровье Quad9
blizzard_healthy_pct здоровье Battle.net/Blizzard
cf_healthy_pct контроль Cloudflare
uni_cc_impact найден ли устойчивый односторонний поток к CC-целям
uni_flows сколько таких flows увидели
on_cc_suspect попал ли NAT в connect-check passive suspect
profile_tag человекочитаемое объяснение профиля

Например, строка

203.0.113.37
escalate_impact=1
status_class=full
block_profile=full
silent_triage=30.1
silent_tag=silent_syn_drop

означает не «мы доказали блокировку», а гораздо аккуратнее:

этот SNAT одновременно выглядит как silent-drop по NetFlow и имеет плохой маркерный egress-профиль; его нужно поднять в active probe.

И это принципиально другой уровень аккуратности вывода.


cause_score: кто внутри NAT создаёт шум

Правая таблица отвечает уже на другой вопрос: если NAT плохой или находится под риском, кто именно из внутренних адресов генерирует наиболее подозрительный профиль?

Поля:

stage
stage_label
nat_ip
inside_ip
cause_score
cause_class
cause_tag

cause_score — не «вероятность блокировки». Это сумма нескольких компонентов поведения inside:

scan_comp
+ amp_comp
+ vpn_comp
+ mal_comp

с отдельным p2p_dampen, чтобы обычный BitTorrent не превращался автоматически в «портсканер».

cause_class выбирает наиболее характерный профиль:

port-scan
host-scan
amp-probe
ssh-vpn-fanout
malware-ports
syn-volume
mixed-noise

На текущем снимке самые высокие строки имеют cause_class=port-scan и score около 70–75.

Смысл таблицы очень практический: сначала мы находим плохой публичный NAT, потом проваливаемся внутрь и смотрим, кто за ним создаёт основную аномальную активность.

Но эти два факта специально не склеиваются в причинно-следственное утверждение. Шумный inside может быть причиной риска, а может просто жить за уже деградировавшим адресом. Для доказательства причинности нужен временной эксперимент.


Следующий шаг: не ждать естественного трафика

Пассивная H45-модель имеет фундаментальное ограничение: если с конкретного NAT прямо сейчас никто не обращается к Apple, Quad9 или Google, у нас просто нет samples и профиль становится unknown.

Логичный следующий этап — создавать небольшой контролируемый фон активных проб именно с проблемных NAT.

Не полный прогон 403×101 каждые пять минут — это было бы бессмысленной нагрузкой. Достаточно короткого набора стабильных маркеров.

Например:

control:
  Cloudflare

markers:
  Google generate_204
  Apple
  Quad9
  Battle.net

incident target:
  URL, на котором уже поймали selective FAIL

Когда Situation Room переводит адрес в full/selective/escalate, внешний scheduler может поставить временное задание:

NAT 203.0.113.x
каждые 5 минут
в течение 2 часов
6–10 probe destinations

Каждый результат сохраняем примерно так:

ts, gw, nat_ip, probe, result

И дальше появляется временная шкала:

12:00  NAT A  google FAIL  CF OK
12:05  NAT A  google FAIL  CF OK
12:10  NAT A  google FAIL  CF OK
12:15  NAT A  google OK    CF OK

Это даёт то, чего нам до сих пор не хватало: время входа в деградацию и время восстановления конкретного публичного IP.

Причём такую задачу лучше создавать на jump/collector, а MikroTik оставлять только исполнителем короткого /tool fetch src-address=.... Так мы не раздуваем scheduler на edge и можем централизованно ограничить число одновременных проб.


Как это теперь выглядит целиком

Мы начинали с очень простой схемы:

жалоба
→ смотрим NetFlow
→ видим много SYN
→ наверное, ТСПУ

Сейчас рабочий pipeline уже другой:

NetFlow
  ↓
AT-RISK NAT
  ↓
H45/H44/CC correlation
  ↓
active /tool fetch с того же src-address
  ↓
сравнение с соседним clean NAT
  ↓
если нужно — абонентский connect-check
  ↓
inside attribution по cause_score
  ↓
повторные probes до восстановления

Это заметно скучнее красивой кнопки «Определить блокировку ТСПУ».

Зато гораздо ближе к нормальной инженерной диагностике.


Что мы можем утверждать уже сейчас

После полной матрицы мы достаточно уверенно можем говорить следующее.

Первое. Reachability действительно бывает привязана к конкретному публичному SNAT: один и тот же ресурс одновременно доступен с одних наших адресов и недоступен с других.

Второе. Это воспроизводится не на одном «сломавшемся» MikroTik. Selective FAIL мы получили на нескольких edge, причём набор проблемных NAT у каждого свой.

Третье. Пассивный NetFlow полезен для поиска кандидатов, но заметно переоценивает full/selective, если использовать его без активной проверки. Поэтому silent, H45 и cause_score — это триггеры расследования, а не финальный вердикт.

Четвёртое. Самым сильным операционным тестом оказался не абсолютный FAIL, а дифференциальный:

одна цель
одно время
один GW
NAT A = FAIL
NAT B = OK

Именно его мы теперь хотим превратить из ручного расследования в постоянный автоматизированный контур.


И что всё ещё нельзя утверждать

Даже 40 703 probes не дают нам права написать:

26 199 соединений заблокировал ТСПУ

Мы не видим внутреннего правила фильтра и не знаем причину каждого отдельного timeout.

На результат влияют:

  • сам destination;
  • anti-bot/CDN;
  • географические политики;
  • несовпадение /tool fetch с реальным протоколом;
  • временные сетевые ошибки;
  • DPI/ТСПУ;
  • внешние системы защиты, которые тоже принимают решения по публичному IP.

Но теперь у нас есть способ убрать из уравнения значительную часть этих переменных: одновременно сравнивать несколько source IP на одном и том же пути.

Именно поэтому следующая часть исследования уже не столько про поиск «секретного признака ТСПУ», сколько про нормальную постановку эксперимента.

Мы всё ещё смотрим на тень чёрного ящика.

Просто теперь можем подсветить её сразу со ста разных адресов.


Технические артефакты этой части

Скрипты выложены для скачивания:

mt_cc_full_matrix_probe.py автоматически:

  1. получает локальные адреса MikroTik;
  2. извлекает srcnat to-addresses;
  3. строит допустимый набор source IP;
  4. запускает /tool fetch для каждой пары src × URL;
  5. пишет инкрементальный matrix.tsv;
  6. умеет продолжать прерванный прогон;
  7. строит matrix_summary.csv и fail-rate по каждому SNAT.

Дисклеймер. Это эксплуатационное исследование сетевой доступности на стороне оператора связи. Активные probes выполняются к обычным публичным ресурсам с собственных адресов оператора и используются для диагностики. Наличие source-dependent FAIL само по себе не доказывает применение конкретного правила ТСПУ: вывод делается только как наблюдение сетевого поведения.

#network #monitoring #netflow

Обложка

9 сентября F6 (бывшая Group-IB) опубликовала свежую статистику по утечкам, и СМИ разнесли её с заголовками в духе «Россия оказалась впереди всех по утечкам баз данных». ComNews даже вынес это в лид.

Мне стало интересно, насколько заголовок соответствует самим данным. Забегая вперёд: цифры честные, заголовок — нет.

Что реально сказала F6

Threat Intelligence-подразделение F6 сообщило: за 2025 год и первое полугодие 2026-го обнаружено 326 публикаций баз данных российских компаний, впервые выложенных киберпреступниками, — около 1,175 млрд строк. В отдельном международном отчёте за тот же период — 164 новые публичные утечки из прочих стран. (Ведомости)

ComNews эту часть пересказывает корректно: 326 против 164 — это действительно почти двукратная разница. (ComNews)

Но дальше начинается самое интересное.

Сноска, которая всё меняет

Международный отчёт F6 содержит принципиальную оговорку: данные по России и Беларуси в него не включены — для них существует отдельный ежегодный отчёт. То есть это не «весь мир», а «остальной мир за вычетом РФ и РБ».

И считает F6 не «все утечки в мире», а новые базы, которые аналитики нашли на отслеживаемых ими андеграундных форумах и в тематических Telegram-каналах. Из 164 международных публикаций 91 выложили бесплатно, 73 — на продажу.

Поэтому корректная формулировка звучит так: «на ресурсах, которые мониторит F6, за период обнаружено 326 публикаций российских баз против 164 публикаций из остального исследованного массива». Это далеко не то же самое, что «в России произошло больше утечек, чем во всём остальном мире».

Дыра в цифрах самой F6

И вот тут — самое любопытное. Сложим публичные данные F6 за тот же период.

В годовом отчёте за 2025 (от 2 февраля 2026) F6 писала: 230 публикаций российских баз и более 767 млн строк. (SecurityLab, РБК) В июле сообщила итоги I полугодия 2026: ещё 88 публикаций и 114 млн строк.

Считаем:

  • 230 + 88 = 318, а не 326.
  • 767 + 114 ≈ 881 млн строк, а не 1,175 млрд.

По количеству баз разница ерундовая — 8 публикаций можно списать на позднюю атрибуцию. А вот по строкам — около 294 млн записей, плюс 33% к прежней сумме. Это уже не округление.

Публичного объяснения пересчёта я в материалах F6 не нашёл. Технически такое бывает: Threat Intelligence ретроспективно находит старые базы и относит их к моменту первой публикации — тогда февральский срез 2025 мог быть актуализирован задним числом. Но если так, это стоило бы прямо написать. Сейчас пояснения нет.

Игра со знаменателями

Ещё одна тонкость. ComNews пишет, что Центральная Азия (257 млн строк) — «более трети от общемирового объёма». Внутри глобального отчёта так и выходит: остальной мир — более 600 млн записей, и 257 млн — это за 40%.

Но в этот «общемировой» массив не входят Россия и Беларусь. Добавь туда заявленные 1,175 млрд российских строк — и 257 млн превращаются в жалкие 14–15%. Разные знаменатели, разные проценты, а звучит одинаково.

Что говорят другие источники

Теперь главное: можно ли из данных F6 сделать вывод «Россия — мировой лидер»? Независимые исследования рисуют другую картину.

InfoWatch за 2025 год зарегистрировал в мире 5985 утечек. Распределение: США — 37,6%, Россия — 12,3% (второе место), далее Франция 3,4%, Канада 3,2%, Индия 3,1%. (InfoWatch)

Surfshark считает скомпрометированные аккаунты: за 2025 год в мире их 425,7 млн, и США снова первый — 142,9 млн, далее Франция, Индия, Германия, и только потом Россия. (Surfshark)

И даже внутри России три источника дают три разные цифры за один и тот же 2025 год:

Источник Россия, 2025
F6 230 публикаций / 767 млн строк
InfoWatch 739 инцидентов / 1,343 млрд записей
Роскомнадзор 118 случаев / более 52 млн записей

Это не значит, что кто-то врёт. Они измеряют принципиально разное: РКН — установленные факты компрометации операторов ПДн, InfoWatch — зарегистрированные инциденты, F6 — базы, всплывшие на теневых площадках. Одна выложенная база может быть компиляцией нескольких утечек, содержать старые данные и дубликаты, а реальная утечка может вообще никогда не появиться публично.

Для контраста: Smart Business Alert за I полугодие 2026 насчитал лишь 54 базы и 24,3 млн строк с «актуальностью 2026 года» — против 88 публикаций и 114 млн строк у F6 за тот же период. Разница почти в пять раз по объёму при одном и том же теневом рынке.

Эффект наблюдателя

F6 объясняет высокий российский показатель в том числе геополитически мотивированными атаками. Правдоподобно. Но есть и другая причина, о которой пишут реже.

F6 выросла из Group-IB и исторически глубже всех мониторит русскоязычный криминальный сегмент. Международный отчёт F6 — фактически первый глобальный у компании. Сравнивать 326 в давно и глубоко наблюдаемом рунете с 164 в новой международной выборке некорректно: покрытие России и, скажем, Аргентины или Нигерии у F6 заведомо не одинаковое.

Мнение — не факт

И последнее. Объяснения в духе «в Латинской Америке, Африке и на Ближнем Востоке украсть особо нечего» и «глубокая цифровая экосистема России» — это мнение эксперта Игоря Бедерова, которого цитирует ComNews, а не результат исследования F6. ComNews, к чести, так и подаёт это как цитату. Аналогично связь показателя с конфликтом — правдоподобная гипотеза, но статистика сама по себе причинность не доказывает.

Вердикт

  • Достоверно: в России гигантский теневой оборот украденных баз, и F6 фиксирует аномально много российских сливов на отслеживаемых площадках. Это подтверждают и другие источники.
  • Недоказано: что Россия «впереди всех в мире» по утечкам. Наиболее широкое международное исследование InfoWatch ставит США на первое место (37,6%), Россию — на второе (12,3%).
  • Кликбейт: формулировка «Россия оказалась впереди всех» методологически некорректна — смешивает разные знаменатели и игнорирует сноску F6.
  • Вопрос к F6: почему 230 + 88 превратились в 326, а 767 + 114 млн — в 1,175 млрд? Откуда взялись дополнительные ~294 млн строк? Явного ответа в опубликованных материалах я не нашёл.

Собственно, именно последний пункт мне и кажется самым интересным: не заголовок, а скачок оценки почти на 300 млн строк без объяснения методики. Если будет настроение — разберу по конкретным базам, откуда они взялись.

#security #openclaw

Вышел новый релиз connect-check v1.7.0 — сетевого диагностического инструмента.

Что нового

  • Этап DPI классифицирует тип ограничения: SNI-фильтр (IP жив), IP/CIDR, L4-25 (лимит пакетов сессии / бывший TCP 16-20), QUIC drop, порт-фильтр, DoH vs DoT.
  • Пробы SNI vs IP и L4-25 (ya.ru / Cloudflare / Discord).
  • CLI --only-dpi — только этапы «Сеть» и «DPI».

Пакет GUI-only (без CLI в архиве).

Скачать

Зеркало (если GitHub недоступен):

Оригинал: Релиз v1.7.0 на GitHub

#network #monitoring

Обложка

Вторая часть исследования NetFlow и странных деградаций доступа. Первая часть была про то, как мы вообще научились видеть массовый silent SYN-drop на публичных CGNAT и искать внутри «шумных» абонентов. После неё нашлось несколько новых кусков документации и полевых исследований, которые заставили заметно усложнить модель.

В первой части у нас получилась довольно удобная картинка.

Есть публичный NAT. За ним сидят десятки или сотни абонентов. В какой-то момент часть нормальных ресурсов перестаёт открываться. На edge NetFlow одновременно растёт доля незавершённых TCP-сессий, коротких flows и повторных SYN. RST почти нет.

Мы назвали этот профиль silent_syn_drop и начали искать, кто внутри CGNAT создаёт особенно много новых соединений, destination и портов.

На тот момент это уже было сильно полезнее, чем классическое:

«Пинг идёт, значит у нас всё нормально».

Но почти сразу появилась следующая проблема.

Одинаковая снаружи “тишина” может возникать по совершенно разным причинам.

И вот здесь началась вторая часть исследования.


Сначала важная поправка к первой части

Вчера мы много говорили про short3 — долю flows, в которых было не больше трёх пакетов.

Эта метрика действительно оказалась очень полезной. Когда клиент отправляет SYN, не получает нормального ответа и соединение умирает, NetFlow часто оставляет именно крошечную запись.

Но теперь стало понятно, что опасно превращать short3 в магическую кнопку:

short3 высокий = ТСПУ

Так не работает.

Короткий flow может появиться из-за:

  • SYN без ответа;
  • RST;
  • обычного сканирования;
  • отказа сервера;
  • P2P;
  • firewall;
  • timeout;
  • mid-flow блокировки после уже установленного TCP;
  • и ещё десятка совершенно нормальных причин.

Поэтому во второй части мы начали смотреть не на одну метрику, а на форму события.

И оказалось, что открытые источники довольно хорошо раскладываются минимум на четыре разных класса механизмов.


Четыре разных механизма вместо одного «ТСПУ блокирует»

Для себя мы сейчас используем такую рабочую модель.

Класс Что происходит Что может увидеть NetFlow
A. Списки ЦСУ / protocol block DPI сначала распознаёт протокол, потом ЦСУ формирует IP+port list RST или silent SYN-drop, изменение через минуты
B. AS/CIDR + whitelist + mid-flow направление попадает под ограничение, отдельные домены разрешаются TCP устанавливается, потом поток обрывается примерно на первых килобайтах
C. Session-state / «сибирская» решение зависит от количества соединений к одному направлению/SNI и TLS fingerprint первые соединения живут, следующие замирают; характерный burst по destination
D. Protocol capacity не полный block, а вероятностный drop пакетов деградация, retransmit, длинные/рваные flows вместо чистого бинарного отказа

Это уже совсем другая картина.

То есть вопрос:

«Как выглядит блокировка ТСПУ в NetFlow?»

на самом деле поставлен неправильно.

Правильнее:

«Какой именно класс ограничения мы сейчас наблюдаем?»


Класс A: почему отсутствие RST оказалось вполне нормальным

В первой части мы упоминали реконструкцию документации ТСПУ tspu-docs.

После публикации мы внимательнее прошлись по разделу настройки DPI и нашли очень полезную деталь.

Для блокировки распознанных протоколов там отдельно описан параметр:

send RST off

Причём в тексте прямо сказано, что в проекте он должен быть выключен.

Логика понятная даже без знания внутренностей ТСПУ.

Если фильтр отвечает приложению TCP Reset:

SYN →
    ← RST

клиент немедленно понимает, что соединение не получилось, и может тут же попробовать снова.

Получается очень бодрый генератор новых сессий:

SYN → RST
SYN → RST
SYN → RST
SYN → RST
...

Если же Reset не отправлять, картина другая:

SYN →
     тишина
     timeout

Клиент тоже ретраит, но медленнее.

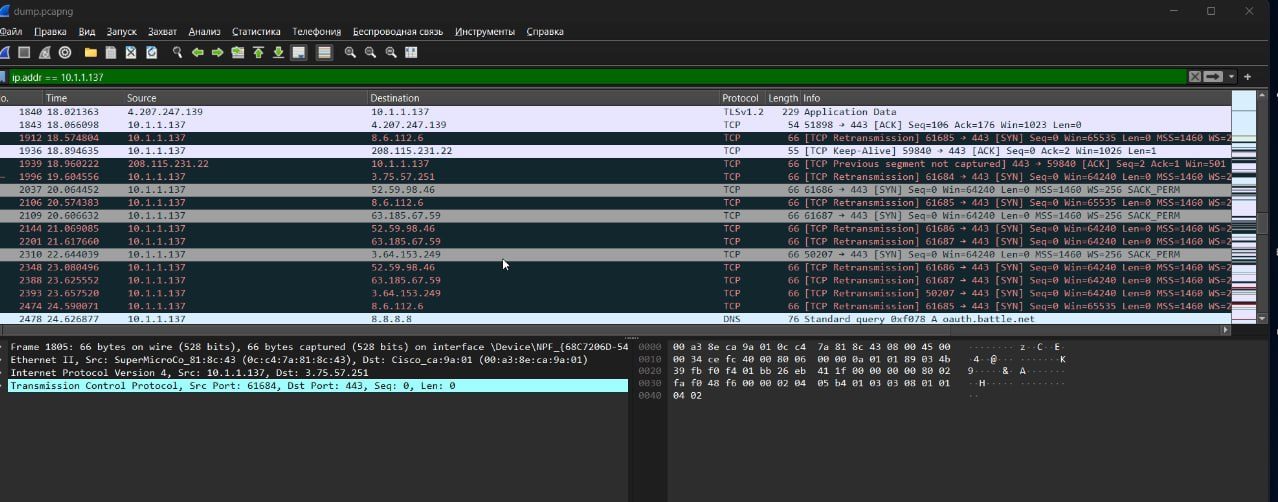
И это практически один в один похоже на то, что мы видели ещё в июне в Wireshark и потом в сентябре на NetFlow: много SYN, много незавершённых flow, RST около нуля.

То есть наш silent_syn_drop перестал выглядеть как «какая-то странность конкретной площадки» и получил вполне разумное архитектурное объяснение.

Но дальше оказалось ещё интереснее.


Ignore сегодня, block через 5–15 минут

В той же открытой реконструкции описана двухстадийная логика протокольной фильтрации.

Сначала DPI-лист работает в режиме распознавания:

behavior = ignore

То есть сессия пока проходит, но факт распознавания логируется.

Дальше:

DPI
  ↓
протокольные логи
  ↓
SPFS
  ↓
ЦСУ
  ↓
анализ и очистка ложных срабатываний
  ↓
IP + port
  ↓
block

Для тестовой зоны в документации указан полный цикл порядка 5–15 минут.

Это очень хорошо объясняет ещё одну вещь, которую раньше было неудобно интерпретировать.

Одно и то же направление может сначала прекрасно работать, а потом внезапно перестать.

Не потому, что «DPI долго думал над одним пакетом», а потому что первая стадия вообще могла ничего не блокировать.

Для нашего исследования это означает, что особенно интересен не момент, когда connect-check уже красный.

Интереснее 10–20 минут перед ним.

Именно там надо искать изменение:

uniq_dst
uniq_dst_port
SYN/sec
flows/sec
burst к конкретному destination

То есть мы немного поменяли идеологию.

Первая часть была в основном про след уже случившейся проблемы.

Вторая всё больше становится про прелюдию.


Класс B: те самые 16 КБ — и почему это не short3

Следующая находка оказалась особенно полезной, потому что она заставила нас не путать две совершенно разные вещи.

В феврале 2026 на Habr вышел большой полевой разбор ограничений на зарубежных CDN и хостинговых сетях.

Наблюдаемый эффект там описывался примерно так:

TCP connect            OK
TLS                    OK
начало передачи данных OK
примерно 16 КБ         STOP

То есть соединение не умирает на SYN.

Оно успевает установиться и передать кусок данных.

По данным автора, ограничения затрагивали целые AS, но внутри них работал белый список отдельных доменов. Из-за этого мог открываться основной сайт, но не грузиться соседний CDN, картинки, обновления или игровые ресурсы на том же хостинге.

Для пользователя выглядит особенно издевательски:

страница вроде начала открываться — и зависла.

Это уже совсем не тот класс, который мы ловили через чистый syn_no_ack.

И здесь важна терминология.

short3 — это число пакетов

У нас:

short3 = packets <= 3

«16 КБ» — это объём до mid-flow cut

Такой flow вполне может содержать:

10 пакетов
20 пакетов
30 пакетов

в зависимости от MSS, ACK, TLS и направления учёта.

Поэтому нельзя сказать:

«16K-блок = short3».

Нет.

Но он всё равно может увеличивать долю коротких по байтам и времени сессий.

После этой находки в нашей модели явно появились отдельные признаки:

bytes_per_flow
packets_per_flow
duration
midflow_10_20k

То есть short3 остаётся хорошей метрикой для half-open/silent класса, а диапазон условно 10–20 КБ становится отдельной охотой за mid-flow cut.

Это, пожалуй, одна из самых полезных поправок ко вчерашнему тексту.


Почему история с 16 КБ важна оператору

Она показывает, насколько плохо обычные проверки описывают реальную доступность.

Например:

ping host        OK
tcp/443 connect  OK
TLS handshake    OK
HTTP headers     OK
скачивание       FAIL после первых KB

Любой мониторинг, который заканчивается на TCP connect, скажет:

всё прекрасно.

А реальное приложение не работает.

Это ещё одна причина, почему в connect-check у нас есть не только connect, но и реальные HTTP/HTTPS операции, скачивание канареек и разные классы сервисов.


Класс C: «сибирская блокировка»

А потом мы вернулись к статье, которую раньше читали скорее как любопытную особенность отдельных операторов.

И оказалось, что она очень хорошо ложится на нашу историю с fan-out и количеством соединений.

В конце 2025 года исследователь описал эффект, который получил название «сибирская блокировка».

В исходном наблюдении примерно 12 TLS-соединений с SNI к одному серверу за короткий промежуток приводили к тому, что новые соединения с тем же отпечатком переставали устанавливаться примерно на две минуты.

Причём TLS без SNI этим эффектом тогда не затрагивался.

Это уже принципиально другая логика.

Не:

IP плохой → drop

а скорее:

кто + куда + сколько раз + какой TLS profile

То есть фильтр хранит состояние.


К июню порог стал заметно жёстче

В июньском исследовании 2026 года описывается уже более агрессивный вариант похожего механизма.

Условие выглядело так:

  • направление относится к «подозрительной» сети/AS;
  • TLS fingerprint входит в интересующий набор;
  • используется один SNI;
  • за последние 60 секунд происходит более трёх быстрых попыток;
  • задержка между ними порядка 350–400 мс или меньше.

После этого новые TLS-попытки к направлению могут «замораживаться» примерно на 120 секунд.

Особенно любопытно, что автор отдельно проверял TCP-порт: по его наблюдениям, конкретный номер порта для этого класса ограничения роли не играл.

Это важный момент.

Мы изначально много смотрели на классические порты:

22
443
500
4500
1194
51820
...

Они всё ещё полезны для понимания поведения абонента.

Но session-rate механизм может быть вообще port-agnostic.

То есть считать только dst_port недостаточно.

Нужны:

src
nat_ip
dst_ip
временное окно
число новых TCP sessions

А SNI в обычном NetFlow у нас, разумеется, нет.


Очень забавная эволюция: 12 → 4

Если положить рядом два полевых исследования, получается интересная картинка.

Конец 2025:

~12 быстрых TLS-соединений

Июнь 2026:

4-е быстрое соединение уже может стать лишним

В актуальной конфигурации проекта dpi-checkers для теста Siberian тоже используется:

siberian-conn-count: 4

Это не означает, что «федеральный порог ТСПУ теперь официально равен четырём».

Такого вывода делать нельзя.

Полевые параметры отличаются между операторами, площадками и датами.

Но нам как оператору сам принцип гораздо интереснее конкретной цифры:

несколько быстрых соединений к одному destination — это отдельный класс сигнала.


И тут наш uniq_dst оказался недостаточен

До этого мы много смотрели на fan-out:

один inside → 500 разных dst

Это хорошо ловит сканеры, P2P и заражённых клиентов.

Но Siberian-подобная логика может сработать на прямо противоположном поведении:

один inside
   ↓
ОДИН dst
   ↓
много быстрых новых sessions

То есть старый показатель:

uniq_dst высокий

может вообще не загореться.

После этого у нас появились отдельные кандидаты:

burst_3_dst
burst_4_dst
rate_per_dst
new_tcp_per_dst

Смысл очень простой.

Нас теперь интересует не только:

«Сколько разных серверов трогает клиент?»

но и:

«Сколько раз он за короткое окно стучится в один и тот же сервер?»


Три TCP нормально, четвёртый — уже нет

В более свежей полевой дискуссии конца августа встретилось ещё более жёсткое наблюдение: два соединения проходят, а на третьем/следующем handshake уже появляется тишина.

Пока мы относим это к категории кандидатов, а не установленной нормы.

Причины простые:

  • это полевой единичный замер;
  • неизвестен точный cooldown;
  • неизвестно, одинаково ли работает на разных площадках;
  • нет смысла объявлять универсальный порог по одному наблюдению.

Но для NetFlow hunt это очень хороший повод поставить пассивный датчик на burst-3 / burst-4.

Не блокировать.

Просто наблюдать.


Мы поставили такой наблюдатель прямо на MikroTik

NetFlow хорош тем, что позволяет смотреть сеть массово.

Но для очень коротких временных burst в несколько сотен миллисекунд минутный агрегат уже грубоват.

Поэтому мы добавили на edge отдельный observe-only слой.

Логика примерно такая:

если один source быстро создаёт
3–4 новых TCP к одному destination
→ записать событие
→ ничего не блокировать

MikroTik отдаёт событие в syslog, а дальше мы связываем его с NetFlow:

MikroTik burst event
        +
NetFlow src/nat/dst
        ↓
ClickHouse
        ↓
кто / какой NAT / какой destination / что было потом

Так появился ещё один важный принцип проекта:

firewall здесь работает не как цензор, а как осциллограф.

Сначала измеряем.

Потом уже решаем, есть ли вообще что ограничивать.


Класс D: оказывается, фильтр умеет не только «разрешить/запретить»

Ещё одна новая находка в документации — protocols capacity.

В открытом описании это шкала от 0 до 100:

0   = полный block
100 = полный pass
1–99 = вероятностный drop

То есть фильтр может не уничтожать сессию целиком, а просто терять часть пакетов распознанного протокола.

Для TCP это даёт совершенно другую внешнюю картину.

Не обязательно:

SYN → тишина

Вместо этого может быть:

handshake OK
часть data OK
loss
retransmit
ещё loss
приложение еле ползёт

И опять пользователь говорит:

«Интернет какой-то мёртвый».

А ping продолжает ходить.

Из этого следует неприятный вывод: бинарный FAIL/OK тоже не всегда достаточно описывает проблему.

Нужны ещё время выполнения, объём переданных данных и профиль retransmission — последние уже лучше смотреть PCAP, а не одним NetFlow.


Вчера у нас был один silent-drop. Сегодня — уже четыре класса

Если сильно упростить, сейчас карта выглядит так.

                         ┌──────────────┐
                         │  жалоба / CC │
                         └──────┬───────┘
                                │
              ┌─────────────────┼─────────────────┐
              │                 │                 │
              ▼                 ▼                 ▼
         SYN не живёт      TCP живёт,       первые sessions
         handshake         data обрывается   живут, потом freeze
              │                 │                 │
              ▼                 ▼                 ▼
        silent / RST        ~10–20 KB         per-dst burst
          class A             class B             class C
              │
              └───────────┐
                          ▼
                    случайный loss
                      class D

Это гораздо полезнее, чем пытаться втиснуть всё в один tspu_score.


Что теперь означают наши метрики

syn_no_ack

Хороший признак того, что новая TCP-сессия не развивается.

Сильнее всего связан с классом A и некоторыми stateful freeze.

short3

Хороший массовый индикатор очень коротких flows.

Но сам по себе не говорит, почему flow короткий.

midflow_10_20k

Новая отдельная гипотеза для класса B.

Ищем соединения, которые успели передать не ноль, а небольшой устойчивый объём и затем закончились/зависли.

burst_3/4_dst

Кандидат на класс C.

Особенно если затем по этому destination у того же egress меняется success rate.

rst_pct

Не выкидываем.

RST-heavy класс у нас уже встречался, просто он оказался не главным.

flows_sec / SYN_sec / uniq_dst

Остаются хорошими показателями общей «шумности» и поиском inside-вкладчиков.


И здесь CGNAT снова делает всё интереснее

Siberian-подобный механизм особенно неприятно выглядит рядом с CGNAT.

Пусть у нас за одним публичным адресом 180 клиентов.

Каждый делает совершенно нормальные четыре HTTPS-соединения.

Для пользователя это ничего необычного.

Но снаружи мы имеем один общий egress.

В зависимости от того, по какому ключу middlebox хранит state, shared IP потенциально может усиливать частоту наблюдаемых сессий.

Мы пока не утверждаем, что конкретная реализация суммирует разных CGNAT-inside именно так.

Для этого у нас нет внутренней телеметрии фильтра.

Но именно поэтому публичный NAT остаётся главной единицей нашего эксперимента.

Мы смотрим:

public NAT
   ↓
симптом
   ↓
какие inside дали вклад

а не наоборот.


Что показал сегодняшний эксперимент с «шумными» inside

После первой части мы попробовали аккуратно проверить ещё одну практическую гипотезу.

Если внутри CGNAT есть несколько источников, которые дают очень большой fan-out, scan/amp-профиль и поток новых сессий — можно ли убрать именно этот шум, не отключая абонента полностью?

Для этого сделали soft quarantine.

Не бан.

Не drop all.

А частичные ограничения на явно аномальную новую активность, при сохранении established и обычного пользовательского трафика.

На пилотном сегменте после применения к небольшой группе самых заметных culprits получили примерно:

общий flows/sec:  530 → 383   (-28%)
SYN/sec:          101 →  62   (-39%)

У нескольких конкретных host-scan профилей fan-out упал на десятки процентов.

У одного источника число destination сократилось примерно:

224 → 79

То есть сама идея «найти шумный inside и подрезать именно шум» работает технически.

Но дальше произошло как раз самое интересное.


Публичный NAT не «очистился» мгновенно

Несмотря на заметное снижение flows и SYN, через несколько минут общий egress всё ещё выглядел как проблемный:

short3 ~82%
cc_healthy ~35–36%

То есть:

снизили шум ≠ мгновенно восстановили доступность.

Это очень хороший результат, даже несмотря на то, что он не такой эффектный.

Он означает, что простая причинная модель:

слишком много SYN
   ↓
block
   ↓
урезали SYN
   ↓
сразу unblock

слишком примитивна.

У состояния может быть cooldown.

Может работать загруженный IP+port list.

Может быть другой класс ограничения.

Может существовать несколько шумных inside сразу.

Может быть вообще внешний rate-limit/CDN reputation, а не ТСПУ.

Именно поэтому мы не делаем автоматический вывод «виновник найден» по одному score.


А потом мы получили очень полезный контрпример

И вот здесь новая фактура заставила нас ещё раз поправить собственную модель.

На одном из публичных SNAT наш NetFlow-детектор уверенно показывал silent_syn_drop:

short3      ~80–82%
syn_no_ack  ~21%
RST         ~1%

То есть по нашим прежним правилам адрес выглядел очень знакомо: много коротких flows, заметная доля незавершённых SYN, почти нет RST.

За тем же SNAT действительно нашлись шумные insides. Один из них выглядел как выраженный port-scan профиль.

Казалось бы, вот он — ещё один «проблемный NAT».

Но мы запустили свежий connect-check с реального CPE за этим egress и получили:

FAIL      2
WARNING  55
OK      464

То есть массовой пользовательской деградации не было.

Из действительно красного — один captive-check и 502 у «Ведомостей». Это вообще не похоже на тот случай, где у клиента разваливается половина Интернета.

Получился очень хороший отрицательный результат.

silent_syn_drop на публичном NAT не равен «абонент заблокирован».

Он означает другое:

на этом egress сейчас есть сетевой профиль, похожий на тот, который мы уже видели около проблемных событий.

Но это пока только риск пула.

Пользовательский impact надо подтверждать отдельно.

После этого мы окончательно развели два слоя.

Слой A — AT RISK

NetFlow говорит:

silent profile
short flows
syn_no_ack
burst/fan-out
шумные insides

Это повод открыть NAT и посмотреть, что с ним происходит.

Слой B — IMPACT

Есть независимая фактура:

connect-check массово красный
жалоба абонента
labeled event
контрольный сервис реально не работает

И только когда эти слои сходятся, можно говорить о подтверждённой деградации, а не просто о «грязном» egress.

Схематично теперь так:

        NetFlow anomaly
              │
              ▼
           AT RISK
              │
       ┌──────┴──────┐
       │             │
   CC healthy     CC broken
       │             │
       ▼             ▼
 наблюдаем       IMPACT
   дальше      расследуем

Это, пожалуй, самая полезная калибровка за сегодняшний день.

Потому что хороший детектор должен уметь не только находить подозрительное, но и не объявлять аварией то, что аварией не является.


И на масштабе всего CGNAT-флота всё оказалось ещё менее линейно

На локальном пилоте soft-quarantine действительно красиво уменьшал SYN и fan-out отдельных culprits.

Но когда ту же идею начали смотреть сразу на большом наборе CGNAT, картинка стала менее фотогеничной и зато более полезной.

В одном из контрольных срезов примерно через час после применения soft-q:

silent NATs:        68 → 83
avg triage:       17.6 → 18.7
sum flows/sec
по silent NAT:    4377 → 3277

То есть суммарный поток в проблемном классе снизился примерно на четверть, а количество NAT с silent-профилем при этом не уменьшилось.

Более того, в коротком окне после применения был красивый провал нагрузки, а потом часть трафика отскочила обратно.

Это ещё раз показывает: нельзя использовать soft-quarantine как лабораторную кнопку

ограничили culprit → значит ТСПУ обязан сразу отпустить IP

Нет.

Мы меняем только то, что контролируем сами — форму исходящего трафика.

А дальше на результат могут влиять:

  • TTL внешнего state;
  • уже сформированный IP+port list;
  • другой шумный inside;
  • session-rate state;
  • CDN/WAF reputation;
  • вообще другой механизм деградации;
  • или просто наши собственные слишком широкие критерии silent.

Именно последний пункт новый connect-check как раз очень хорошо подсветил.

Поэтому KPI soft-quarantine теперь тоже другой.

Не:

«сколько NAT перестали называться silent».

А в первую очередь:

сколько шума убрали
какие culprits перестали fan-out'ить
упал ли SYN/new-conn rate
изменилась ли реальная доступность у клиентов

Это намного скучнее красивого зелёного индикатора «ТСПУ снят».

Зато это уже нормальная инженерия.


Зато теперь у нас появился нормальный эксперимент

Следующий шаг уже можно поставить вполне научно.

Берём публичный NAT с подтверждённым connect-check fail.

Фиксируем:

T0

Дальше:

1. baseline до события
2. per-dst burst
3. fan-out и SYN вклад каждого inside
4. soft remediation culprits
5. CC каждые N минут
6. NetFlow AFTER
7. время восстановления

И повторяем это на нескольких NAT.

После десятка таких экспериментов можно будет уже сравнивать:

класс A: восстановление через X
класс B: восстановление через Y
класс C: cooldown около Z

Сейчас таких данных ещё мало.

Но теперь хотя бы понятно, что именно измерять.


Что мы перестали делать после сегодняшних находок

Мы больше не пытаемся сделать одну формулу вида:

TSPU_SCORE = 0.87

и объявить её истиной.

Вместо этого хотим выдавать оператору классификацию:

A: half-open / silent
B: mid-flow ~16K
C: per-dst session freeze
D: degradation/loss
+ threat context

Причём один NAT может одновременно попасть в несколько классов.

Например, noisy inside может провоцировать session-rate историю, а параллельно часть destination уже находится в списках L3/L4.

Для пользователя это всё сольётся в одну жалобу:

«Не открывается половина Интернета».

Для NOC это должны быть разные сценарии расследования.


Самая важная находка второй части

Наверное, она даже не техническая.

Мы всё время искали «механизм блокировки» в единственном числе.

А его, похоже, просто нет.

Есть набор разных механизмов, которые могут работать одновременно:

DPI protocol recognition
центральные IP+port lists
L3/L4 block на Eco Highway
AS/CIDR ограничения
domain whitelist
mid-flow cut
session-rate state
TLS fingerprint
probabilistic protocol degradation

И у каждого немного другой сетевой почерк.

Поэтому лучший детектор — не тот, который громче всех пишет:

ТСПУ!!!

а тот, который спокойно говорит:

на этом egress:
- TCP handshake массово не завершается;
- RST нет;
- short3 84%;
- burst к одному dst вырос;
- CC expected_block=0 падает;
- основной вклад дают 3 inside;
- началось 7 минут назад.

Это уже информация, с которой инженер может работать.


Куда идём дальше

Следующая итерация у нас теперь довольно очевидная.

Нужно одновременно накапливать четыре типа labeled events и не смешивать их:

  1. half-open / silent;
  2. RST-heavy;
  3. mid-flow 10–20 KB;
  4. per-destination burst/freeze.

А рядом держать контрольные NAT, где похожий трафик есть, а проблемы нет.

И только после этого имеет смысл строить пороги.

Пока все цифры вроде 4 соединения, 16 КБ, 5–15 минут — это не универсальные константы ТСПУ.

Это наблюдаемые параметры конкретных механизмов в конкретных исследованиях.

Именно так мы их и будем использовать.

Не как инструкцию.

Как подсказку, куда направить измерительный прибор.


Вместо заключения

Вчера картина была довольно простой:

много SYN
+
нет ACK
+
короткие flows
=
похоже на silent drop

Сегодня она стала сложнее.

И это хорошо.

Теперь мы знаем, что похожая пользовательская жалоба может означать совершенно разные вещи:

соединение не установилось вообще
соединение оборвалось после ~16 КБ
первые три соединения прошли, следующие замёрзли
протокол просто теряет часть пакетов

Пинг во всех четырёх случаях может быть зелёным.

Поэтому наша исходная идея не изменилась.

Просто измерительный контур стал умнее.

Мы не пытаемся смотреть внутрь чёрного ящика.

Мы смотрим на его тень.

Но теперь уже знаем, что у этой тени несколько разных форм.


Источники и материалы

Первая часть исследования — «Пинг есть. TCP — не очень: как мы учимся видеть след ТСПУ по NetFlow»: https://articles.clr58.ru/netflow-tspu

Предыстория — «Две недели “интернета нет” при зелёных пингах»: https://articles.clr58.ru/dve-nedeli-net-interneta

Наш connect-check: https://github.com/cooler58/connect-check

Открытая реконструкция архитектуры ТСПУ: https://github.com/DanielLavrushin/tspu-docs

send RST off и protocols capacity: https://github.com/DanielLavrushin/tspu-docs/blob/main/chapters/17.md

Двухстадийная схема ignore → ЦСУ → IP+port, цикл ~5–15 минут: https://github.com/DanielLavrushin/tspu-docs/blob/main/chapters/08.md

Habr — «РКН и “сибирская блокировка”»: https://habr.com/ru/articles/1010336/

Habr — «О схеме ограничений РКН в июне 2026-го»: https://habr.com/ru/articles/1044396/

Habr — белые списки AS и эффект ~16 КБ: https://habr.com/ru/articles/997088/

dpi-checkers: https://github.com/hyperion-cs/dpi-checkers


Дисклеймер. Это эксплуатационное исследование сетевых симптомов на стороне оператора связи. Мы не имеем доступа к внутренним решениям ЦСУ/ТСПУ и не утверждаем, что конкретный flow, IP или абонент был обработан конкретным правилом. Полевые статьи и открытая реконструкция документации используются для формирования проверяемых гипотез. Материал не является инструкцией по обходу ограничений.


#network #monitoring #netflow
Обложка

Цикл «Виды связности и SDN», часть 5. Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet».

Ось: управление (control plane).

У SDN есть неприятная особенность: красивая панель управления легко отвлекает от вопроса, кто в действительности пересылает пакет.

Полезно отделять control plane от data plane.

Control plane знает участников, адреса, маршруты, ключи и политики. Data plane принимает конкретный пакет и решает, куда его отправить.

Центральное управление, прямой трафик

В mesh-системах контроллер часто выполняет роль диспетчера:

  • регистрирует узел;
  • проверяет пользователя или устройство;
  • выдаёт виртуальный адрес;
  • сообщает разрешённых участников;
  • распространяет публичные ключи и ACL;
  • помогает выбрать прямой endpoint или relay.

После этого два узла могут обмениваться зашифрованным трафиком напрямую. Контроллер не видит пользовательских пакетов и не является транзитным хабом.

При его отказе уже созданные туннели могут продолжать работу. Но новый узел не зарегистрируется, изменившийся endpoint не будет распространён, ключи не обновятся, а новая политика не применится.

У самого WireGuard есть исключение: если одна сторона сменила внешний адрес и отправила пакет первой, пир может обновить endpoint по входящему пакету. Это roaming протокола, а не замена контроллера. Когда обе стороны неизвестны друг другу или адрес нужно раздать третьим узлам, без control plane не обойтись.

Один контроллер

Для лаборатории и небольшой некритичной сети это нормальный вариант. Он прост, его легко резервно копировать и обновлять.

Проблема появляется, когда единственный контроллер начинают считать отказоустойчивым только потому, что он работает в виртуальной машине с автозапуском. Перезапуск VM — восстановление, но не всегда HA.

Нужно знать:

  • где хранится состояние;
  • можно ли поднять второй экземпляр;
  • поддерживает ли база конкурентную запись;
  • есть ли leader election;
  • как клиенты узнают адрес резервного узла;
  • можно ли обновить систему без разрыва управления.

Active-standby

Резервный экземпляр запускается после отказа основного или принимает его виртуальный адрес. Такая схема проще active-active, но имеет время обнаружения и переключения.

Если оба экземпляра случайно считают себя основными, можно получить split brain: разные версии политик, адресов и ключей. Поэтому одной репликации базы недостаточно — нужен механизм владения ролью.

Active-active и консенсус

Несколько контроллеров одновременно обслуживают клиентов. Изменения состояния согласуются через общую базу или распределённый журнал.

OpenZiti использует RAFT-кластер. Три контроллера с правом голоса переживают отказ одного, пять — двух. Для записи нужен кворум большинства. Потерявшая кворум часть может сохранить чтение старого состояния, но не должна принимать независимые изменения.

NetBird Community — один экземпляр Management. Active-active для Management и Signal относится к Enterprise: несколько инстансов плюс PostgreSQL, Redis и NATS. Postgres у одного Management высокой доступности не даёт.

Headscale ориентирован на один tailnet и небольшие установки; штатного active-active у него нет. SQLite рекомендован, PostgreSQL поддерживается в режиме сопровождения. Это не делает Headscale плохим, но определяет область применения. Подробнее о продуктах — в части 9.

Распределённый control plane

BGP не требует единого сервера, который знает все маршруты. Участники обмениваются информацией и локально строят RIB/FIB.

Но «распределённый» не означает «без важных центральных элементов». В крупном кластере появляются route reflectors. В EVPN-фабрике важны RR, border leaf и внешние пиринги. Их также нужно резервировать.

Федерация

Несколько площадок могут иметь собственный control plane и обмениваться только частью состояния. Такой подход ограничивает радиус аварии: ошибка одной площадки не обязана немедленно распространяться на все остальные.

Цена — сложнее глобальные политики, адресное планирование и маршрутизация между доменами.

Четыре теста отказа

Для любой SDN-платформы нужно отдельно проверить:

  1. Продолжается ли существующий поток после потери контроллера?
  2. Можно ли открыть новый поток между уже известными узлами?
  3. Можно ли добавить новый узел или распространить изменившийся адрес?
  4. Что происходит с изменениями ACL и отзывом скомпрометированного устройства?

Ответ «сеть продолжит работать» без уточнения обычно описывает только первый пункт.

Control plane тоже имеет сеть

Контроллеры, базы, brokers, STUN и relay сами зависят от DNS, TLS-сертификатов, маршрутизации и времени. Можно построить отказоустойчивый кластер из трёх узлов и разместить все три за одним маршрутизатором, одним DNS-провайдером и одним внешним IP.

Логическое резервирование не исправляет общую физическую точку отказа.

Где это ломается

  • Существующие туннели живы, а новый узел и новая ACL — нет; это принимают за «полное HA».
  • Два контроллера без выбора лидера дают split brain.
  • Community-редакцию масштабируют «просто Postgres’ом» и ждут active-active.
  • Три контроллера в одной стойке и за одним внешним адресом.
  • Забывают, что STUN, relay и DNS — тоже control/signalling plane.

В следующей части перейдём от управления к форме сети: hub-and-spoke, partial mesh, full mesh и региональные хабы.

Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh»

Схема

#network #selfhosting

Обложка

Практический разбор операторской сети с IPoE, PPPoE, OSPF и NAT.

Все названия узлов, интерфейсов и IP-адреса изменены. Для примеров используется документационный диапазон 198.51.100.0/24. Сетевая логика и последовательность диагностики сохранены.

Иногда диагностика выглядит почти издевательски. На MikroTik есть маршрут до нужного адреса. OSPF-соседи в состоянии Full. С самого маршрутизатора цель доступна. Но абонент говорит: «не работает», и он тоже прав.

В нашем случае пакет проигрывал не в OSPF, не в firewall и даже не в NAT. Он вообще не добирался до маршрутизатора: CPE решил, что адрес назначения находится рядом с ним в одном L2-сегменте, отправил ARP-запрос и остался ждать ответа.

Разберём по порядку: как к этому привели общая публичная /24, тысячи изолированных VLAN и arp=reply-only, почему помог proxy-arp, какие побочные эффекты у такого лечения — и уже после разбора кейса пройдёмся по всем режимам ARP в RouterOS как по справочнику.

Исходная схема

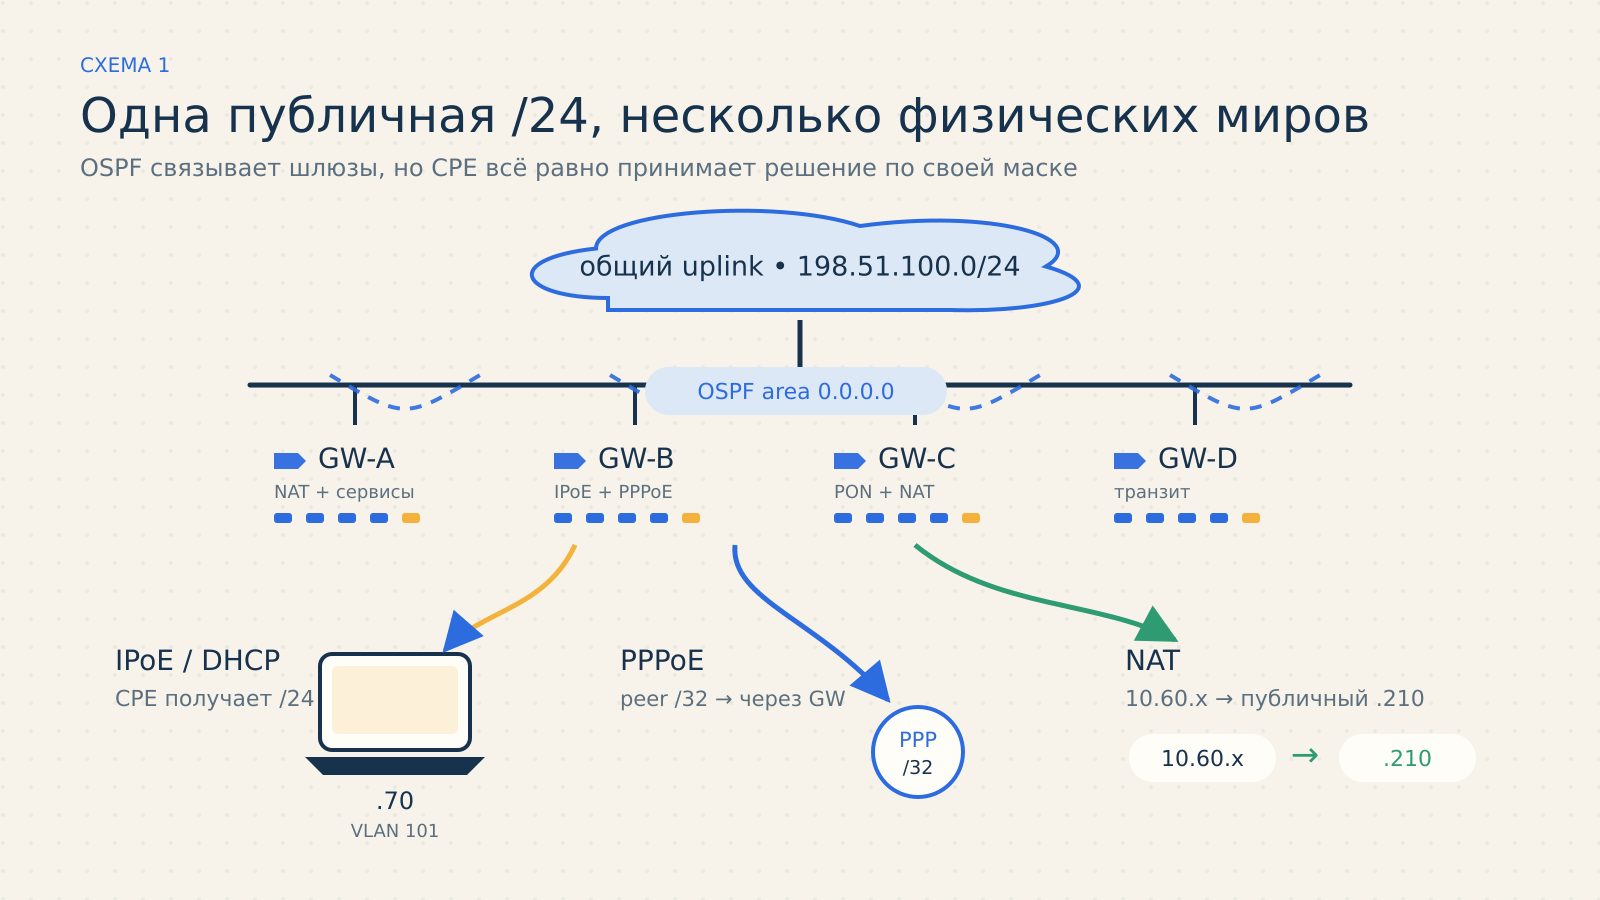
В сети было несколько MikroTik-шлюзов. Между ними работал OSPF, через который распространялись абонентские /32 и другие нужные маршруты.

Одновременно на общей uplink-сети использовался публичный блок 198.51.100.0/24. Адреса из него встречались сразу в нескольких ролях:

  • IPoE-абоненты в отдельных PON/VLAN-сегментах;
  • PPPoE-клиенты с адресом peer /32;
  • публичные адреса на uplink, используемые для src-nat и dst-nat;
  • служебные адреса самих шлюзов.

Упрощённая топология: четыре шлюза, OSPF, IPoE, PPPoE и NAT

IPoE-клиенту DHCP выдавал адрес из этого блока, шлюз и маску /24. Физически соседние адреса могли находиться на разных VLAN и даже на разных маршрутизаторах, но CPE об этом не знал: для него весь 198.51.100.0/24 выглядел одной локальной сетью.

Это и было заложенной миной.

Симптом

Типичная жалоба: IPoE-абонент 198.51.100.70 не пингует 198.51.100.123. На шлюзе при этом виден маршрут 198.51.100.123/32, полученный через OSPF.

Логика инженера понятна:

  1. маршрут есть;
  2. next hop доступен;
  3. значит, пакет должен уйти на соседний GW.

Но CPE с маской /24 рассуждает иначе:

  1. адрес назначения входит в мою локальную сеть;
  2. шлюз мне не нужен;
  3. сначала узнаю MAC-адрес 198.51.100.123 через ARP.

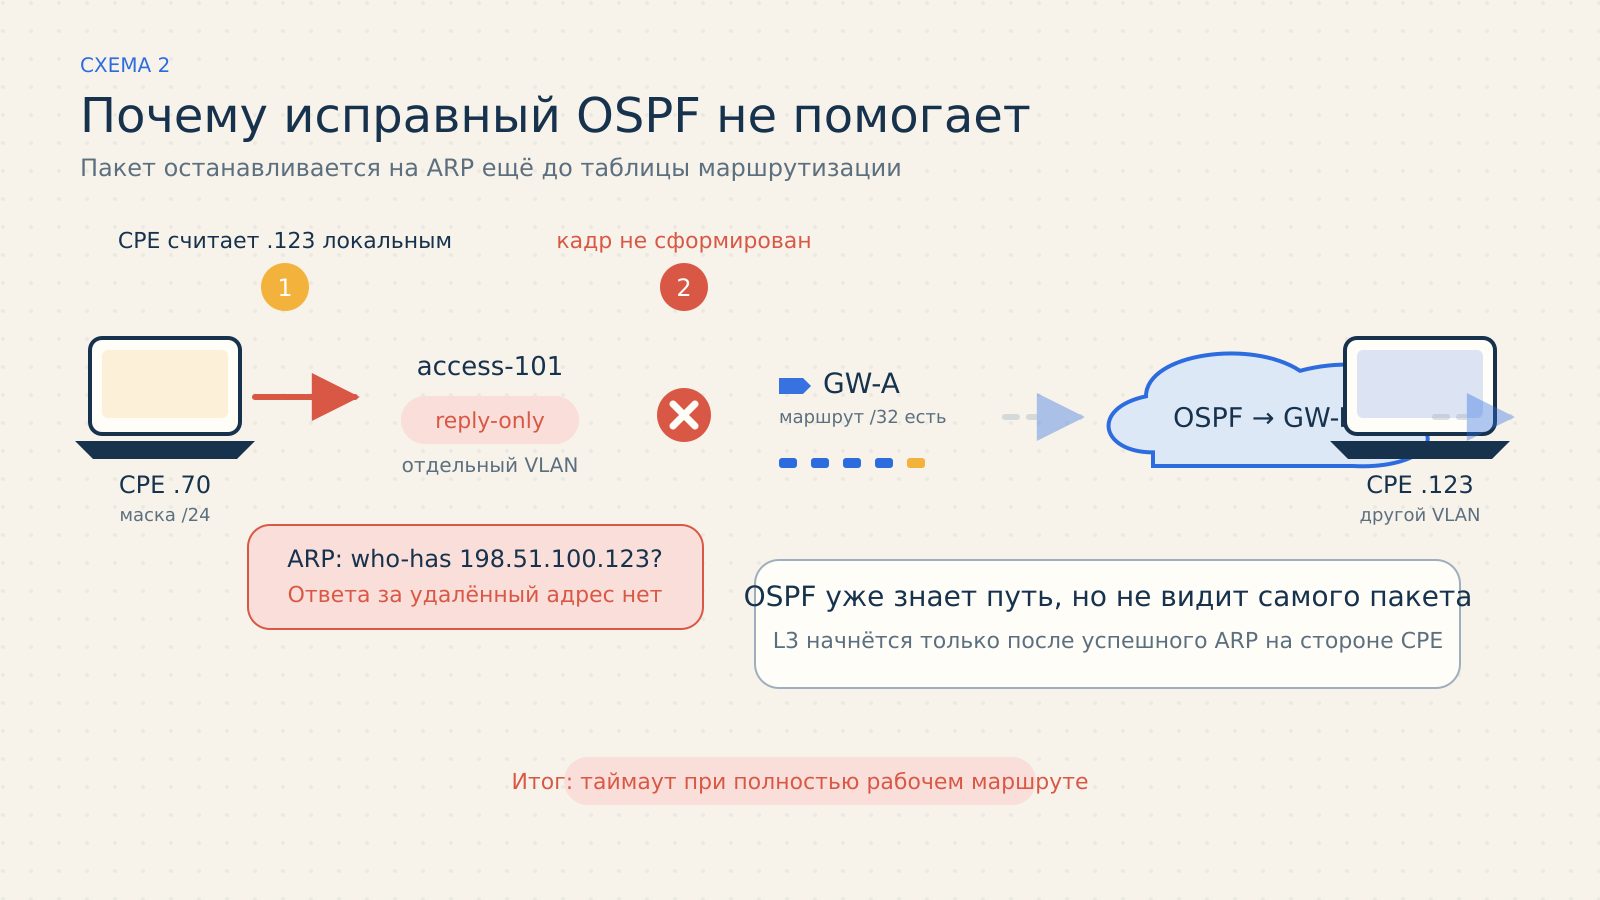
ARP broadcast остаётся внутри абонентского VLAN. Настоящего владельца адреса там нет. Ответить за него мог бы маршрутизатор, но на интерфейсе был включён arp=reply-only.

До исправления: ARP-запрос остаётся без ответа, а OSPF даже не получает пакет

Именно поэтому хороший маршрут не помогал: маршрутизация начинается только после того, как CPE сформировал Ethernet-кадр. Без MAC-адреса назначения кадра нет, IP-пакет не уходит со стороны клиента, и OSPF в этой сцене просто не получает реплики.

Что именно делал reply-only

Тут важна аккуратная формулировка. reply-only — не режим «отвечать только за адрес шлюза». В RouterOS он отключает динамическое ARP-обучение и опирается на заранее заданные соответствия IP/MAC в /ip arp. Такой режим часто используют вместе с DHCP add-arp=yes, чтобы неизвестное устройство не могло свободно подменить адрес.

Но reply-only не делает маршрутизатор ARP-посредником для адресов за другими интерфейсами. Валидный клиент может обращаться к самому шлюзу, однако на ARP-запрос о чужом 198.51.100.x маршрутизатор своим MAC не ответит.

Короткая памятка:

Режим Что происходит Где уместен
enabled Обычное динамическое ARP-обучение Стандартный L2-сегмент
reply-only Работа по статическим IP/MAC-записям, без динамического обучения Контролируемый access с DHCP add-arp=yes или ручными ARP-записями
proxy-arp Роутер отвечает своим MAC за адрес, путь к которому лежит через другой интерфейс Разнесённые L2-сегменты, которым выдали адреса из общего IP-префикса
local-proxy-arp Роутер проксирует ARP между узлами на одном и том же интерфейсе Изоляция клиентов внутри общего интерфейса/сегмента

В нашем кейсе адрес назначения находился за другим интерфейсом, поэтому нужен был именно proxy-arp, а не local-proxy-arp.

Как сработал proxy-arp

Proxy ARP — приём, описанный ещё в RFC 1027: маршрутизатор отвечает своим MAC-адресом на ARP-запросы о тех IP, которые лежат не в этом сегменте, а за другими его интерфейсами, и до которых у него есть маршрут. Хост получает ответ, считает, что цель находится рядом на канальном уровне, и отправляет кадр маршрутизатору. Тот, ничего не меняя в IP-заголовке, делает обычный L3-forwarding.

Важно, что «склейка» происходит не на канальном уровне, а через таблицу маршрутизации: маршрутизатор отвечает не за всё подряд, а только за адреса с активным маршрутом, и только если маршрут указывает не на тот интерфейс, откуда пришёл запрос.

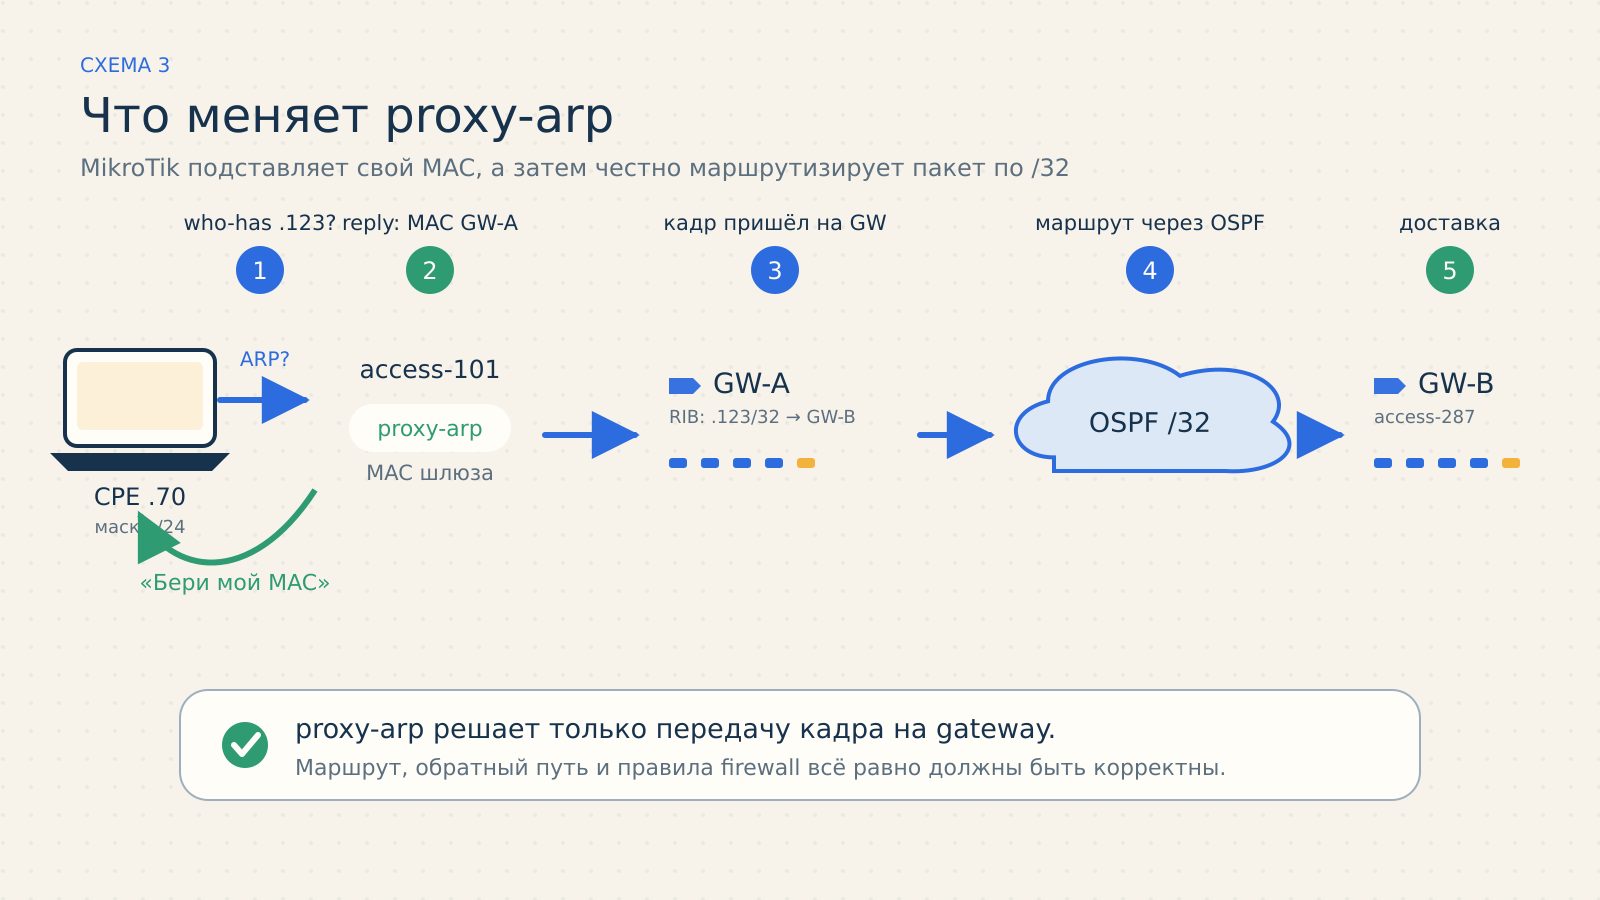
На выбранных абонентских VLAN режим ARP сменили на proxy-arp, и последовательность стала такой:

  1. CPE спрашивает: «Кто такой 198.51.100.123?»
  2. MikroTik проверяет таблицу маршрутизации и видит путь к адресу через другой интерфейс.
  3. Маршрутизатор отвечает собственным MAC.
  4. CPE отправляет Ethernet-кадр на MikroTik, хотя IP-адрес назначения остаётся прежним.
  5. После этого начинается обычный L3-forwarding: маршрут /32, OSPF, соседний GW и нужный абонентский интерфейс.

После исправления: MikroTik отвечает своим MAC и передаёт пакет по маршруту

Пример точечной настройки:

/interface vlan print detail where arp=reply-only
/interface vlan set [find where name="access-101"] arp=proxy-arp
/interface vlan print detail where name="access-101"

Соблазн сразу выполнить что-то вроде set [find arp=reply-only] понятен, особенно когда VLAN несколько тысяч. Но сначала нужно определить, какие интерфейсы действительно относятся к этой модели IPoE: reply-only мог быть включён осознанно как часть защиты IP/MAC, а глобальное переключение изменит поведение всей сети доступа.

Если проксировать нужно буквально несколько адресов, RouterOS позволяет создать точечную опубликованную ARP-запись вместо включения proxy ARP для всего интерфейса:

/ip arp add address=198.51.100.123 interface=access-101 published=yes

Устройство ответит за этот IP только при наличии активного маршрута до него. Для тысяч динамически размещённых абонентов такой способ быстро превращается в отдельную систему учёта, но для единичного сервисного адреса он бывает аккуратнее — и, что важно, не отменяет reply-only для остальных адресов сегмента.

Перед массовой правкой стоит:

  • сохранить export и список исходных ARP-режимов;
  • отобрать интерфейсы по понятным именам, спискам или комментариям;
  • проверить один тестовый VLAN;
  • убедиться, что фильтры forward по-прежнему обеспечивают нужную изоляцию абонентов;
  • подготовить обратное переключение для каждого изменяемого интерфейса.

Что получилось после изменения

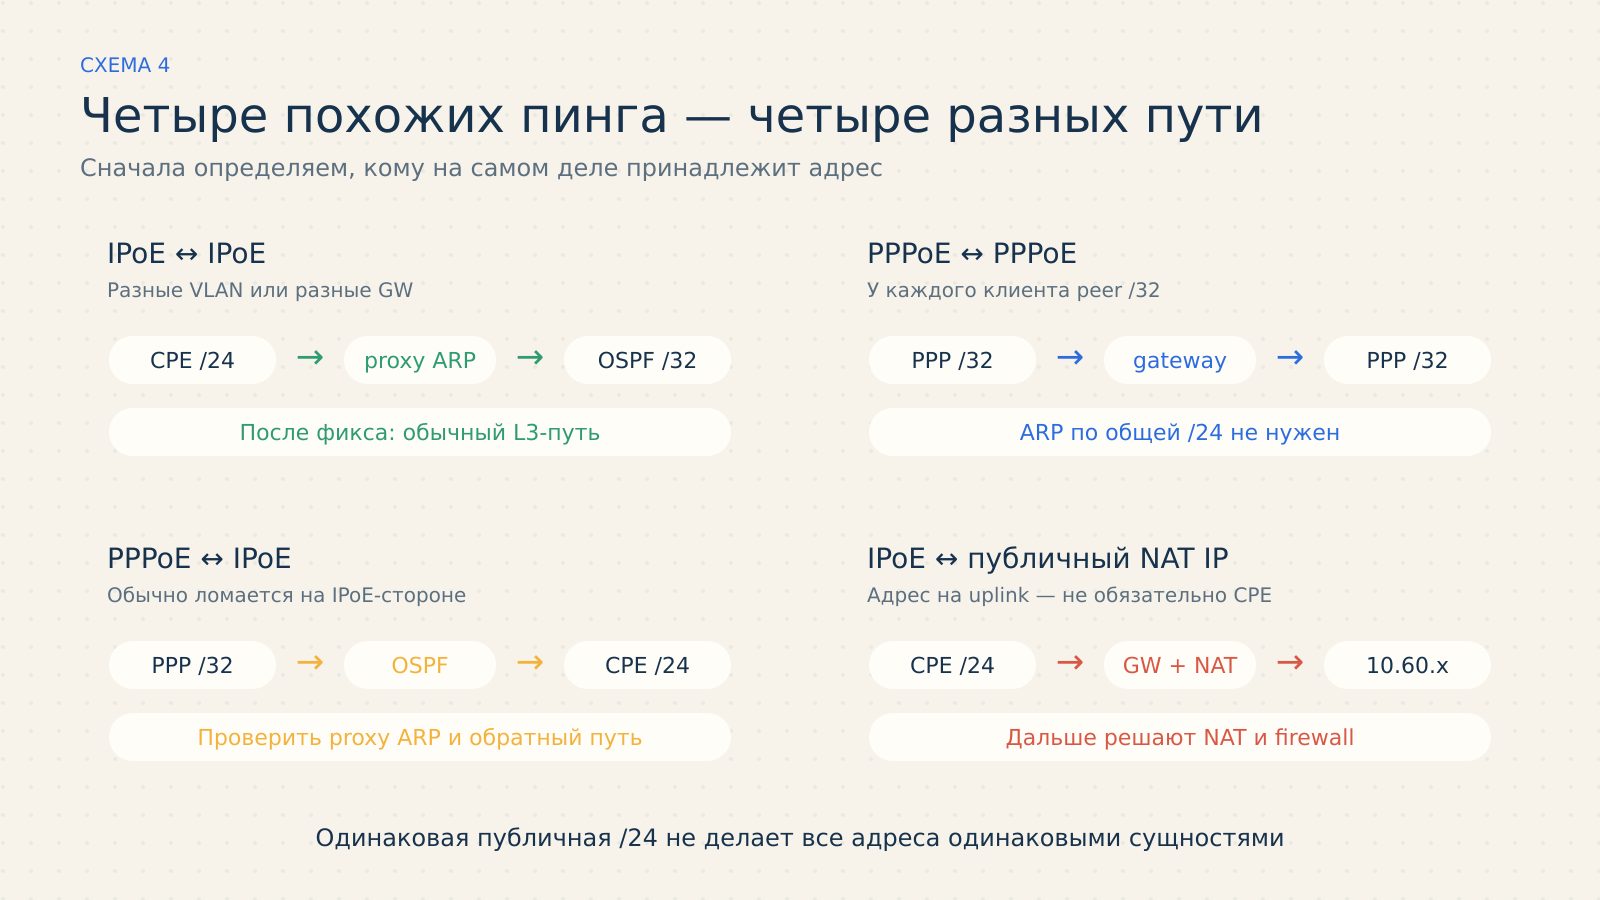
Сценарий До После proxy-arp на IPoE-VLAN
IPoE ↔ IPoE, разные VLAN/GW CPE ждёт ARP, пакет не доходит до GW CPE отправляет кадр на MAC шлюза, дальше работает L3
PPPoE ↔ PPPoE Обычно работало через peer /32 По сути без изменений
PPPoE ↔ IPoE Часто ломался обратный путь на стороне IPoE Работает при корректных маршрутах и firewall
IPoE ↔ публичный NAT IP Выглядело как поломка связи двух абонентов ARP-часть исправлена, но результат всё ещё зависит от NAT/firewall

Последняя строка таблицы — не формальность: именно на ней разбор чуть не увёл в неверную сторону.

Ловушка: адрес выглядит абонентским, но это NAT

Во время разбора попалась пара адресов, которая сначала казалась идеальным тестом:

  • 198.51.100.70 — настоящий IPoE-клиент на одном GW;
  • 198.51.100.210 — «белый IP», который ожидали увидеть у другого абонента.

Но второй адрес оказался назначен uplink-интерфейсу другого маршрутизатора и использовался как внешний адрес для NAT частного пула. Никакого CPE с адресом .210 не существовало.

Это меняет смысл проверки. Пинг «абонент ↔ абонент» внезапно становится проверкой «IPoE-клиент ↔ адрес самого GW или сервис за dst-nat», а результат зависит уже от правил NAT, firewall и того, есть ли вообще трансляция для ICMP.

Четыре разных сценария, которые снаружи выглядят как связь между адресами одной /24

Поэтому перед выводом «абоненты друг друга не видят» полезно установить владельца каждого IP:

/ip address print detail where address~"198.51.100.210"
/ip arp print detail where address=198.51.100.210
/ppp active print detail where address=198.51.100.210
/ip firewall nat print detail where dst-address~"198.51.100.210"

А затем проверить, есть ли для него host route и где он был получен.

При чём здесь OSPF

OSPF в этой истории не был причиной поломки — он лишь доставлял между шлюзами информацию о том, где находится конкретный абонентский /32. Но чтобы proxy-arp заработал, должны выполняться два условия:

  • нужный /32 действительно должен присутствовать в RIB/FIB выбранного MikroTik;
  • маршрут должен указывать через другой интерфейс, иначе обычный proxy-arp не решит задачу.

Для RouterOS v7 маршрут удобно смотреть так:

/routing route print detail where dst-address=198.51.100.123/32
/routing ospf neighbor print detail

В RouterOS v6 таблица маршрутов проверяется через:

/ip route print detail where dst-address=198.51.100.123/32

Если /32 не анонсируется, соседство застряло в ExStart/Exchange или маршрут отфильтрован, proxy-arp проблему не исправит: он помогает клиенту передать пакет маршрутизатору, но маршрут до цели всё равно должен существовать. Это прямое следствие механики режима — решение об ARP-ответе принимается по таблице маршрутизации, поэтому пустая FIB означает тишину в ответ на who-has.

Практический порядок диагностики

Из всего этого сложилась рабочая последовательность.

1. Проверить логику CPE

Посмотреть выданную маску. Если клиент получил /24, он будет ARP-ить любой адрес из этой /24, даже если оператор разнёс адреса по разным VLAN.

2. Посмотреть ARP на access-интерфейсе

/interface vlan print detail where name="access-101"
/tool sniffer quick interface=access-101 mac-protocol=arp

Характерный симптом: от CPE приходит who-has, но ответа за удалённый адрес нет.

3. Проверить маршрут до точного адреса

Смотреть нужно не только общий connected /24, но и специфичный /32. Иначе трафик может уйти на общий uplink или не к тому GW.

4. Установить реального владельца IP

Адрес может принадлежать IPoE-клиенту, PPP-сессии, интерфейсу маршрутизатора, NAT-пулу или вообще быть свободным. Одинаковая запись в заявке «белый IP» ещё не означает одинаковую сетевую сущность.

5. Проверить OSPF и обратный путь

Соседство должно быть Full, нужный /32 — установлен, а обратный маршрут — симметричен или хотя бы допустим правилами firewall и rp-filter.

6. Только после этого включать proxy-arp

Сначала на одном VLAN, затем на небольшой группе, и лишь потом — массово. После изменения проверяются ARP, ping, TCP-сессия и счётчики firewall в обоих направлениях.

Как устроен proxy ARP: режимы RouterOS

Кейс на этом закрыт. Дальше — справочная часть: что именно RouterOS делает с ARP в каждом режиме и почему в нашей ситуации выбор был безальтернативным.

Начать стоит с логики хоста. Собираясь отправить IP-пакет, он сначала решает, «локальный» адрес назначения или нет: применяет свою маску к своему и к целевому адресу. Если адреса попали в одну подсеть, шлюз не используется вовсе — хост рассылает широковещательный ARP-запрос who-has и ждёт, кто отзовётся своим MAC. Ethernet-кадр без MAC назначения не собирается, поэтому при отсутствии ответа никакого IP-трафика просто не появляется.

Proxy ARP в RFC 1027 прямо называли «ARP-хаком» для подсетей: механизм придумали для стеков, которые не умели работать с подсетями. Живёт он ровно по той же причине, что и в нашем кейсе: адреса одной подсети оказались разнесены по разным линкам, VLAN или тоннелям, а хосты об этом не знают. Побочный эффект хорошо видно в ARP-таблице клиента: десятки разных IP там отображаются на один и тот же MAC шлюза.

Теперь по режимам, которые RouterOS позволяет задать на интерфейсе (подробности — в официальной документации по ARP):

  • enabled — поведение по умолчанию. Маршрутизатор отвечает на запросы о своих адресах, сам рассылает who-has, когда нужно, и динамически учит соответствия IP/MAC. Подходит для обычного доверенного сегмента: серверная сеть, офисный LAN, транзитный линк.
  • disabled — ARP на интерфейсе не работает совсем: ни ответов, ни обучения. Связность возможна только со статическими записями в /ip arp с обеих сторон. Применяется в жёстко зафиксированных схемах и на линках, где ARP не нужен по своей природе (PPP-подобные точка-точка).
  • reply-only — компромисс между контролем и удобством: динамического обучения нет, маршрутизатор работает исключительно по статическим и добавленным DHCP-сервером записям. Отсюда и связка с параметром add-arp=yes: клиент получил адрес по DHCP — запись появилась; сменил IP или MAC вручную — не общается ни с кем. Это ровно тот режим, который и стоял на наших access-VLAN.
  • proxy-arp — маршрутизатор дополнительно отвечает своим MAC за адреса, достижимые через другие интерфейсы. Именно этот режим нужен, когда хосты одной подсети физически раскиданы по разным сегментам, а переделать маску на всех CPE нельзя.
  • local-proxy-arp — маршрутизатор проксирует ARP между узлами того же интерфейса: клиент A спрашивает про клиента B, находящегося в том же VLAN или бридже, и получает MAC шлюза, после чего весь трафик между ними идёт через маршрутизатор. Так делают, когда на L2 включена изоляция портов (bridge horizon, PON client isolation), но соседи всё же должны видеть друг друга — уже под контролем firewall и учёта.

Разница между двумя proxy-режимами — исключительно в том, где находится цель: за другим интерфейсом или в том же сегменте. Подменить один другим не получится, это отдельные значения параметра, и на интерфейсе действует одно из них. Соответственно, включая proxy-arp, вы отказываетесь от строгости reply-only на этом интерфейсе, и защиту от подмены адресов приходится переносить на DHCP snooping, ACL и firewall.

Когда proxy-arp полезен

Несмотря на репутацию «костыля», у режима есть сценарии, где он не просто работает, а является наиболее логичным решением.

  • Адреса одной /24 разнесены по разным VLAN и интерфейсам, а CPE считает их локальными — наш случай. Клиент никогда не отправит пакет шлюзу, потому что по своей маске он «уже дома»; единственный способ вклиниться в этот диалог — ответить ему на ARP.
  • Тоннели и мосты, где удалённая подсеть должна выглядеть локальной. Через EoIP, GRE или IPIP приходят адреса того же префикса, и хостам на одной стороне нужно ARP-разрешать адреса другой; proxy ARP позволяет не растягивать broadcast-домен и не поднимать полноценный L2-мост, оставив стык на маршрутизации.
  • Быстрое восстановление связности без миграции адресации. Переразметка сети с /24 на per-subscriber /32 — это проект на недели, с перевыпуском DHCP-опций и правкой профилей; включение proxy-arp на нужных интерфейсах возвращает сервис за минуты и не требует прикасаться к абонентскому оборудованию.
  • Единичные «белые» адреса и сервисы для устройств с зашитой маской. Старый принтер, терминал или контроллер с жёстко прописанными адресом и /24 физически не умеет ходить через шлюз к соседнему префиксу; proxy ARP (а лучше — точечная опубликованная ARP-запись) делает такой адрес достижимым, не требуя перенастройки самого устройства.
  • Ситуации, где local-proxy-arp не подходит. Если цель находится за другим интерфейсом, а не среди соседей по сегменту, локальный вариант не сработает вообще: он рассчитан на проксирование внутри одного интерфейса и не смотрит на маршруты за его пределы.

Цена решения

proxy-arp оказался рабочим операционным исправлением, но он не превращает исходный дизайн в идеальный. Что приходится учитывать:

  • маршрутизатор становится обязательным посредником между адресами, которые CPE считает локальными;
  • ARP-таблицы и uplink могут стать шумнее;
  • при неоднозначной маршрутизации несколько GW способны отвечать за один адрес, поэтому нужны специфичные /32 и аккуратная фильтрация анонсов;
  • клиентская изоляция теперь должна явно обеспечиваться firewall, а не случайным отсутствием ARP-ответа;
  • широкое включение proxy-arp частично меняет исходную модель защиты reply-only.

«Костылём» этот режим называют вполне обоснованно. Во-первых, он поощряет клиента ARP-ить весь префикс: каждое новое направление добавляет запись в ARP-кэш CPE и порождает широковещательный запрос в сегменте, а на масштабе тысяч VLAN и десятков тысяч устройств это заметная фоновая нагрузка и раздутые таблицы соседств. Во-вторых, он размывает границу между L2 и L3: логически адреса маршрутизируются, но топология в голове хоста остаётся плоской, из-за чего диагностика перестаёт совпадать со схемой — «локальный» по мнению CPE адрес фактически лежит через два хопа и чужой firewall. В-третьих, страдает изоляция: пока ARP-ответа не было, соседи по префиксу физически не могли достучаться друг до друга, а теперь между ними есть исправно работающий посредник, и единственное, что их разделяет, — правила в forward.

Отдельная категория неприятностей — неоднозначность. Если один и тот же префикс присутствует на нескольких шлюзах, за один и тот же адрес потенциально может ответить не тот маршрутизатор, у которого лучший путь, а тот, чей ARP-ответ пришёл первым; клиент закрепит в кэше «случайный» MAC на время жизни записи. Дальше подключается асимметрия: трафик уходит через одного GW, возвращается через другого, и rp-filter вместе с connection tracking начинают отбрасывать вполне легитимные пакеты, а причина выглядит как «иногда работает, иногда нет». Всё это лечится специфичными /32, аккуратной фильтрацией анонсов OSPF и предсказуемой политикой обратного пути.

И всё же в операторских IPoE-сетях proxy-arp регулярно оказывается единственным быстрым фиксом. Абонентские устройства оператору не принадлежат, маску и шлюз в них меняет только DHCP, а массовое переучивание парка CPE на новую адресную модель — это согласования, окна работ и обращения в поддержку. Когда связность нужна сейчас, а адресация исторически плоская, включение прокси на нужных access-интерфейсах даёт результат в пределах одной сессии в терминале и оставляет время на нормальный редизайн.

Стратегически чище выдавать абоненту /32 с маршрутом через gateway либо использовать адресную модель, в которой CPE не считает весь публичный блок своим L2-сегментом. PPPoE изначально ближе к этой логике: у клиента есть peer, и чужой адрес сразу отправляется маршрутизатору.

Но миграция адресации — отдельный проект. Когда сеть уже построена на общей /24, а простоя быть не должно, точечно включённый proxy-arp позволяет восстановить связность без переделки всех CPE за одну ночь.

Вывод

Главный урок этого случая простой: наличие маршрута ещё не доказывает, что пакет дошёл до уровня маршрутизации. При слишком широкой маске CPE сначала ищет удалённый адрес через ARP, и с reply-only этот запрос остаётся без ответа. proxy-arp подставляет MAC шлюза, после чего уже начинают работать OSPF, NAT и привычная L3-диагностика.

В следующий раз, когда OSPF уверенно показывает нужный /32, а абонент всё равно никого не видит, стоит посмотреть не только route print, но и один скромный who-has, который так и не получил ответа.


Официальная документация MikroTik: ARP и режимы proxy/reply-only, DHCP и параметр add-arp, OSPF в RouterOS, Packet Sniffer, отличия маршрутизации RouterOS v6 и v7. Термин proxy ARP и исходное описание механизма — RFC 1027.

#network #mikrotik #ospf

Обложка

Исследовательская статья, август–сентябрь 2026. Все адреса абонентов и часть публичных адресов в примерах обезличены. Это не инструкция по обходу ограничений, а описание эксплуатационной диагностики сети оператора.

Есть довольно мерзкий тип сетевой аварии: почти всё, что обычно смотрит мониторинг, зелёное. Линк поднят, маршрутизация есть, DNS отвечает, пинг идёт, speedtest иногда даже показывает вполне приличную скорость. Но при этом Windows пишет «без доступа к Интернету», телефон решает, что Wi‑Fi плохой, игра не может авторизоваться, IoT теряет облако, часть HTTPS-сайтов открывается, часть висит до тайм-аута, а некоторые системные connectivity-check вообще перестают проходить.

Для пользователя диагноз простой:

Интернет сломался.

Для оператора всё значительно веселее: по классическим метрикам он как будто не сломался.

Мы впервые плотно столкнулись с этим летом 2026 года. Началось всё с одного домашнего подключения и Wireshark, а к сентябрю выросло в отдельный операторский контур из NetFlow v9, GoFlow2, ClickHouse, Grafana и собственной системы проверок доступности. Вместе с контуром поменялся и главный вопрос. Сначала он звучал так:

Почему у одного клиента «нет Интернета», когда пинг есть?

Теперь так:

Можно ли на уровне оператора увидеть сетевой след фильтрации, понять, какой публичный CGNAT уже деградирует, и найти внутри него абонента, который генерирует особенно аномальный трафик?

Спойлер: прочитать внутреннее правило ТСПУ по NetFlow нельзя. Но увидеть последствия происходящего — вполне.


С чего всё началось: июньский Wireshark

Вот один из дампов, снятых ещё в июне.

Wireshark: повторные SYN к TCP/443 при живом остальном трафике

На этом скриншоте интереснее всего не отдельная строка, а соседство совершенно разных картин. В одних TCP-сессиях видны нормальные ACK и keepalive, внизу живёт DNS — то есть интерфейс не отвалился, IP-маршрутизация не исчезла, стек TCP в целом работает. А рядом к нескольким другим адресам на TCP/443 идут:

SYN →
...
SYN Retransmission →
...
SYN Retransmission →

И сессия так и не переходит в нормальный handshake. Нет ни ожидаемого:

SYN →
    ← SYN-ACK
ACK →

ни явного отказа:

SYN →
    ← RST

Просто тишина и повторные SYN.

Наблюдение оказалось важным: оно объясняло, почему «пинг есть» вообще ничего не гарантирует. ICMP может прекрасно проходить, DNS может отвечать, часть уже установленных соединений может жить, а новые TCP-сессии к определённым направлениям при этом не устанавливаются. Для приложения это выглядит как обычный сетевой тайм-аут: оно ждёт, повторяет попытку, снова ждёт. Для пользователя — как «Интернет то есть, то нет». Для простого ICMP-мониторинга — как отсутствие аварии.

Именно этот июньский дамп потом оказался полезен второй раз: в сентябре мы увидели почти тот же симптом, только уже не в PCAP одного клиента, а массово в NetFlow оператора.


Из той истории появился connect-check

Прежде чем строить операторскую аналитику, пришлось научиться фиксировать сам факт деградации со стороны клиента. Ручной перебор сайтов и curl довольно быстро перестал быть полезным: если не открывается один зарубежный сервис, это ещё ничего не говорит, а если не открывается ресурс, который и должен быть ограничен, — тем более.

Нужен был набор независимых проверок разных классов:

  • connectivity-check Android, Windows и Apple;
  • российские сайты;
  • банки и государственные сервисы;
  • зарубежные HTTPS-ресурсы;
  • игровые платформы;
  • AI-сервисы;
  • DoH и DoT;
  • QUIC;
  • NTP;
  • MQTT и IoT;
  • push;
  • CDN;
  • почтовые сервисы.

Так появился наш connect-check:

https://github.com/cooler58/connect-check

Он выполняет сотни проверок и складывает результат в один HTML-отчёт. Но для нынешнего исследования особенно важна одна вещь: в каталоге есть признак expected_block.

Условно:

expected_block = 1

означает: недоступность этого ресурса сама по себе сейчас не доказывает локальную проблему нашего egress.

А:

expected_block = 0

означает: ресурс в нормальной ситуации должен быть доступен, и его неожиданный fail уже интересен как внешняя фактура деградации.

Это избавляет нас от очень удобной, но неправильной логики: «увидели высокий score в NetFlow — значит, ТСПУ заблокировал адрес». Высокий score — только гипотеза. Событием для калибровки становится независимое наблюдение: например, на известном публичном egress одновременно перестают проходить обычные российские сервисы и системные проверки, которые падать не должны.


Почему домашнего tcpdump стало мало

PCAP отлично отвечает на вопрос, что происходит с конкретным клиентом прямо сейчас. Но у оператора задача другая: за одним публичным IPv4 через CGNAT могут сидеть десятки или сотни абонентов:

10.20.55.10  ─┐
10.20.55.11  ─┤
10.20.55.12  ─┤
10.20.55.13  ─┤
      ...      ├── CGNAT ── PUBLIC IPv4 ── Internet
10.20.55.184 ─┤
      ...      │
10.20.55.240 ─┘

Для внешнего мира вся эта компания — один адрес. И отсюда вырастает уже операторский вопрос:

Если внешний фильтр, WAF, антифрод или какая-то другая stateful-система принимает решение на уровне публичного IPv4, может ли один особенно «шумный» inside испортить жизнь соседям по NAT?

Сам по себе такой collateral effect давно известен и вообще не уникален для ТСПУ. Например, Cloudflare в 2025 году показал, что CGNAT-адреса попадали под rate limiting примерно втрое чаще обычных IP, хотя медианный bot-rate у CGNAT и non-CGNAT был почти одинаковым. Причина банальна: за одним адресом смешивается поведение множества разных людей и устройств.

Источник: Cloudflare — One IP address, many users: detecting CGNAT to reduce collateral effects.

Поэтому наша гипотеза с самого начала была шире формулировки «ТСПУ банит NAT». Нас интересует shared-IP collateral: может ли аномальная активность одного или нескольких insides менять сетевую судьбу всего публичного egress.


Операторский контур: NetFlow вместо тотального PCAP

Можно было зеркалировать весь трафик и писать PCAP. На небольшой лаборатории это прекрасная идея, а на операторской сети она довольно быстро превращается в отдельный проект по хранению, производительности, приватности и поиску по терабайтам захватов. Поэтому первый массовый слой мы сделали на NetFlow v9.

Схема получилась такой:

MikroTik / edge routers
        │
        │ NetFlow v9
        ▼
     GoFlow2
        │
        ▼
 Python ingest
 batch + disk spool
        │
        ▼
   ClickHouse
 raw + 1m/5m aggregates
        │
        ├── threat views
        ├── TSPU/silent-drop views
        ├── connect-check views
        └── BEFORE/EVENT/AFTER
                 │
                 ▼
              Grafana

Kafka на первом этапе не добавляли: чем меньше компонентов в исследовательском стенде, тем проще понять, кто именно врёт. Raw flow при этом сохраняем отдельно с TTL, и это оказалось принципиально важно — заранее мы несколько раз ошиблись в том, какая именно метрика окажется полезной. Если бы остались только готовые минутные агрегаты, каждую новую гипотезу пришлось бы проверять только на будущих данных.


Что NetFlow видит, а чего не видит

NetFlow не превращается в DPI только потому, что рядом появился ClickHouse. Мы не видим:

  • содержимое TLS;
  • HTTP payload;
  • точное SNI каждой сессии;
  • последовательность отдельных TCP-пакетов;
  • retransmission так же подробно, как в PCAP;
  • внутреннюю метку ТСПУ «эта сессия заблокирована»;
  • конкретное правило, принявшее решение.

Зато видим форму трафика:

src / dst
src_port / dst_port
protocol
tcp_flags
packets
bytes
duration
NAT fields
exporter
timestamp

А из неё уже можно считать:

  • flows/sec;
  • SYN flows;
  • SYN без ACK;
  • RST flows;
  • долю очень коротких flows;
  • число уникальных destination;
  • число destination ports;
  • число внутренних адресов за NAT;
  • UDP/443 и TCP/443;
  • изменение всего перечисленного относительно обычного baseline.

И вот этого неожиданно хватило, чтобы увидеть очень характерные профили.


Нюанс, на котором легко сломать всю аналитику: TCP flags

В нашем NetFlow tcp_flags — это OR флагов за жизнь flow. Поэтому мы сознательно говорим:

SYN flow, а не SYN packet.

Если в записи присутствует SYN, это значит, что внутри flow был SYN, но не обязательно, что запись состояла из одного-единственного SYN-пакета. На первый взгляд мелочь, а на практике без этой оговорки очень легко нарисовать красивую, но физически неправильную историю.


Первая серьёзная ошибка: мы смотрели на inside, а надо было на egress

Когда жалуется клиент 10.x.x.x, рука сама тянется строить аналитику вокруг него. Для CGNAT это неправильная единица исследования: внешняя система не знает, какой именно 10.20.55.xxx сейчас создаёт соединение, она видит публичный SNAT. Поэтому модель пришлось перевернуть:

PUBLIC NAT
   │
   ├── inside A
   ├── inside B
   ├── inside C
   └── inside N

Сначала мы отвечаем, что происходит с публичным egress, и только потом — кто внутри внёс максимальный вклад в его профиль. Это, пожалуй, самый важный архитектурный вывод всего эксперимента.


Вторая ошибка: postNATSource не всегда означает наш NAT

Стоило начать считать по публичным адресам, как у MikroTik NetFlow v9 обнаружилась занятная ловушка. NAT-поля присутствуют и на входящем трафике, поэтому без дополнительной проверки в топы nat_ip внезапно начинали попадать чужие внешние peer-адреса. Получалось очень убедительно и совершенно бессмысленно.

Реальный egress пришлось определять жёстче:

src = private / CGNAT
nat_src = public
nat_src != src
nat_src принадлежит нашей адресации

Только после этого аналитика по публичным NAT стала пригодна для сравнения.


Третья ошибка: BitTorrent прекрасно притворяется сканером

Следующая ловушка ждала уже в самих эвристиках. Наивный скан-детектор выглядит примерно так:

uniq_dst ↑
uniq_dst_port ↑
flows ↑

Проблема в том, что хороший активный P2P-клиент выглядит примерно так же: сотни peers, множество портов, масса коротких UDP flows, постоянные новые destination. Если просто поставить порог на fan-out, половина «злоумышленников» окажется торрентами. Поэтому в threat-профиль пришлось добавить отдельный p2p_like и dampen: если трафик похож на BitTorrent/DHT, высокий fan-out сам по себе не превращается в port-scan.

Отсюда общее правило для подобных исследований:

Одна высокая метрика почти никогда ничего не доказывает.


Что говорят открытые материалы про ТСПУ

Здесь нужна важная оговорка. У нас нет доступа к внутренним логам ТСПУ или ЦСУ. Для понимания возможной архитектуры мы используем открытый проект DanielLavrushin/tspu-docs — подробную реконструкцию по материалам лекции. Мы не считаем её официальной нормативной документацией и используем только как источник технических гипотез. Но несколько деталей из неё очень хорошо рифмуются с нашими наблюдениями.

1. Для protocol-block описан send RST off

В главе 17 описан параметр send RST off: при его выключенном состоянии TCP Reset при блокировке распознанных протоколов не отправляется, соединение молча отбрасывается и клиент дожидается тайм-аута. Мотивация там тоже понятна: немедленный RST заставляет приложение быстро создавать новую попытку и может породить ещё больше сессий.

Для нас это важно не как «доказательство внутренней настройки конкретной площадки», а как объяснение, почему отсутствие RST вообще не противоречит модели фильтрации. То, что в июне выглядело как повторные SYN в Wireshark, а в сентябре — как высокий syn_no_ack в NetFlow, физически вполне согласуется с silent drop.

2. Для протоколов описана двухстадийная схема

В главе 8 описана схема:

DPI recognition
behavior = ignore
       │
       ▼
protocol logs
       │
       ▼
SPFS / ЦСУ
очистка false positives
       │
       ▼
IP + port lists
       │
       ├── filter: block
       └── Eco Highway: L3/L4 block

То есть предварительное распознавание шифрованного протокола само по себе не обязано сразу рвать сессию. Сначала результаты собираются, затем централизованно очищаются, после чего формируются списки IP+порт. Там же для тестовой зоны приведён ориентир полного цикла порядка 5–15 минут — от обнаружения нового протокольного endpoint до загрузки очищенного списка. Для нашей аналитики это подсказка смотреть не только момент уже случившегося fail, но и 5–30 минут до него.

3. Разные механизмы могут оставлять разные следы

Открытая реконструкция описывает и DPI-фильтры, и второй эшелон, где готовые IP+port-списки могут применяться на L3/L4. Для NetFlow это означает неприятную, но полезную вещь:

не надо требовать одного универсального «отпечатка блокировки».

В разных сценариях мы можем получить:

  • RST-heavy;
  • silent SYN drop;
  • короткие оборванные flows;
  • изменение TCP/443 ↔ UDP/443;
  • частичную, а не полную деградацию.

Именно это мы в итоге увидели на живых данных.


Июнь и сентябрь: один симптом в двух масштабах

Июньский PCAP показывал локально:

новый TCP/443
SYN
тишина
повторный SYN
тишина

В сентябре на части публичных NAT мы увидели то же самое уже статистически:

syn ≈ syn_no_ack
short3 ↑
RST ≈ low

То есть большая доля TCP flows содержит SYN, но не показывает признаков нормального развития handshake, а сами записи очень короткие. Мы назвали этот класс:

silent_syn_drop

Это название наблюдаемого эффекта, а не утверждение «мы доказали конкретное внутреннее правило ТСПУ».


Фактура 8 сентября: один особенно интересный CGNAT

Первое событие, где статистика и клиентская фактура сошлись по времени, мы получили 8 сентября — от абонента за одним из публичных NAT. В публикации адрес обезличим.

inside:  10.20.55.xxx
egress:  203.0.113.xxx

Сводка connect-check:

FAIL     209
WARNING  113
OK       198

То есть это не «чёрный экран и полный обрыв Интернета». Почти двести проверок продолжали работать — и именно поэтому проблема выглядела так неприятно: часть Интернета есть, часть нет, часть отвечает нестабильно. Среди неожиданных fail были ресурсы с expected_block=0, в том числе Госуслуги и Ведомости; параллельно массово ломались системные connectivity-check и разные зарубежные HTTPS/IoT-сервисы. Это уже хорошая метка времени: на данном egress действительно наблюдалась заметная частичная деградация, которая не сводилась к обычному списку ожидаемо ограниченных ресурсов.

Теперь смотрим NetFlow того же публичного NAT примерно в тот же период. В одном из срезов:

Метрика Наблюдение
внутренних адресов за NAT ~186
short flows до 3 пакетов ~88%
RST ~0.4%
уникальных destination ~2682
уникальных destination ports ~790
flow rate ~266 flows/s

На raw-окне порядка 15 минут только TCP/443 было около 145 тыс. flows примерно к 3,8 тыс. destination. Отдельно бросался в глаза fan-out по TCP/22: около 1,8 тыс. flows примерно к 322 адресам назначения.

Сами по себе цифры «виноват ТСПУ» не доказывают, но профиль откровенно шумный и по составу совпадает с описанным выше silent-классом — теперь на масштабе целого NAT. И одновременно независимый connect-check говорит: на этом же публичном адресе уже плохо работают сервисы, которые должны быть доступны. Вот такое совпадение двух независимых слоёв интереснее любого отдельно взятого score.


Но у этого кейса есть неприятная деталь — и мы её не прячем

В HTML connect-check того же клиента присутствовала проблема локальной среды: тест показывал 100% loss до Wi‑Fi gateway с некорректно определённым 0.0.0.0. Если бы нашей целью была эффектная история, эту строчку проще всего было бы не замечать, но для исследования это плохая привычка. Поэтому кейс нельзя честно назвать однозначным доказательством блокировки именно ТСПУ.

Он сильно поддерживает рабочую модель, потому что одновременно есть:

  • unexpected fail обычных ресурсов;
  • известный публичный egress;
  • silent SYN pattern;
  • очень высокий short-flow ratio;
  • низкий RST;
  • около 186 insides на одном NAT;
  • выраженный fan-out.

Но для чистого подтверждения нужен контрольный connect-check с Ethernet либо другой клиент на том же egress. Без таких оговорок очень быстро получается не исследование, а коллекция подтверждений заранее любимой теории.


А RST всё-таки бывает

После июньского PCAP и первых сентябрьских данных можно было легко уйти в другую крайность и решить, что RST нам вообще не интересен и всё всегда silent. Тоже нет. На другом публичном NAT в сегодняшнем срезе обнаружился совершенно иной профиль:

RST ≈ 43%
short3 ≈ 99%

То есть почти учебниковая RST-heavy картина. Конкретный адрес мы сознательно не публикуем, но сам факт важен:

на одной и той же операторской сети существуют как минимум два наблюдаемых класса деградации.

Условно:

Класс A — silent

syn_no_ack ↑
short3 ↑
RST low

Класс B — RST-heavy

RST ↑↑
short3 ↑↑

Это хорошо отрезвляет: искать один универсальный индикатор «ТСПУ=1» бессмысленно.


Масштаб: это не один странный NAT

Оставался вопрос, насколько сентябрьский кейс единичен. После того как детектор silent-drop перестроили с RST-first на syn_no_ack + short3, он начал находить похожие публичные egress по всей выборке.

На снимке 8 сентября около 16:40:

~65 публичных NAT

попадали в v_silent_drop_nat, и порядка:

~67 NAT

были помечены connect-check-ориентированным view как кандидаты на тихую деградацию.

Здесь очень важно слово «кандидаты»: порог пока исследовательский, а confirmed-фактуры у нас значительно меньше. Именно поэтому следующим этапом мы не собираемся «повышать чувствительность алерта», а хотим получить несколько независимых connect-check с разных NAT и сравнить их с контрольной группой.


Может ли «шумный» inside мешать соседям?

Это один из самых интересных вопросов всего проекта. Возьмём тот же CGNAT:

                       ┌── обычный абонент A
                       ├── обычный абонент B
                       ├── обычный абонент C
                       │
PUBLIC IPv4 ◄──────────┼── noisy inside
                       │    ├── много SYN
                       │    ├── сотни dst
                       │    ├── сотни ports
                       │    └── short flows
                       │
                       ├── обычный абонент Y
                       └── обычный абонент Z

Для любого внешнего механизма, который опирается на IP reputation, rate, поведенческий профиль или состояние большого числа сессий, всё это — один источник, и технически идея collateral damage на CGNAT совершенно реалистична (см. упомянутые выше данные Cloudflare). Но применительно именно к нашим событиям ТСПУ причинность пока не доказана.

Мы видим корреляцию:

аномальный NAT
+
noisy insides
+
неожиданные fail
+
характерный TCP-след

Чтобы сказать:

«вот этот конкретный inside своей активностью вызвал деградацию публичного адреса»

нужна повторяемая временная последовательность. Именно поэтому теперь основная единица анализа — не EVENT, а BEFORE → EVENT → AFTER.


BEFORE / EVENT / AFTER: как не перепутать причину со следствием

Высокий SYN может означать две противоположные вещи.

Вариант 1. SYN был причиной аномального профиля

Например, устройство действительно:

  • сканирует сеть;
  • перебирает сервисы;
  • заражено;
  • создаёт огромное количество новых соединений.

Вариант 2. SYN уже является следствием проблемы

Соединения перестали устанавливаться, приложения начинают ретраи, и количество SYN растёт после начала деградации. Если смотреть только на EVENT, эти два сценария легко перепутать.

Поэтому каждое подтверждённое внешним тестом событие теперь режем на три окна:

        BEFORE             EVENT              AFTER
───────────────┬─────────────────────┬────────────────
   до fail     │ connect-check fail  │ после события
───────────────┴─────────────────────┴────────────────

Для каждого окна считаем:

flows_sec
syn_sec
syn_no_ack_pct
rst_pct
short3_pct
uniq_dst
uniq_dst_port
uniq_inside
tcp443
udp443
scan_score
amp_score
p2p_like

Самое интересное окно — BEFORE. EVENT показывает, как выглядит уже пострадавший egress, а BEFORE потенциально позволяет найти, что происходило до того, как клиент заметил проблему.


Почему здесь интересны 5–15 минут

Ширину этого окна нам фактически подсказал уже упомянутый ориентир полного цикла из открытой реконструкции. Мы не знаем, совпадает ли этот интервал с конкретными реальными событиями нашей сети в 2026 году, но как исследовательская гипотеза он очень удобен.

Если в будущем несколько независимых кейсов будут выглядеть так:

T-20m  на NAT появляется необычный fan-out
T-15m  резко растут новые сессии
T-10m  выделяется один noisy inside
T0     expected_block=0 начинает FAIL
T+...  профиль меняется или доступность восстанавливается

это будет уже гораздо сильнее простой одновременной корреляции. Если такой последовательности не окажется — значит, гипотеза не выдержала проверку. Тоже полезный результат.


Что именно считаем «шумным» профилем

Мы постепенно пришли к трём основным осям.

1. Порты

uniq_dst_port

Много разных destination ports за короткий период может быть признаком port-scan, сервисного перебора или просто очень необычного приложения. Сам по себе показатель слабый, но вместе с высоким SYN и short-flow ratio уже интереснее.

2. Destination

uniq_dst
uniq_dst_pair

Насколько широко источник размазывает соединения по Интернету. Современный браузер, CDN и P2P могут давать большой fan-out совершенно легально, поэтому контекст обязателен.

3. Незавершённые TCP-сессии

syn_no_ack_pct
short3_pct

Особенно интересна комбинация:

syn_no_ack high
short3 high
RST low

Именно она лучше всего соответствует нашему наблюдаемому silent-классу.

Дополнительные оси:

  • flows_sec;
  • tcp443 / udp443;
  • amp-порты вроде 53/123/1900/11211;
  • P2P dampen;
  • отклонение от собственного baseline.

Baseline важнее абсолютного числа

Последняя ось из списка на практике оказалась главной. Допустим, мы видим:

100 SYN flows/sec

Само это число ни о чём не говорит: для офиса на десять компьютеров подозрительно, а для большого CGNAT, хостинга или игрового сегмента — возможно, совершенно нормально. Поэтому абсолютные пороги остаются только первым слоем, а для каждого объекта полезнее хранить собственную историю:

average
median
p95
p99
max
stddev

И смотреть не только:

сейчас = 100

а:

сейчас = 100
обычно = 8
p99 = 17

Вот это уже настоящая аномалия конкретного объекта.


Почему мы пока не делаем auto-ban

Когда на графике красиво видно port-scan-ish, очень хочется сразу автоматизировать «лечение». Мы этого сознательно не делаем, потому что под тем же профилем могут скрываться:

  • легитимный vulnerability scanner клиента;
  • мониторинг;
  • Kubernetes;
  • P2P;
  • игровой launcher;
  • backup;
  • CDN;
  • корпоративный proxy;
  • заражённый хост.

NetFlow-эвристика должна сначала привести человека к правильному месту расследования, а не сама вынести приговор. Поэтому сейчас workflow выглядит так:

NetFlow
   ↓
метрики + score
   ↓
публичный NAT
   ↓
вкладчики inside
   ↓
hourly digest / Grafana
   ↓
человек
   ↓
connect-check / PCAP / контакт с абонентом

Это скорее инструмент NOC и security operations, чем автоматическая IDS.


Отдельно пришлось мониторить сам мониторинг

Ещё одна прекрасная возможность обмануть себя — потерять NetFlow на collector и принять дырку в данных за сетевое событие. На первом варианте установки ingest, ClickHouse, Grafana и остальные компоненты жили почти вместе; после подключения нескольких реальных exporters нагрузка быстро стала неприятной, так что роли пришлось разнести и добавить disk spool.

Теперь отдельно смотрим:

  • состояние GoFlow2;
  • UDP receive;
  • exporter sequence gaps;
  • задержку ingest;
  • ClickHouse inserts;
  • CPU/RAM/disk.

Правило простое:

Если у коллектора sequence gap, сначала чините коллектор. ТСПУ подождёт.


Что получилось в Grafana

Вместо одного гигантского дашборда мы разделили задачи.

Почему этому NAT плохо?

Публичный NAT как ключ:

silent drop?
RST?
fan-out?
P2P?
сколько inside?
что происходило до события?

Scanners

Port-scan-ish и host-scan-ish профили.

Amplifiers

Активность по типичным UDP amplification ports.

Malware-ish

Долго живущие или регулярно повторяющиеся аномальные inside. Это именно эвристика, а не диагноз «найден вирус».

Infra

Здоровье самого NetFlow-контура.

Самой полезной частью в итоге оказался не красивый общий score, а возможность провалиться:

problem NAT
   ↓
insides behind NAT
   ↓
кто дал SYN?
   ↓
кто дал fan-out?
   ↓
кто дал port sweep?

То есть перейти от «плохо всему адресу» к конкретным кандидатам внутри CGNAT.


Июнь 2026 вообще был показательным

Наш локальный Wireshark-скриншот не существовал в вакууме. В июне публично обсуждались проблемы с доступом к российским облачным сервисам: Habr, ссылаясь на сообщения отрасли и публикации РБК, писал о подтверждённых сбоях у ряда российских хостеров и о том, что решения могли приниматься по косвенным признакам зашифрованных соединений — в том числе диапазонам IP и частоте подключений.

Источник: Habr — «РКН устроил проблемы с доступом российским облачным сервисам и сайтам».

Мы не используем эту публикацию как доказательство конкретно нашего июньского дампа. Но она важна как фон: collateral damage от поведенческих и IP-ориентированных механизмов в 2026 году уже наблюдался публично далеко не только нами.


QUIC тоже нельзя забывать

Современный HTTPS — это уже не только TCP/443: браузеры и приложения активно используют QUIC на UDP/443, и если UDP/443 становится недоступен или деградирует, клиент может откатиться на TCP. Поэтому мы отдельно смотрим:

udp443

tcp443

udp443 / tcp443

Пока данных недостаточно, чтобы считать это сильным индикатором. Но резкое изменение отношения на проблемном NAT вполне может оказаться полезным дополнительным признаком.


NetFlow, PCAP и connect-check отвечают на разные вопросы

В результате сложилась довольно удобная трёхслойная модель.

NetFlow

Показывает, где среди тысяч абонентов вообще стоит искать проблему.

connect-check

Показывает, что в этот момент реально видел клиент и какие классы сервисов перестали работать.

PCAP

Показывает, что физически происходило с конкретными сессиями.

Условно:

NetFlow
   "кажется, проблема вот на этом egress"
              │
              ▼
connect-check
   "да, здесь в 15:11 уже падают unexpected ресурсы"
              │
              ▼
PCAP
   "а теперь посмотрим конкретный handshake"

Июньский Wireshark и сентябрьский NetFlow как раз замыкают эту историю.


Что мы уже можем говорить достаточно уверенно

1. «Пинг есть» больше не является достаточной проверкой доступности

Частичная TCP/TLS-деградация прекрасно сосуществует с живым ICMP, DNS и частью установленных соединений.

2. NetFlow способен показать след такой деградации

Не внутреннее решение DPI, а статистический результат на edge.

3. На нашей площадке silent SYN-drop оказался важнее RST

Рабочей оказалась silent-комбинация, описанная выше. Но RST-heavy кейсы тоже существуют, поэтому единственного fingerprint нет.

4. Для CGNAT главная сущность — публичный egress

Inside нужен для attribution, а не как первичный ключ внешнего события.

5. P2P обязательно нужно отделять от сканирования

Иначе top offenders очень быстро превращаются в «список людей с торрентами».

6. Калиброваться надо от внешней фактуры

connect-check expected_block=0 FAIL с известным egress полезнее любого самостоятельно придуманного anomaly score.

7. Самое интересное — BEFORE

Именно поведение перед событием может когда-нибудь дать нам предиктивный сигнал.


Чего мы пока не можем утверждать

Вот здесь лучше быть скучными. Мы не знаем машинного порога вида:

N SYN = блок

Мы не можем по одному NetFlow доказать, какое именно правило сработало внутри ТСПУ, и не можем утверждать, что каждый silent_syn_drop — это ТСПУ: причиной могут быть и другие middlebox, серверная сторона, маршрутизация, локальные проблемы клиента и ошибки измерительного контура.

Мы пока не доказали причинную связь:

noisy inside → решение внешнего фильтра → collateral для всего CGNAT.

Она выглядит правдоподобно и хорошо рифмуется с общей проблемой shared-IP reputation, но для конкретного ТСПУ нам нужны десятки повторяемых labeled events. И мы специально не называем «малварью» любой высокий scan_score — это только кандидат для расследования.


Что будем делать дальше

Сейчас ценнее не ещё десять панелей в Grafana, а фактура. Нужны разные классы реальных событий:

  1. Silent drop — описанный выше класс.
  2. RST-heavy — чтобы понять другой тип поведения.
  3. P2P control — высокий fan-out без деградации.
  4. Настоящие scanners — для отделения от P2P.
  5. Чистые CGNAT с сопоставимой нагрузкой, где connect-check полностью здоров.

Для каждого подтверждённого случая:

когда началось
какой public NAT
что fail
что OK
какие insides сидели за NAT
что происходило BEFORE
что происходило EVENT
что изменилось AFTER

После нескольких десятков таких кейсов уже можно считать распределения и квантили, а не спорить о красивых порогах вручную. Например, сравнить:

P(degradation | syn_no_ack, fanout, ports, baseline_delta)

и понять, существует ли вообще устойчивый предиктивный профиль. Если существует — получим ранний сигнал для NOC. Если нет — тоже прекрасно: значит, ещё одна красивая гипотеза умерла от данных, как и положено.


Возможно, главный результат проекта вообще не про ТСПУ

Начиналось всё с попытки понять странную фильтрацию. Но даже если завтра убрать из системы слово «ТСПУ», контур всё равно остаётся полезным. Он уже позволяет видеть:

  • аномальные публичные NAT;
  • массовые незавершённые TCP-сессии;
  • scanners;
  • amp-port activity;
  • P2P;
  • необычный fan-out;
  • noisy insides внутри CGNAT;
  • отклонение от собственного baseline;
  • момент, когда пользовательская доступность расходится с зелёным ICMP.

То есть из узкой попытки разобраться с одним странным сетевым эффектом получился довольно универсальный инструмент эксплуатации CGNAT.


Вместо заключения

В июне мы смотрели на Wireshark и видели повторные SYN к :443 среди совершенно живого остального трафика. В сентябре тот же класс симптомов появился уже на операторской статистике:

syn_no_ack
short flows
fan-out
публичный NAT
сотни insides

Потом рядом нашёлся и другой класс — RST-heavy. То есть простого ответа вида:

TSPU_BLOCKED = true

скорее всего, никогда и не будет. Зато можно сделать кое-что полезнее — не гадать по жалобе «опять ТСПУ или у клиента роутер завис», а собрать несколько независимых слоёв:

реальный fail клиента
+
известный public egress
+
NetFlow до/во время/после
+
вклад конкретных insides
+
при необходимости PCAP

По отдельности каждый признак слабый. Вместе они превращают фразу:

«кажется, Интернет опять как-то странно работает»

в вполне измеримое сетевое событие. А с измеримыми событиями уже можно работать.


Ссылки

Предыдущая часть истории — «Две недели “интернета нет” при зелёных пингах»:

https://articles.clr58.ru/dve-nedeli-net-interneta

connect-check:

https://github.com/cooler58/connect-check

Открытая реконструкция архитектуры ТСПУ:

https://github.com/DanielLavrushin/tspu-docs

Про send RST off:

https://github.com/DanielLavrushin/tspu-docs/blob/main/chapters/17.md

Про двухстадийное формирование списков:

https://github.com/DanielLavrushin/tspu-docs/blob/main/chapters/08.md

Cloudflare про collateral effect CGNAT:

https://blog.cloudflare.com/detecting-cgn-to-reduce-collateral-damage/

Habr про проблемы российских облачных сервисов в июне 2026:

https://habr.com/ru/amp/publications/1046025/


Дисклеймер. Материал описывает эксплуатационные наблюдения на стороне оператора связи и анализ доступных сетевых метаданных. Он не является официальным описанием ТСПУ, инструкцией по обходу ограничений или доказательством того, что конкретное сетевое событие вызвано конкретным правилом Роскомнадзора. Открытые материалы по архитектуре ТСПУ используются как источник гипотез и требуют соответствующей оговорки. Аномальный NetFlow-профиль сам по себе не является основанием обвинять или автоматически блокировать абонента.

#network #monitoring #netflow
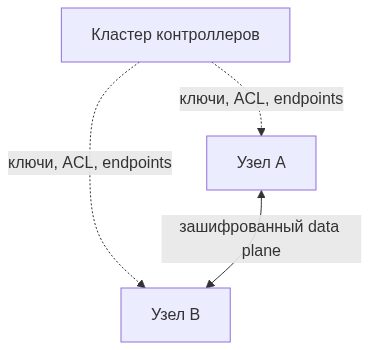
Обложка

Дата: 2026-08-06. Пост для канала про RAG/эмбеддинги. Автор: технический писатель (gpt-4o-mini) + редактура.


Есть у меня странная тоска: я ничего не теряю — я всё записываю. Память ассистента, заметки, черновики для канала. Годами. А потом нужно найти «ту самую мысль», и я зависаю над папкой с файлами, как археолог над руинами — кисточка, пыль, и ноль результата.

Горечь простая: grep ищет по словам, а я помню по смыслу. «Ну там, где мы туннель к нашему роутеру настраивали, помнишь?» — и угадай теперь, какое заклинание набрать, чтобы поиск это понял. Я помню суть, а не формулировку. Похоже, эта боль универсальна для всех, кто растит свою базу знаний.

Что я сделал

Вместо охоты за словами я научил лабу ловить смысл. Это эмбеддинги, звучит страшно, работает просто.

Представь, что у каждого кусочка текста появляются «координаты» в пространстве смыслов. Не географические — смысловые: 1024 числа описывают, о чём этот текст. Два текста про одно и то же оказываются рядом, хоть и написаны разными словами. Такой себе компас в тумане заметок: поворачиваешь вопрос — и он тянет тебя к нужным местам.

За всё отвечает bge-m3 — это 1.2 ГБ весов, которые живут на нашем контейнере с ollama и AMD-графикой. Всё локально, ничего в облака не улетает, и это бесплатно. Модель многоязычная, заточена под поиск — русский понимает без акцента.

Почему bge-m3, а не готовый сервис типа Notion

Соблазн был: поставить что-то готовое, где поиск «уже встроен» — Notion, или облачную векторную базу, или поисковик от OpenAI. Но каждая готовая опция упиралась в одно и то же: мои данные уезжают в чужое облако. А в моих заметках — конфиги, адреса, внутренности лабы. Это не то, что хочется отдавать чужому сервису ради удобного поиска.

Поэтому критерии были жёсткие: – локально — веса лежат у меня, запросы не покидают лабу; – бесплатно — никаких подписок за «интеллектуальный поиск»; – open-source — не исчезнет и не подорожает в один день; – многоязычность — мои заметки наполовину на русском, и bge-m3 это понимает.

Из локальных вариантов смотрел ещё nomic-embed-text — он легче, но слабее на русском. bge-m3 даёт 1024 измерения против 768 и заметно лучше ловит смысл на русском. А когда база вырастет — векторный индекс из JSON-файла переедет в полноценную векторную БД без переделки логики.

Дальше механика, как хорошая ручка-кликер: надёжная и простая. Я режу документы на куски примерно по 700 символов (у меня вышло 55 чанков), каждый кусок превращаю в вектор из 1024 чисел, и всё это складываю в один файл — rag-index.json. Когда приходит вопрос, я превращаю вопрос в такой же вектор и считаю, какие куски к нему ближе всего. Близость — это косинусная мера: по сути «угол между смыслами».

Весь инструмент — один скрипт rag-search.py (~100 строк, только стандартная библиотека Python). Разберу по косточкам — не ради академичности, а потому что круто видеть, как искра превращается в мотор.

1. Нарезка на чанки. Документ режется на куски по ~700 символов, чтобы каждый кусок был самодостаточным куском смысла:

def chunk_text(text, size=700):
    text = re.sub(r'\n{3,}', '\n\n', text)
    chunks, cur = [], ""
    for line in text.splitlines():
        if len(cur) + len(line) + 1 > size and cur:
            chunks.append(cur.strip()); cur = ""
        cur += line + "\n"
    if cur.strip(): chunks.append(cur.strip())
    return chunks

2. Векторизация. Каждый чанк отправляется в ollama на /api/embed, и на выходе — список из 1024 чисел. Это и есть «координаты смысла»:

def embed(texts):
    out = []
    for t in texts:
        req = urllib.request.Request(f"{OLLAMA}/api/embed",
            data=json.dumps({"model": "bge-m3", "input": [t]}).encode(),
            headers={"Content-Type": "application/json"})
        with urllib.request.urlopen(req, timeout=120) as r:
            out.append(json.load(r)["embeddings"][0])
    return out

3. Косинусная близость. Поиск — это просто «угол» между вектором вопроса и всеми чанками. Чем ближе к 1 — тем ближе смысл:

def cos(a, b):
    dot = sum(x*y for x, y in zip(a, b))
    na = math.sqrt(sum(x*x for x in a))
    nb = math.sqrt(sum(x*x for x in b))
    return dot / (na * nb) if na and nb else 0.0

4. Поиск. Вопрос → вектор → сравнить со всеми → выдать топ-N:

def search(query, top=3):
    qv = embed([query])[0]
    scores = sorted(((cos(qv, v), i) for i, v in enumerate(vecs)), reverse=True)
    for s, i in scores[:top]:
        print(f"[{s:.3f}] {srcs[i][0]}: {chunks[i][:120]}...")

Интерфейс командной строки: – python3 rag-search.py --build — пересобрать индекс; – python3 rag-search.py "вопрос" — поиск; – --top N — сколько результатов показать; – --doc путь — добавить документ в индекс.

Живые тесты

Хватит теории — вот как это дышит на моих заметках:

«Как настроен туннель к нашему роутеру» → нашёл статью про NAT-туннель. Точность 0.62. Я не написал ни одного слова из статьи — и она нашлась.

«Что мы делали с маршрутами на роутере» → вытащил историю про 12 мёртвых маршрутов, которые мы когда-то чистили. Точность 0.55. Я даже забыл, что записывал это.

«Какая модель у открыток для канала» → склейку из статьи про три модели, которые мы сравнивали. Точность 0.51. Вопрос был про картинки, ответ — про модели генерации. Смысл уловил.

Вывод

Поиск по словам — прошлый век. Теперь у меня поиск по смыслу: мгновенный, локальный, бесплатный. Индексация всех 55 чанков занимает пару минут, а сам поиск — миллисекунды. И это не финиш, а фундамент: дальше любой сервис лабы сможет подключаться к базе знаний через RAG и отвечать на вопросы «с памятью».

Если ваши заметки похожи на чёрную дыру — записал и забыл, — выход есть. Он весит 1.2 ГБ и забирает один вечер.

А у вас как с заметками: находите с первого раза или тоже копаетесь, как я раньше?


📊 Метрики поста: ~14k токенов, 2 модели (gpt-4o-mini автор + gpt-5 редактура), 3 проверки живьём.

#selfhosting #openclaw

Обложка

Цикл «Не светим лишнего». Выпуск 6.

Представим SSH, который снаружи вообще не отвечает. Порт закрыт firewall, баннера нет, перебирать пароль некуда. Но если клиент сначала обратится к порту 888, потом к 555 и затем к 222, его IP на полчаса попадёт в список secured, и SSH откроется.

Это и есть классический port knocking.

Как собирается последовательность

На первом шаге firewall ловит пакет к закрытому порту и добавляет источник в промежуточный список на 20–30 секунд. Второй шаг срабатывает только для адресов из первого списка и переносит их дальше. Последний шаг добавляет IP в рабочий allow-list с более длинным timeout.

Сервис на «стучащих» портах слушать не обязан. Firewall просто замечает попытки соединения.

Последовательность может использовать TCP, UDP или ICMP. В ICMP-варианте различают, например, размеры Echo Request или другие доступные признаки пакета. Это бывает удобно в сетях, где исходящие TCP/UDP ограничены, но ping проходит. Правда, бывает и наоборот: ICMP режут первым.

Что knocking даёт

Он хорошо скрывает поверхность атаки от обычного сканирования. Пока последовательность не выполнена, SSH, WinBox или служебный NAT выглядят закрытыми. Боты не видят форму входа и не начинают перебор.

Реализовать базовую схему можно прямо на MikroTik без отдельного сервера. Клиенту иногда достаточно нескольких команд nc или ping. Для аварийного доступа это может быть полезным резервом.

Чего knocking не даёт

Обычная последовательность портов не шифруется. Человек, который видит трафик, может её повторить. Даже без прослушивания секрет из трёх коротких портов теоретически перебирается, если нет ограничений частоты и защитных списков.

Firewall опять же открывает внешний IP. За общим NAT правильный стук одного инженера может открыть путь соседнему клиенту того же NAT. Собственная авторизация SSH или веб-системы остаётся обязательной.

Плюсы

  • сервис не виден обычному сканеру;
  • минимальная серверная инфраструктура;
  • любые защищаемые протоколы после открытия;
  • короткий timeout автоматически закрывает доступ;
  • можно использовать как аварийный канал;
  • легко сочетать с обычным allow-list.

Минусы

  • последовательность можно подсмотреть и воспроизвести;
  • неудобство на телефоне и чужом компьютере;
  • NAT объединяет пользователей;
  • ICMP/UDP могут фильтроваться;
  • диагностика выглядит странно: правильные пакеты специально получают drop;
  • состояние последовательности можно сбить или зашумить.

Где можно больно ошибиться

Сделать короткий секрет и длинное открытие. Последовательность из трёх известных портов с доступом на сутки — слабая конструкция.

Не сбрасывать неправильную последовательность. Если промежуточные списки слишком терпеливы, порты можно набрать вразнобой.

Открыть управление всем сервисам. Последний knock должен включать конкретную группу, а не общий accept from secured to any.

Считать knocking заменой пароля. Он уменьшает видимость сервиса, но не делает дырявый SSH безопасным и не заменяет ключи.

Забыть порядок firewall. Правила knocking должны увидеть пакет раньше финального drop, а рабочий allow — стоять в правильной цепочке input или forward.

Не ограничить перебор. Источники, которые постоянно стучат по шагам в неправильном порядке, можно временно отправлять в отдельный blacklist.

Когда применять

Port knocking хорош как лёгкий дополнительный слой для небольшой группы администраторов, особенно если отдельный портал пока избыточен. Для массового пользовательского доступа он неудобен. Для более сильной версии той же идеи существует Single Packet Authorization: один криптографически защищённый пакет вместо наблюдаемой последовательности.

Ранее в цикле

Документация и источники

#network