От пассивного NetFlow к активной матрице: проверяем каждый NAT отдельно
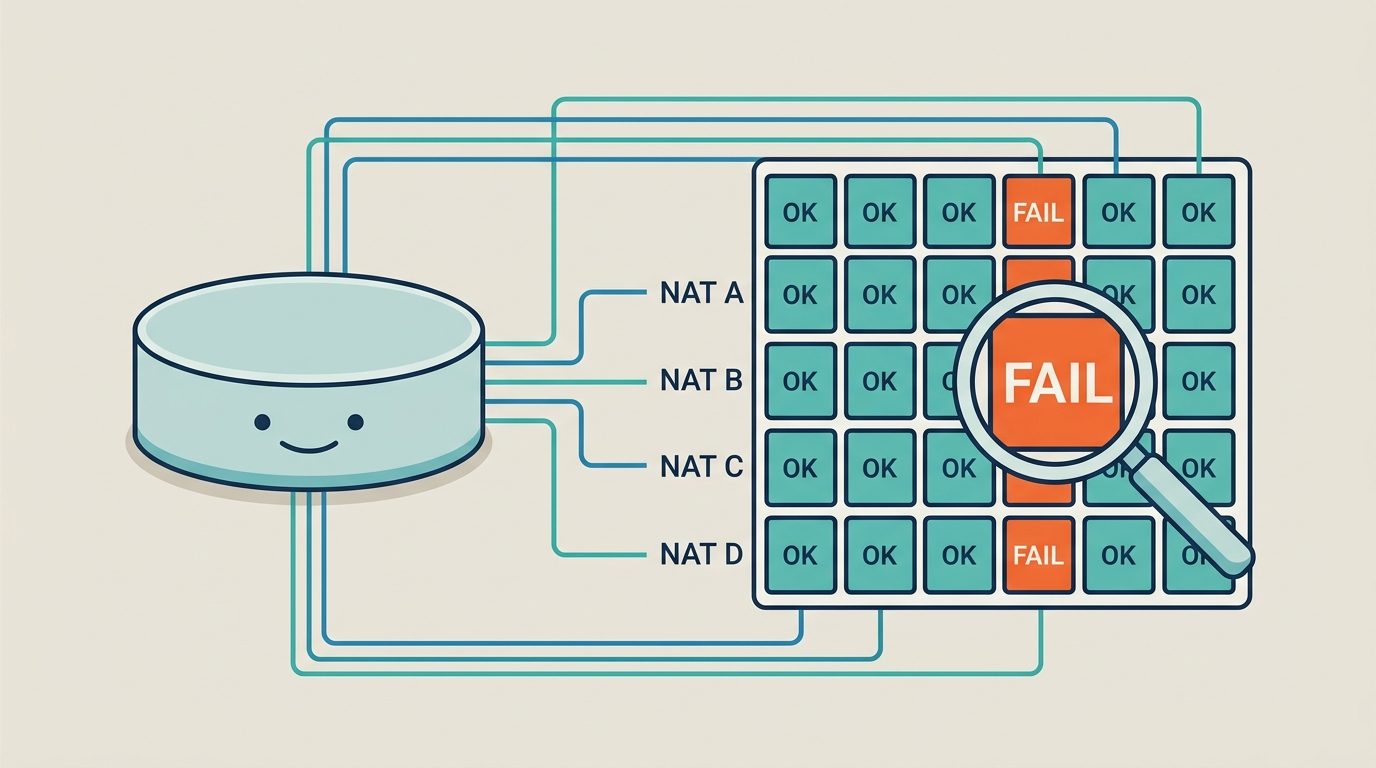
Третья часть исследования NetFlow и странных деградаций доступа. В первой части мы научились видеть массовый silent SYN-drop на публичных CGNAT. Во второй — разобрались, почему у ТСПУ нет одного сетевого следа: три соединения, 16 КБ и «сибирская блокировка».
Во второй части у нас оставалась неприятная методологическая дыра. NetFlow хорошо показывал, что с публичным egress происходит что-то странное: росли syn_no_ack, короткие flows, появлялись односторонние обращения к контрольным ресурсам. Но сам по себе этот след всё ещё не отвечал на главный вопрос:
ресурс действительно недоступен именно с этого публичного NAT-адреса — или мы просто неправильно интерпретируем телеметрию?
За следующие два дня мы сильно продвинулись именно здесь. К пассивному наблюдению добавили активную проверку: заставляем сам MikroTik устанавливать соединение с конкретного публичного src-address, а затем прогоняем один и тот же набор целей через весь пул SNAT.
И вот здесь картина стала намного интереснее.
Почему обычного curl с сервера недостаточно
Если проверить сайт с отдельного сервера, мы узнаем только, что ресурс в принципе жив. Для нашей задачи этого мало.
За одним edge-роутером может быть несколько десятков публичных адресов, используемых для SNAT. И мы уже видели ситуацию, когда два соседних адреса одного пула ведут себя совершенно по-разному:
NAT A → Google timeout
NAT A → Cloudflare OK

NAT B → Google OK
NAT B → Cloudflare OK
Маршрут тот же. Роутер тот же. Аплинк тот же. Destination тот же. Меняется только исходный публичный IP.
Поэтому проверку нужно выполнять именно так:
один GW
одна цель
одинаковый способ подключения
разные src-address
На RouterOS это можно сделать штатным /tool fetch с явным src-address.
Минимальная проба на MikroTik
В самом простом виде тест выглядит так:
/tool fetch \
    url="http://connectivitycheck.gstatic.com/generate_204" \
    src-address=203.0.113.x \
    duration=2s \
    keep-result=no
Если fetch завершается, путь с этого source IP до цели существует. Если соседний SNAT тем же способом стабильно получает timeout, уже появляется интересная фактура.
Но при массовом прогоне обнаружилась RouterOS-грабля: failed /tool fetch, запущенный через SSH, пишет в лог:
script,error executing script from sshd failed, please check it manually
Когда таких проверок десятки тысяч, лог роутера превращается в мусор. Поэтому рабочий вариант пробы у нас теперь такой:
:do {
    :local x [/tool fetch \
        url="http://connectivitycheck.gstatic.com/generate_204" \
        src-address=203.0.113.x \
        duration=2s \
        keep-result=no \
        as-value]
    :put ("STATUS=".$x->"status")
} on-error={
    :put "WRAP_FAIL"
};
:put "DONE"
as-value + on-error позволяют получить машинно разбираемый результат и при этом не засыпать системный log сообщениями script,error на каждом timeout.
Это мелочь, но именно такие мелочи становятся важными, когда вместо пяти ручных проб запускается сорок тысяч.
Откуда берём публичные адреса для проверки
Мы не хотим тестировать произвольный список адресов из Excel. Скрипт сам забирает с MikroTik две вещи:
/ip address print where disabled=no
/ip firewall nat print detail where chain=srcnat and disabled=no
Дальше строится пересечение:
local = parse_local_ips(addr_raw, wan)
nat_tos = parse_srcnat_tos(nat_raw)
srcs = sorted(local & nat_tos)
То есть в матрицу попадает адрес, который одновременно:
- реально присутствует на данном маршрутизаторе;
- реально используется в
srcnat to-addresses.
Это важно. На первом этапе мы несколько раз пытались проверять NAT, который видели в NetFlow, но которого физически не было на конкретном GW. После перехода на автоматическую инвентаризацию эта путаница исчезла.
Скрипт умеет разворачивать и диапазоны to-addresses=A-B, поэтому вручную перечислять пул не нужно.
Полный рабочий вариант лежит в scripts/mt_cc_full_matrix_probe.py.
403 цели × весь SNAT-пул
Вторую половину матрицы мы собираем из нашего connect-check.
Отдельный скрипт build_cc_probe_urls.py объединяет:
resources.conf;- встроенный каталог connect-check;
- captive-check URL разных ОС;
- DoH/AI/IoT/update/game endpoints;
- контрольные зарубежные и российские сервисы.
На текущей версии получилось 403 цели.
Дальше для каждого gateway строится декартово произведение:
каждый src-nat × каждая цель
В последнем полном прогоне:
| GW | SNAT source | Проб | OK | FAIL |
|---|---|---|---|---|
ot1 |
42 | 16 926 | 5 934 | 10 992 |
ot2 |
20 | 8 060 | 2 834 | 5 226 |
ot3 |
39 | 15 717 | 5 736 | 9 981 |
| Всего | 101 | 40 703 | 14 504 | 26 199 |
То есть одним запуском мы получаем не «у меня не открылся сайт», а полноценную матрицу:
             NAT-1   NAT-2   NAT-3   NAT-4  ...
T-Банк         FAIL     OK      OK     FAIL
PyPI             OK     OK    FAIL       OK
Azure portal   FAIL   FAIL      OK     FAIL
Google 204     FAIL     OK      OK       OK
...
Результат дописывается в matrix.tsv по мере выполнения. Если процесс прервался, скрипт читает уже готовые пары (src,url) и продолжает с оставшихся. Поэтому сорокатысячный прогон не приходится начинать заново после каждого SSH timeout или рестарта.
Самое ценное — не FAIL, а Selective FAIL
Грубая статистика 26 тысяч FAIL из 40 тысяч сама по себе почти бесполезна.
В каталоге есть цели, которые плохо подходят для /tool fetch: UDP/QUIC, нестандартные протоколы, endpoints с anti-bot, географическими ограничениями или специфичной HTTP-логикой. Поэтому строка «не работает со всех NAT» ещё ничего не доказывает.
Например, в текущем отчёте есть 225 tags с FAIL на всех 101 source IP. В эту группу попадают YouTube, Telegram, Docker Registry, Apple update endpoints, QUIC-тесты и многое другое. Часть такого результата может быть реальным ограничением, а часть — просто несовпадением метода проверки с протоколом/endpoint.
Гораздо сильнее другой класс результата:
одна и та же цель одновременно FAIL с части SNAT и OK с остальных.
В текущей матрице, например:
Azure portal       FAIL 85 / OK 16
Т-Банк             FAIL 82 / OK 19
Ubuntu archive     FAIL 67 / OK 34
PyPI               FAIL 33 / OK 68
Microsoft          FAIL 24 / OK 77
OpenAI             FAIL 22 / OK 79
Здесь origin точно не может быть просто «мёртв для всех»: в ту же минуту часть наших публичных адресов до него достучалась.
Именно поэтому Selective FAIL стал для нас гораздо более полезной фактурой, чем попытка объявить любой timeout «блокировкой ТСПУ».
Три уровня уверенности
После этих экспериментов мы фактически пришли к трёхслойной модели.
1. NetFlow: AT RISK
Пассивная телеметрия видит необычный сетевой след:
syn_no_ack ↑
short flows ↑
много односторонних соединений
CC-маркеры выглядят нездоровыми
Это повод присмотреться к NAT, но ещё не доказательство недоступности.
2. MikroTik active probe: IMPACT
Тот же destination:
с NAT A → FAIL
с NAT B → OK
Это уже подтверждённая зависимость доступности от source IP.
3. Абонентский connect-check: пользовательская фактура
Если тот же публичный NAT одновременно даёт массовые expected_block=0 failures у реального клиента, мы получаем третью независимую точку подтверждения.
Именно комбинация этих трёх слоёв оказалась намного полезнее любого единственного TSPU_SCORE.
Situation Room: что теперь видно в Grafana
После появления активных проверок мы переделали главный дашборд так, чтобы он показывал не отдельные «аномалии», а состояние всего контура сразу.
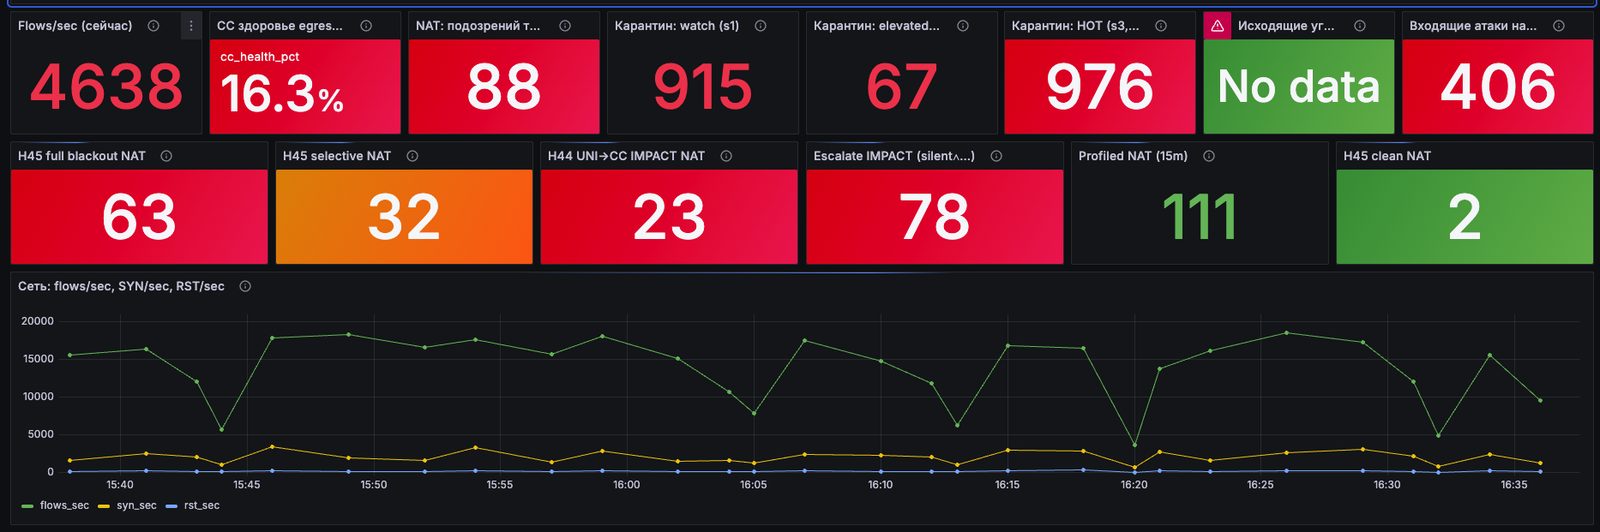
Снимок Situation Room. Цифры — состояние конкретного 15-минутного окна, а не постоянные характеристики сети.
На этом снимке сверху видны основные KPI.
Flows/sec
Текущая интенсивность NetFlow. В кадре — около 4638 flows/sec.
Это скорее индикатор того, что измерительный контур жив и какая сейчас нагрузка, чем метрика блокировки.
CC здоровье egress %
На снимке 16.3%.
Очень важно: это не означает, что работает только 16% Интернета.
Сейчас KPI считается как:
cc_healthy_ok / cc_flows_ok
То есть только среди flow, относящихся к whitelist-каталогу connect-check. Раньше знаменателем ошибочно был весь трафик сети, и плитка почти всегда показывала 1–2%, создавая ложное ощущение тотальной катастрофы.
NAT: подозрений тихий дроп
Количество публичных NAT, которые попали под passive-модель silent_syn_drop.
На снимке — 88.
Это именно кандидаты AT RISK, а не 88 доказанно заблокированных адресов.
Карантин: watch / elevated / HOT
Три стадии soft-quarantine для внутренних клиентов:
s1 watch      — наблюдаем
s2 elevated   — повышенный риск
s3 HOT        — сильный/устойчивый источник шума
На снимке соответственно 915 / 67 / 976.
Здесь важно не путать сущности: карантин относится к inside, который создаёт scan/amp/vpn/malware-like активность. Он не означает, что публичный SNAT уже заблокирован.
Исходящие угрозы (NAT)
Число NAT, за которыми есть активные scanner/amplifier/VPN/malware scores выше порога. На конкретном скриншоте панель показывает No data — это не «угроз нет», а отсутствие результата этой выборки в данном кадре.
Входящие атаки на нас
Количество наших публичных активов, которые сами сейчас являются целями внешних scan/amp/malware-паттернов. На снимке — 406.
Эта метрика нужна в первую очередь для того, чтобы не перепутать нашего шумного абонента с атакой снаружи.
H45/H46: отдельный профиль состояния публичного NAT
Вторая строка Situation Room уже ближе к нашему исследованию:
H45 full blackout NAT      63
H45 selective NAT          32
H44 UNI→CC IMPACT NAT      23
Escalate IMPACT            78
Profiled NAT              111
H45 clean NAT               2
H45 full blackout
Плохими выглядят и основные probe-маркеры, и контроль Cloudflare.
В текущей модели маркеры — Google-family, Apple, Quad9, Blizzard. Если хотя бы один маркер достаточно представлен и имеет healthy <=25%, а Cloudflare тоже <=25%, профиль становится full.
Это модель по NetFlow, а не результат полного /tool fetch-прогона.
H45 selective
Маркер выглядит плохо, но Cloudflare остаётся живым либо данных по нему мало.
Именно этот профиль особенно похож на то, что мы увидели активными тестами: один набор destination перестаёт работать с конкретного source IP, другой продолжает открываться.
H44 UNI→CC IMPACT
UNI здесь — устойчивый односторонний трафик к ресурсам из connect-check, когда запросы уходят, но нормального обратного поведения не видно.
Это ещё один независимый passive-сигнал.
Escalate IMPACT
Эта плитка считается жёстче:
silent_syn_drop
AND
(
    CC suspect
    OR full/selective profile
    OR UNI→CC impact
)
То есть одного silent уже недостаточно — NAT должен одновременно подтвердиться ещё одним слоем.
Profiled NAT и clean NAT
Profiled — адреса, по которым в текущем окне вообще хватило маркерного трафика для классификации.
clean — NAT, где Google-family имеет достаточно samples и здоровый процент (>=40%).
На снимке clean всего 2, что само по себе показывает: текущая пассивная модель ещё требует калибровки и не должна использоваться как «истина без активной проверки».
График SYN/RST тоже никуда не делся
Под плитками остаётся базовая временная диаграмма:
flows/sec
SYN/sec
RST/sec
Она нужна для контекста. Если одновременно с ухудшением reachability NAT резко растёт SYN-rate, но RST остаётся почти на нуле, это очень похоже на уже знакомую картину незавершённого handshake и ретраев.
Но теперь мы не пытаемся по одному этому графику сказать «это ТСПУ». График только объясняет, какой сетевой след сопровождает подтверждённый active-probe FAIL.
Drill-down: из плохого NAT — к конкретному inside
Ниже Situation Room появились две таблицы.
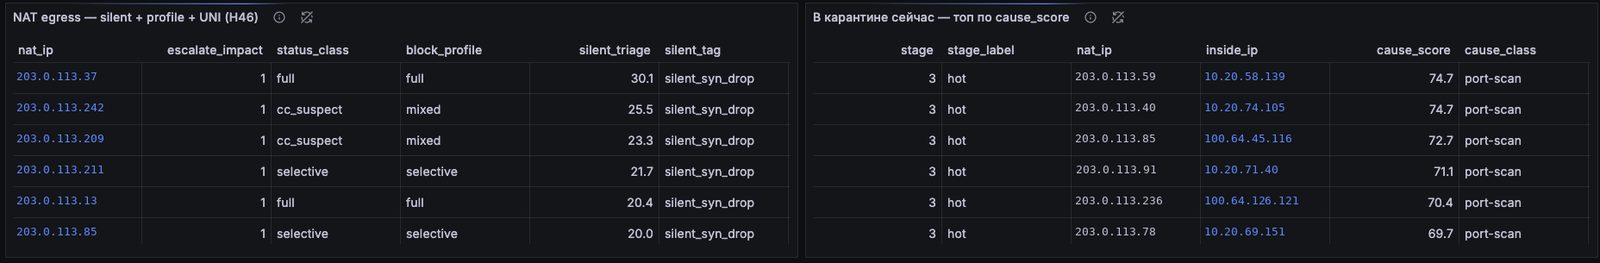
Таблица NAT egress — silent + profile + UNI
В ней сводится всё, что известно про публичный адрес:
| Поле | Что означает |
|---|---|
nat_ip |
публичный SNAT |
escalate_impact |
сработало ли усиленное условие silent AND дополнительное подтверждение |
status_class |
итоговый класс: full, selective, cc_suspect, uni_cc, silent_only, watch |
block_profile |
H45-профиль full/selective/clean/mixed/unknown |
silent_triage |
балл passive-модели тихого SYN-drop |
silent_tag |
текстовая причина попадания в silent-кандидаты |
google_healthy_pct |
здоровье Google-family маркеров |
apple_healthy_pct |
здоровье Apple-маркеров |
quad9_healthy_pct |
здоровье Quad9 |
blizzard_healthy_pct |
здоровье Battle.net/Blizzard |
cf_healthy_pct |
контроль Cloudflare |
uni_cc_impact |
найден ли устойчивый односторонний поток к CC-целям |
uni_flows |
сколько таких flows увидели |
on_cc_suspect |
попал ли NAT в connect-check passive suspect |
profile_tag |
человекочитаемое объяснение профиля |
Например, строка
203.0.113.37
escalate_impact=1
status_class=full
block_profile=full
silent_triage=30.1
silent_tag=silent_syn_drop
означает не «мы доказали блокировку», а гораздо аккуратнее:
этот SNAT одновременно выглядит как silent-drop по NetFlow и имеет плохой маркерный egress-профиль; его нужно поднять в active probe.
И это принципиально другой уровень аккуратности вывода.
cause_score: кто внутри NAT создаёт шум
Правая таблица отвечает уже на другой вопрос: если NAT плохой или находится под риском, кто именно из внутренних адресов генерирует наиболее подозрительный профиль?
Поля:
stage
stage_label
nat_ip
inside_ip
cause_score
cause_class
cause_tag
cause_score — не «вероятность блокировки». Это сумма нескольких компонентов поведения inside:
scan_comp
+ amp_comp
+ vpn_comp
+ mal_comp
с отдельным p2p_dampen, чтобы обычный BitTorrent не превращался автоматически в «портсканер».
cause_class выбирает наиболее характерный профиль:
port-scan
host-scan
amp-probe
ssh-vpn-fanout
malware-ports
syn-volume
mixed-noise
На текущем снимке самые высокие строки имеют cause_class=port-scan и score около 70–75.
Смысл таблицы очень практический: сначала мы находим плохой публичный NAT, потом проваливаемся внутрь и смотрим, кто за ним создаёт основную аномальную активность.
Но эти два факта специально не склеиваются в причинно-следственное утверждение. Шумный inside может быть причиной риска, а может просто жить за уже деградировавшим адресом. Для доказательства причинности нужен временной эксперимент.
Следующий шаг: не ждать естественного трафика
Пассивная H45-модель имеет фундаментальное ограничение: если с конкретного NAT прямо сейчас никто не обращается к Apple, Quad9 или Google, у нас просто нет samples и профиль становится unknown.
Логичный следующий этап — создавать небольшой контролируемый фон активных проб именно с проблемных NAT.
Не полный прогон 403×101 каждые пять минут — это было бы бессмысленной нагрузкой. Достаточно короткого набора стабильных маркеров.
Например:
control:
  Cloudflare

markers:
  Google generate_204
  Apple
  Quad9
  Battle.net

incident target:
  URL, на котором уже поймали selective FAIL
Когда Situation Room переводит адрес в full/selective/escalate, внешний scheduler может поставить временное задание:
NAT 203.0.113.x
каждые 5 минут
в течение 2 часов
6–10 probe destinations
Каждый результат сохраняем примерно так:
ts, gw, nat_ip, probe, result
И дальше появляется временная шкала:
12:00  NAT A  google FAIL  CF OK
12:05  NAT A  google FAIL  CF OK
12:10  NAT A  google FAIL  CF OK
12:15  NAT A  google OK    CF OK
Это даёт то, чего нам до сих пор не хватало: время входа в деградацию и время восстановления конкретного публичного IP.
Причём такую задачу лучше создавать на jump/collector, а MikroTik оставлять только исполнителем короткого /tool fetch src-address=.... Так мы не раздуваем scheduler на edge и можем централизованно ограничить число одновременных проб.
Как это теперь выглядит целиком
Мы начинали с очень простой схемы:
жалоба
→ смотрим NetFlow
→ видим много SYN
→ наверное, ТСПУ
Сейчас рабочий pipeline уже другой:
NetFlow
  ↓
AT-RISK NAT
  ↓
H45/H44/CC correlation
  ↓
active /tool fetch с того же src-address
  ↓
сравнение с соседним clean NAT
  ↓
если нужно — абонентский connect-check
  ↓
inside attribution по cause_score
  ↓
повторные probes до восстановления
Это заметно скучнее красивой кнопки «Определить блокировку ТСПУ».
Зато гораздо ближе к нормальной инженерной диагностике.
Что мы можем утверждать уже сейчас
После полной матрицы мы достаточно уверенно можем говорить следующее.
Первое. Reachability действительно бывает привязана к конкретному публичному SNAT: один и тот же ресурс одновременно доступен с одних наших адресов и недоступен с других.
Второе. Это воспроизводится не на одном «сломавшемся» MikroTik. Selective FAIL мы получили на нескольких edge, причём набор проблемных NAT у каждого свой.
Третье. Пассивный NetFlow полезен для поиска кандидатов, но заметно переоценивает full/selective, если использовать его без активной проверки. Поэтому silent, H45 и cause_score — это триггеры расследования, а не финальный вердикт.
Четвёртое. Самым сильным операционным тестом оказался не абсолютный FAIL, а дифференциальный:
одна цель
одно время
один GW
NAT A = FAIL
NAT B = OK
Именно его мы теперь хотим превратить из ручного расследования в постоянный автоматизированный контур.
И что всё ещё нельзя утверждать
Даже 40 703 probes не дают нам права написать:
26 199 соединений заблокировал ТСПУ
Мы не видим внутреннего правила фильтра и не знаем причину каждого отдельного timeout.
На результат влияют:
- сам destination;
- anti-bot/CDN;
- географические политики;
- несовпадение
/tool fetchс реальным протоколом; - временные сетевые ошибки;
- DPI/ТСПУ;
- внешние системы защиты, которые тоже принимают решения по публичному IP.
Но теперь у нас есть способ убрать из уравнения значительную часть этих переменных: одновременно сравнивать несколько source IP на одном и том же пути.
Именно поэтому следующая часть исследования уже не столько про поиск «секретного признака ТСПУ», сколько про нормальную постановку эксперимента.
Мы всё ещё смотрим на тень чёрного ящика.
Просто теперь можем подсветить её сразу со ста разных адресов.
Технические артефакты этой части
Скрипты выложены для скачивания:
- buildccprobe_urls.py — сбор каталога probe URL;
- mtccfullmatrixprobe.py — full-matrix probe.
mt_cc_full_matrix_probe.py автоматически:
- получает локальные адреса MikroTik;
- извлекает
srcnat to-addresses; - строит допустимый набор source IP;
- запускает
/tool fetchдля каждой парыsrc × URL; - пишет инкрементальный
matrix.tsv; - умеет продолжать прерванный прогон;
- строит
matrix_summary.csvи fail-rate по каждому SNAT.
Дисклеймер. Это эксплуатационное исследование сетевой доступности на стороне оператора связи. Активные probes выполняются к обычным публичным ресурсам с собственных адресов оператора и используются для диагностики. Наличие source-dependent FAIL само по себе не доказывает применение конкретного правила ТСПУ: вывод делается только как наблюдение сетевого поведения.