Четвёртая часть исследования NetFlow и странных деградаций доступа. В первой части мы научились видеть массовый silent SYN-drop на публичных CGNAT. Во второй — разобрались, почему у ТСПУ нет одного сетевого следа. В третьей — перешли от пассивного NetFlow к активной матрице и научились находить Selective FAIL.
В предыдущей части мы дошли от пассивного NetFlow до активной матрицы: стали проверять один и тот же набор ресурсов с каждого публичного SNAT и получили важный для дальнейшей работы эффект — одна и та же цель в одно и то же время может быть доступна с одного нашего публичного адреса и недоступна с соседнего.
На этом месте можно было бы остановиться и объявить виноватым ТСПУ. Именно этого мы делать не стали.
Следующие несколько дней ушли на попытки сломать собственную гипотезу. Мы проверяли маршрутизацию, разные аплинки, RTT, GeoIP, публичные blocklist, текущую нагрузку абонентов, влияние самого connect-check и даже выясняли, не врёт ли нам /tool fetch на MikroTik.
В результате часть красивых объяснений пришлось выбросить. Зато оставшаяся картина стала интереснее: состояние действительно выглядит привязанным к публичному source IP, способно изменяться во времени, исчезать после простоя и возвращаться после нагрузки. Но теперь у нас гораздо лучше определены границы того, что именно мы наблюдаем и что ещё только предполагаем.
Важная оговорка на всю статью: full, selective, silent, H45, H46, cause_score и другие названия ниже — наши внутренние диагностические классы, а не термины или статусы ТСПУ. Они описывают наблюдаемое поведение сети и нужны для автоматизации расследования.
Откуда вообще появилась гипотеза про «память» адреса
Самое странное наблюдение появилось не в Grafana, а в эксплуатации.
На одном из роутеров публичного Wi‑Fi за NAT находится порядка 500–600 клиентов. Поведение повторяется циклически:
NAT-A работает
   ↓
через некоторое время часть ресурсов перестаёт открываться
   ↓
NAT-A меняем на NAT-B
   ↓
с NAT-B всё снова нормально
   ↓
через день-два NAT-B начинает деградировать
   ↓
переходим на NAT-C
   ↓
к этому моменту NAT-A, который несколько дней не использовался,
снова работает нормально
В июне 2026 года похожая массовая проблема уже была. После изменения политик фильтрации ситуация стала приемлемой. В конце августа деградация массово вернулась.
Для одиночных белых адресов юридических и физических лиц такого эффекта практически не видно. А там, где за одним публичным IP сидят десятки или сотни пользователей, адрес через какое-то время может перейти от отдельных проблем к очень тяжёлой деградации связности.
Это ещё не доказывает конкретный механизм. Но такое поведение плохо похоже на обычную статическую проблему маршрутизации: маршрут сам по себе не должен «очищаться» после 2–3 суток отсутствия абонентского трафика.
Рабочая гипотеза стала такой: где-то в тракте существует динамическое состояние, связанное с публичным source IP. Это может быть список, набор счётчиков, классификатор, профиль или комбинация механизмов. Слово «обучается» здесь лучше использовать осторожно: для наблюдаемого эффекта совершенно не обязательно машинное обучение. Достаточно обычной логики вида «наблюдать → классифицировать → добавить в список/политику → удалить по TTL».
Открытые материалы по архитектуре ТСПУ и отраслевые наблюдения допускают подобную модель: распознанные события могут попадать в централизованный контур и превращаться в очищенные IP+port-списки или другие политики фильтрации. Но публичного доказательства, что конкретно наши NAT-IP проходят именно такой pipeline, у нас нет. Поэтому ниже мы отделяем факты от интерпретации.
Короткая хроника: как менялась версия происходящего
| Дата |
Что произошло |
Что это нам дало |
| июнь 2026 |
массовая деградация, затем после изменения политик ситуация заметно улучшается |
первый признак, что поведение может зависеть не только от нашей сети |
| конец августа |
проблема возвращается массово |
начинаем системное исследование |
| 8–10 сентября |
NetFlow → ClickHouse → Grafana, поиск silent, short, SYN/RST, атрибуция к SNAT/inside |
научились находить подозрительные публичные адреса и тех, кто за ними создаёт шум |
| 10 сентября |
запускаем /tool fetch прямо с нужного src-address MikroTik |
впервые измеряем reachability от конкретного NAT-IP |
| 10–11 сентября |
полная матрица: 101 source × 403 цели = 40 703 probes |
обнаруживаем массовый Selective FAIL, где одна цель отличается только source IP |
| 11 сентября, ~17:45 |
контроль .34 против .4 к одному connectivitycheck.gstatic.com:443 |
внешний наблюдатель на ТСПУ видит ICMP от обоих, но TCP/443-сессию только с рабочего source |
| 11 сентября, ~17:57 |
соседняя пара .54 OK / .55 BAD к той же цели |
исключаем объяснение «это разные префиксы» |
| 11 сентября, ~18:53 |
агрессивно прогоняем 403 цели с рабочего .54, пытаясь «сжечь» его тестом |
адрес не ломается; гипотеза, что сам connect-check быстро создаёт проблему, не подтверждается |
| 11 сентября, ~19:12 |
находим разные RTT и traceroute для разных source к одному Google IP |
L3 path действительно зависит от source |
| 11 сентября, ~19:39 |
отключаем BGP с аплинк-A, маршрут уходит через аплинк-B |
путь меняется, но selective TCP не лечится → аплинк/маршрут не root cause |
| 11 сентября, ~20:15 |
сравниваем текущий трафик BAD и OK NAT |
находится «тихий BAD» и «шумный OK» → текущий шум не объясняет состояние сам по себе |
| 14 сентября, утро |
повторяем матрицу/маркер, .55/.22/.30 снова среди худших |
эффект живёт дольше единичного теста |
| 14 сентября, ~14:00 |
ряд адресов сообщается как «починенный», маркер на .55/.22/.30 начинает проходить |
наблюдаем реальный heal без замены SNAT |
| 14 сентября, ~14:04 |
полный CC на 11 адресах: fail-rate падает на ~13–17 п.п. у известных BAD |
улучшение видно не только на одном URL |
| 14 сентября, ~15:07 |
разбираем 8.8.8.8:443: fetch говорит FAIL, conntrack показывает полноценный TCP exchange |
исправляем важную ошибку методики: fetch FAIL ≠ TCP FAIL |
| 14 сентября, ~17:45 |
.55 и .22 снова full + silent + escalate, .30 selective |
на этой выборке восстановление оказывается временным — часы, а не дни |
| 14 сентября, ~17:59 |
проверяем GeoIP |
наш jump-host действительно выглядит заграницей, но основные CGNAT-пулы во всех рабочих БД RU → это не объясняет selective NAT |
| 15 сентября |
уточняем реальную топологию: на исследуемом тракте ТСПУ находится после CGNAT |
pre-NAT объяснение для нашей площадки снимается: публичный NAT-IP непосредственно виден ТСПУ |
| 15 сентября, день |
переводим GW1 с набора статических 1:1 src-nat на action=same, затем расширяем непрерывный пул до 203.0.113.2–31 |
впервые выравниваем число активных inside между 30 публичными IP |
| 15 сентября, 15:12–15:28 |
NetFlow показывает 39–41% inside одновременно на двух NAT и сильный перекос |
это не same распределяет плохо — старые conntrack-маппинги ещё живы |
| 15 сентября, ~15:35 |
после очистки старых conntrack: 2023 активных inside / 30 IP, dual-NAT=0%, среднее 67.4, min–max 59–76, CV=0.06 |
получаем чистый эксперимент с почти одинаковым числом клиентов на каждом публичном IP |
| 15 сентября |
при одинаковом числе inside flows всё равно отличаются в разы: .26 ≈22.8k/5m против .9 ≈7.0k/5m |
«сколько абонентов за NAT» недостаточно; важен профиль нагрузки |
| 15 сентября |
на GW3 один 100.64.72.64 создаёт ≈1.79 млн flows/15m, 98.4% UDP и >10 тыс. destinations через .92 |
один абонент способен полностью исказить профиль NAT-IP даже при обычном размере когорты |
| 15 сентября, ~15:41 |
после ещё одной пачки «направили / починили» массовый поток жалоб стихает до единичных |
фиксируем фазу heal/штиля, не пытаясь реконструировать закрытый алгоритм фильтра |
Получилась полезная для инженерного расследования ситуация: каждый новый эксперимент не столько добавлял доказательств одной версии, сколько вычёркивал слишком простые объяснения.
Самый сильный тест — не тысяча FAIL, а одна правильная пара
Полная матрица хороша для поиска кандидатов, но наиболее убедительной оказалась очень простая постановка:
один destination
один момент времени
один тип запроса
одна операторская инфраструктура
меняется только source IP
Пара №1
203.0.113.34 → connectivitycheck.gstatic.com:443 = OK
203.0.113.4  → connectivitycheck.gstatic.com:443 = FAIL
С обоих адресов были запущены ICMP-пробы и одинаковые HTTPS-попытки.
Техническая поддержка со стороны системы наблюдения сообщила важный результат: ICMP виден с обоих source, а сессии TCP/443 — только с 203.0.113.34.
Это ценно тем, что наблюдение сделано не только нашим connect-check. С нашей стороны попытки одинаковы, destination тот же, ICMP проходит у обоих, а поведение TCP различается по source.
Пара №2 — буквально соседние адреса
Чтобы дополнительно убрать разговор про «разные сети», на другом шлюзе выбрали соседей:
203.0.113.54 → connectivitycheck.gstatic.com:443 = OK
203.0.113.55 → connectivitycheck.gstatic.com:443 = FAIL
Оба адреса находятся рядом, работают через один GW, target тот же.
Именно такие пары сейчас важнее любой агрегированной цифры FAIL=64%: они уменьшают число переменных в эксперименте почти до одной.
Как мы поддерживаем постоянную активность с GOOD и BAD адресов
Для ручного расследования недостаточно один раз выполнить fetch. Нужен след во времени, чтобы сторона, наблюдающая ТСПУ, могла поймать те же пакеты и сопоставить их со своими счётчиками.
На MikroTik появились две одинаковые задачи — контрольная и проблемная. Пример для соседей .54/.55:
/system script add name=cc-probe-ok owner=admin policy=read,write,test source={
:local src "203.0.113.54"
:local dstip "connectivitycheck.gstatic.com"
:local url ("https://" . $dstip . "/generate_204")
:do {
  :local r [/tool fetch url=$url src-address=$src duration=2s keep-result=no check-certificate=no as-value]
  :log warning ("cc-probe OK src=" . $src . " dstip=" . $dstip . " status=" . ($r->"status"))
} on-error={ :log warning ("cc-probe OK src=" . $src . " dstip=" . $dstip . " FAIL") }
}

/system script add name=cc-probe-bad owner=admin policy=read,write,test source={
:local src "203.0.113.55"
:local dstip "connectivitycheck.gstatic.com"
:local url ("https://" . $dstip . "/generate_204")
:do {
  :local r [/tool fetch url=$url src-address=$src duration=2s keep-result=no check-certificate=no as-value]
  :log warning ("cc-probe BAD src=" . $src . " dstip=" . $dstip . " status=" . ($r->"status"))
} on-error={ :log warning ("cc-probe BAD src=" . $src . " dstip=" . $dstip . " FAIL") }
}

/system scheduler add name=cc-probe-ok  interval=1m on-event="/system script run cc-probe-ok"
/system scheduler add name=cc-probe-bad interval=1m on-event="/system script run cc-probe-bad"
Так в логах возникает простой временной ряд:
18:50 .54 finished   .55 connecting
18:51 .54 finished   .55 connecting
18:52 .54 finished   .55 connecting
18:57 .54 finished   .55 finished
18:59 .54 finished   .55 connecting
19:00 .54 finished   .55 finished
19:01 .54 finished   .55 connecting
Интересный нюанс: BAD не всегда абсолютно мёртвый. .55 иногда на одну попытку оживает, после чего снова возвращается в connecting. Поэтому бинарный ярлык «работает/не работает» недостаточен — нам нужен timeline и доля успешных попыток.
Следующая автоматизация очевидна: когда Situation Room переводит NAT в selective/full/escalate, создавать короткую probe-задачу автоматически и одновременно выбирать соседний clean/control source. Полную матрицу из 403 URL при этом гонять не надо — для долговременного мониторинга достаточно нескольких маркеров.
Могли ли мы сами «сжечь» адрес своим тестом?
После первых матриц возникла неприятная версия: а что, если сотни активных connect-check сами создают тот профиль трафика, после которого адрес попадает под более жёсткую фильтрацию?
Подозрение усилилось из-за .34: адрес был рабочим, затем маркер перестал проходить. Но разбор времени показал, что flip произошёл примерно за 16 минут до запуска полной матрицы с этого адреса.
Чтобы проверить идею напрямую, взяли заведомо рабочий .54 и намеренно прогнали с него все 403 URL достаточно агрессивно, шестью workers.
Результат:
до матрицы    .54 → marker = finished
во время      .54 → marker = finished
сразу после   .54 → marker = finished
T+10 минут    .54 → marker = finished
Полная матрица дала 135/403 OK_TCP, но контрольный Google marker продолжил работать.
Вывод: на горизонте этого эксперимента версия «403 probes сами быстро портят NAT-IP» не подтвердилась.
Это не означает, что любой объём probes абсолютно безопасен. Но конкретный эффект, который мы наблюдаем сутками на NAT под абонентской нагрузкой, не воспроизвёлся простой короткой матрицей.
Красивая гипотеза про маршрут — и как мы её сломали
Следующей зацепкой стал ping.
К одному и тому же connectivitycheck.gstatic.com разные source IP давали устойчиво разные RTT и traceroute. Для четырёх адресов получилось примерно так:
| source |
роль на тот момент |
avg RTT |
203.0.113.34 |
OK → позже burned |
22.2 ms |
203.0.113.4 |
BAD |
26.3 ms |
203.0.113.54 |
OK |
27.4 ms |
203.0.113.55 |
BAD |
22.6 ms |
Traceroute после второго hop расходился по разным веткам к Google.
Сразу родилась версия: возможно, часть source попадает на один ingress/аплинк, часть — на другой, и проблема вообще не в состоянии IP, а в неудачном пути.
На расширенной выборке правило «27 ms = OK, 22 ms = BAD» даже совпало в 13 случаях из 16. Красиво. И неправильно как универсальное объяснение: нашлись контрпримеры — быстрый OK и медленные BAD.
Жёсткий path-эксперимент: отключили аплинк-A
Чтобы не гадать по RTT, на короткое окно выключили BGP с аплинком-A.
Это сработало именно как path-тест:
до:
наша сеть → аплинк-A → Google

после:
наша сеть → аплинк-B → Google
аплинк-A исчез из traceroute у всех четырёх source. RTT перераспределился. То есть маршрут реально изменился.
Но selective TCP не исчез:
| source |
после смены пути |
.34 |
connecting ×3 |
.4 |
connecting ×3 |
.54 |
finished ×3 |
.55 |
один finished, затем снова connecting |
Это очень полезный отрицательный результат.
Маршрутизация и source-dependent path у нас действительно есть. Но конкретная ветка через аплинк-A не является достаточным объяснением selective FAIL.
Путь может влиять на измерения и отдельные destinations, поэтому выкинуть routing из анализа нельзя. Но версия «всё из-за одного аплинка» эксперимент не пережила.
«Виноват шумный абонент за NAT» — тоже оказалось слишком просто
Изначальная практическая цель NetFlow-контура была вполне разумной: найти inside, который создаёт scan/amp/VPN-like/аномальный профиль, и понять, связан ли он с деградацией общего SNAT.
Мы для этого и строили cause_score, классы port-scan, host-scan, amp, счётчики SYN, fan-out и т.д.
Но сравнение конкретных адресов дало неприятный для простой модели результат:
| SNAT |
состояние |
flows за ~2h |
insides |
заметный cause |
.55 |
BAD |
~365k |
82 |
тяжёлые port-scan/host-scan/amp |
.54 |
OK |
~73k |
61 |
тоже заметный host-scan/amp |
.4 |
BAD/flaky |
~184 |
6 |
нет culprits ≥18 |
.34 |
heal |
~579 |
1 |
фактически только наши probes |
С одной стороны, .55 действительно выглядит как отличный кандидат на «NAT испортили абоненты».
С другой — .4 был проблемным почти без текущего шума, а .54 мог быть довольно шумным и при этом оставаться рабочим.
Отсюда более аккуратная модель:
аномальный/концентрированный трафик
          ↓
может повышать вероятность изменения состояния public IP
          ↓
НО текущее состояние public IP не обязано совпадать
с текущим шумом за последние 15 минут / 2 часа
Если у состояния есть TTL, история или внешняя обработка, это как раз ожидаемо. Источник, который создал проблему вчера, сегодня уже может молчать, а метка на публичном IP ещё жить.
Поэтому cause_score остаётся очень полезным для поиска причины и remediation, но не является доказательством текущего блока.
Что сейчас показывает Grafana
Ниже — Situation Room в одном из рабочих срезов исследования.
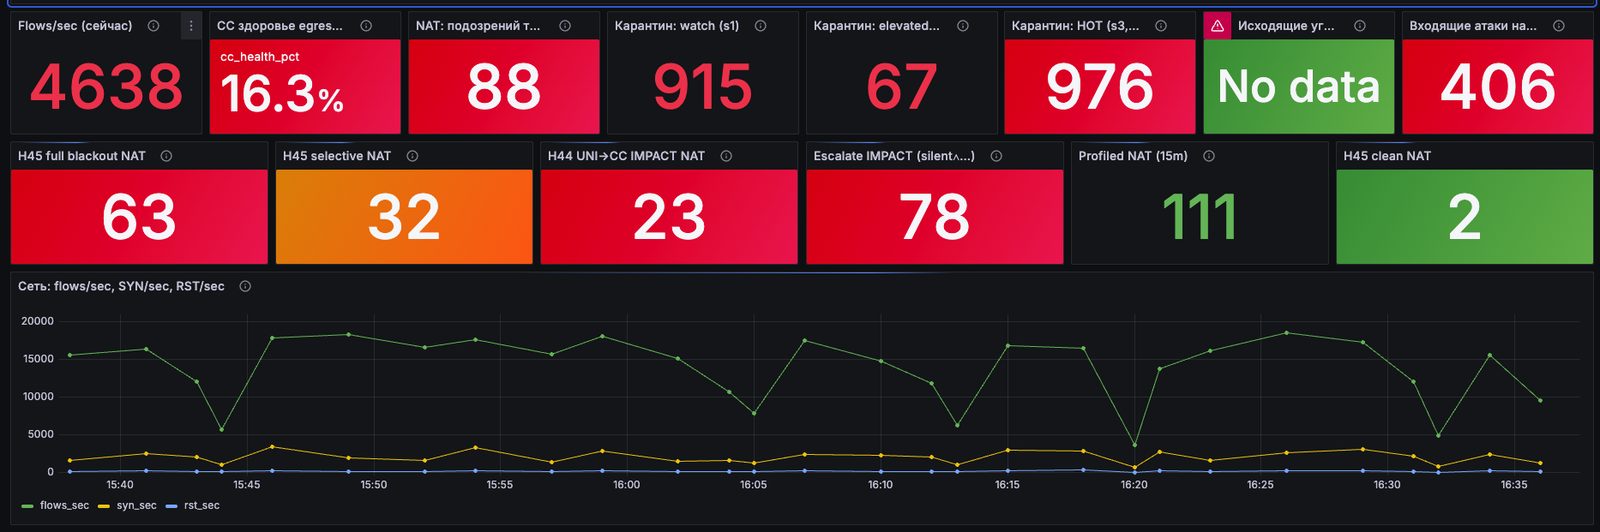
Эта панель специально смешивает пассивные и активные признаки, но важно правильно читать поля.
Flows/sec
Обычная интенсивность NetFlow. Нужна прежде всего как sanity check: жив ли сборщик и не объясняется ли всё внезапным провалом телеметрии.
CC здоровье egress %
Это не процент работающего Интернета. Это доля healthy-попыток внутри нашего connect-check/CC-профиля. Например, 16.3% на скриншоте означает тяжёлое состояние именно выбранного набора контрольных flow, а не то, что абонентам доступно только 16% сайтов.
NAT: подозрений тихий drop
Количество публичных NAT, у которых пассивная телеметрия похожа на silent SYN-drop: много попыток без ожидаемого ответного продолжения.
Это кандидат на проверку, не приговор.
H45 full blackout NAT
NAT, для которых наш профиль маркеров выглядит как почти полный провал.
H45 selective NAT
Более интересный класс: одни маркеры/цели проходят, другие нет. Именно отсюда удобно искать пары GOOD/BAD source к одному destination.
H44 UNI→CC IMPACT NAT
Корреляция пользовательского unreachable/UNI-сигнала с проблемой в контрольных ресурсах. Это попытка связать абонентскую жалобу и сетевую фактуру.
Escalate IMPACT
Внутренний флаг «уже пора не просто наблюдать, а разбирать этот NAT»: одновременно сходятся несколько независимых признаков.
Profiled NAT
Адреса, по которым накопилось достаточно данных для классификации. Нельзя сравнивать full/selective с общим числом всех адресов, если часть из них в текущем окне просто не имела нужного трафика.
H45 clean NAT
Контрольные адреса, которые в этом же профиле выглядят здоровыми. Они особенно полезны не как KPI, а как источник контрольной пары.
Drill-down: от публичного NAT к конкретному inside
Вторая таблица отвечает уже не на вопрос «какой NAT плохой?», а на «кто за ним сейчас создаёт наиболее подозрительный профиль?».
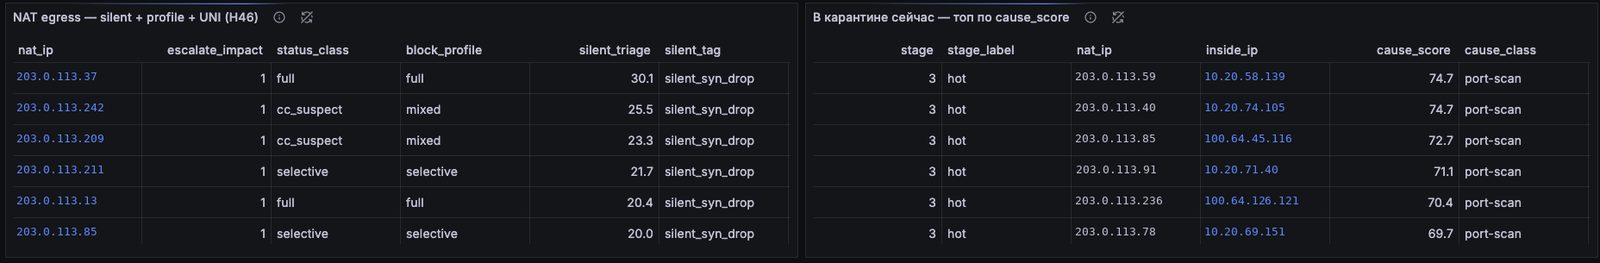
Слева:
nat_ip — публичный SNAT;escalate_impact — сошлись ли критерии эскалации;status_class — общий внутренний класс (full, selective, cc_suspect и т.п.);block_profile — агрегированный профиль активных/пассивных проверок;silent_triage — численная сила silent-кандидата;silent_tag — текстовая интерпретация, например silent_syn_drop.
Справа:
stage / stage_label — наша стадия карантина/наблюдения;nat_ip — публичный адрес;inside_ip — внутренний клиент за ним;cause_score — скоринг поведения;cause_class — что именно дало баллы: например port-scan.
Это две разные оси. Плохой cause_score у абонента не означает автоматически, что внешний адрес уже заблокирован. И наоборот: BAD NAT может какое-то время не иметь яркого текущего culprit.
14 сентября: «починили». И мы получили почти идеальный естественный эксперимент
Утром 14 сентября повторный прогон снова показывал знакомую картину. На GW2 среди худших были, в частности:
203.0.113.55   fail 77.7%
203.0.113.22   fail 76.7%
203.0.113.30   около 79% в предыдущем полном ряду
Отдельный HTTPS-marker к connectivitycheck.gstatic.com также не проходил с .55/.22/.30, тогда как соседний .54 работал.
Около 14:00 MSK появился важный внешний триггер: ряд адресов был обозначен как «починенный».
Мы тут же повторили проверку.
Маркер реально ожил
На .55, .22, .30 HTTPS к тому же connectivitycheck.gstatic.com/generate_204 стал проходить. Причём адреса не были просто удалены из src-nat: они оставались реальными активными SNAT.
Полная матрица тоже улучшилась
Через несколько минут запустили 403 URL для 11 адресов из списка. Для трёх, по которым был хороший baseline, изменение получилось заметным:
| source |
до |
после |
изменение |
.55 |
77.7% FAIL |
62.3% |
−15.4 п.п. |
.22 |
76.7–78.7% |
63.3% |
−13…15 п.п. |
.30 |
79.2% |
62.5% |
−16.7 п.п. |
То есть это было не просто «один удачный запрос». Улучшение видно по сотням целей.
Но через несколько часов состояние снова стало плохим
К ~17:45 тот же мониторинг показывал:
.55 → full + silent + escalate
.22 → full + silent + escalate
.30 → selective
При этом Google-family ACK% у .55/.22 оставался низким.
Для статьи это один из самых интересных результатов всей серии:
BAD
 ↓
внешнее вмешательство / heal
 ↓
marker OK + общий fail-rate заметно лучше
 ↓
несколько часов под нагрузкой
 ↓
снова full/selective/silent
Мы не знаем внутреннего действия, которое было выполнено со стороны фильтра. Поэтому нельзя писать «адрес удалили из такого-то списка». Но сам heal → re-degrade наблюдается инструментально.
И он очень хорошо рифмуется с эксплуатационной ротацией публичного Wi‑Fi, только там естественный период восстановления был порядка 2–3 дней.
Ошибка, которую полезно было поймать: fetch FAIL не равен TCP FAIL
Чем больше автоматизации, тем опаснее неправильный базовый примитив.
В каталоге был удобный IP-literal canary:
https://8.8.8.8/
MikroTik /tool fetch стабильно возвращал WRAP_FAIL. Если смотреть только на него, хочется записать «TCP/443 не проходит».
Мы полезли в conntrack и увидели совершенно другую картину:
src=203.0.113.54:38321 dst=8.8.8.8:443 tcp-state=time-wait
orig-packets=12  repl-packets=9

src=203.0.113.22:53237 dst=8.8.8.8:443 tcp-state=time-wait
orig-packets=12  repl-packets=9
То есть TCP handshake состоялся, данные в обе стороны были, соединение дошло до time-wait. Ошибка произошла выше TCP — на уровне TLS/HTTP/fetch-семантики IP-literal.
Более того, в тот же момент через те же SNAT были реальные абонентские established к 8.8.8.8:443.
После этого матричный скрипт пришлось научить разделять:
OK_FETCH       /tool fetch закончил запрос нормально
OK_TCP         fetch не закончил, но conntrack видит ответный TCP
FAIL           нет подтверждения успешного fetch или TCP-reply
FAIL_TIMEOUT   истёк probe timeout
Это важный кусок методологии: активный тест должен мерить именно тот уровень сети, о котором мы делаем вывод.
curl, fetch, браузер, TCP connect, ICMP и NetFlow отвечают на разные вопросы. Смешивать их в один бинарный OK/FAIL нельзя.
Почему «225 ресурсов не работают нигде» — плохое доказательство
В первой матрице были сотни тегов, которые FAIL на всех source.
Интуитивно хочется сказать: «вот огромный список заблокированного».
Но именно после эксперимента с 8.8.8.8 мы стали гораздо осторожнее.
Если endpoint одинаково не проходит со всех адресов, причина может быть любой:
- специфика самого
/tool fetch;
- TLS к IP вместо hostname/SNI;
- UDP/QUIC, который мы проверяем не тем способом;
- anti-bot;
- GeoIP;
- реальная блокировка ресурса;
- политика самого destination;
- особенности сети конкретного GW.
Поэтому в доказательной части мы теперь ставим выше не full FAIL everywhere, а selective difference:
тот же endpoint
тот же протокол
тот же момент
source A = OK
source B = FAIL
А затем, где возможно, подтверждаем это conntrack/NetFlow/внешним наблюдателем.
GeoIP: гипотеза оказалась полезной, но не так, как ожидалось
Ещё одна версия: может быть, часть наших адресов для системы выглядит как зарубежные, и поэтому к ним применяются иные политики.
Проверили 23 наших /24 сразу по нескольким GeoIP/RIR источникам.
Результат:
- 20/23 во всех рабочих базах выглядят как RU;
- отдельные расхождения есть у трёх неосновных пулов;
- основные исследуемые CGNAT-пулы — RU;
- адреса из «починенной» группы тоже в рабочих базах RU.
То есть GeoIP не объясняет выборочную разницу .54/.55 или .34/.4.
Зато обнаружилась методологическая ловушка: наша аналитическая jump-машина сама выходит в Интернет с адреса зарубежного хостера, который внешние сервисы видят как CZ или DE. Значит, проверять с неё доступность российских ресурсов как с «нейтрального русского клиента» нельзя.
Это хороший пример того, как гипотеза может не объяснить исходную проблему, но всё равно найти ошибку в экспериментальной установке.
Топология на нашей площадке: ТСПУ находится после CGNAT
Здесь в ходе расследования появилась принципиально важная поправка к ранней версии статьи. Для конкретно исследуемого тракта наша сеть точка включения ТСПУ находится после CGNAT.
То есть фактическая последовательность такая:
абоненты / private inside
          ↓
        CGNAT
          ↓
  публичный NAT-IP
          ↓
         ТСПУ
          ↓
       Интернет
Это означает, что объяснение «ТСПУ принимает решение до NAT и публичного source вообще не видит» к нашей площадке не относится. На вход ТСПУ приходит уже пост-NAT пакет, где source — тот самый 203.0.113.x.x, который мы меняем в paired tests.
Это заметно усиливает ценность экспериментов .54/.55, .34/.4 и ротации Wi‑Fi NAT: публичный NAT-IP для ТСПУ — не просто удобная координата нашего NetFlow, а непосредственно наблюдаемый сетевой признак.
При этом важно не сделать следующий слишком большой прыжок. Из этого всё ещё нельзя вывести, что внутри ТСПУ существует именно таблица «репутации IP» и что решение ключится только по src_ip. Система может учитывать комбинацию признаков:
src IP × destination;- destination port / протокол;
- число и частоту новых соединений;
- SYN-rate и незавершённые рукопожатия;
- fan-out по адресам и портам;
- SNI/протокольные признаки;
- временные окна и историю активности;
- несколько разных политик одновременно.
Поэтому аккуратная формулировка такая: на нашей площадке ТСПУ видит публичный CGNAT source и агрегированный за ним профиль трафика; наши эксперименты показывают устойчивую зависимость reachability от этого source, но точный внутренний ключ и алгоритм классификации нам неизвестны.
Раннюю гипотезу H83 про pre-NAT размещение для нашей схемы мы оставили в журнале именно как отвергнутую: это хороший пример того, зачем в расследовании сверять публичные типовые схемы с реальной топологией своей сети.
У проблемы, похоже, несколько временных масштабов
Параллельный поиск по свежим обсуждениям хостеров дал ещё одну полезную альтернативу. Там встречается другой паттерн: кратковременный cooldown по IP клиента и конкретному направлению, порядка десяти минут. Клиент меняет IP или ISP — соединение снова идёт; через несколько минут исходный адрес тоже отпускает.
Это похоже на наш selective fail формой, но не длительностью. Поэтому мы больше не хотим складывать всё в один класс «IP испортился».
Для анализа ввели три временных бакета fail-окон:
≤ 15 мин       → h84_like: короткий cooldown
15–120 мин     → mid
≥ 120 мин      → h80_like: sticky / многочасовое состояние
И написали отдельный bucket_snat_fail_windows.py, который строит 5-минутный ряд по Google-family ACK% для конкретного public egress, склеивает соседние fail-бакеты и считает длительность непрерывных окон.
Первый smoke по .55 и контрольному .54 оказался особенно полезен. На .55 видны не только короткие всплески: присутствуют окна порядка 115 минут и около 245 минут. То есть наблюдаемая 14 сентября деградация больше похожа на многочасовой/sticky класс, чем на чистый десятиминутный cooldown. У .54 при этом тоже встречаются отдельные короткие и даже длинные плохие окна — ещё одно напоминание, что бинарный ярлык GOOD/BAD слишком груб.
Теперь для каждого инцидента имеет смысл хранить не только fail%, но и распределение длительностей непрерывных fail-серий. Если окажется, что короткие 5–15-минутные окна и многочасовые реблоки статистически различаются по destinations или по профилю трафика, это уже будут два разных механизма, которые раньше мы ошибочно смешивали.
Публичные DNSBL/reputation тоже не отделили GOOD от BAD
Мы проверяли и более банальное объяснение: вдруг адреса просто числятся в публичных reputation/blocklist.
Для исследуемой четвёрки публичные DNSBL не дали полезного разделения GOOD/BAD. Часть ответов была техническим policy/open-resolver ответом, часть — NXDOMAIN, но признака «вот эти два BAD опубликованы в blocklist, а эти два OK нет» не получилось.
Это не говорит, что никакой внешней репутации не существует. Это только означает, что публично проверенные списки не объясняют наблюдаемую выборку.
Что из гипотез мы сейчас считаем отвергнутым или сильно ослабленным
«Это просто маршрутизация»
Ослаблено как root cause. Source-dependent path подтверждён, но принудительная смена аплинк-A → аплинк-B selective проблему не вылечила.
«Агрессивный connect-check сам портит IP за несколько минут»
Не подтвердилось на .54: 403 URL × несколько workers не сломали маркер в наблюдаемом окне.
«BAD NAT обязательно прямо сейчас содержит самого шумного inside»
Не держится: есть quiet BAD и noisy OK. Историческое состояние важнее одной короткой выборки.
Опровергнуто. На 8.8.8.8:443 были reply packets и time-wait при WRAP_FAIL.
«Если цель FAIL со всех source, это сильное доказательство ТСПУ»
Нет. Это как раз слабый эксперимент: слишком много общих переменных.
«Основные CGNAT выглядят как зарубежные»
Не подтверждается рабочими GeoIP-базами для основных CGNAT-пулов.
«Публичный DNSBL объясняет BAD адреса»
Не подтвердилось на проверенной выборке.
«Soft quarantine должен немедленно вылечить уже плохой публичный IP»
Практика этого не показала. Quarantine полезен как remediation текущего источника шума, но уже существующее внешнее состояние SNAT от этого мгновенно не исчезает.
Какие гипотезы, наоборот, пережили проверки
1. Публичный CGNAT source — реальная координата эффекта и непосредственно виден ТСПУ
Один destination и один протокол дают разный результат при смене только публичного source. На нашей реальной топологии ТСПУ стоит после CGNAT, поэтому этот source непосредственно присутствует в пакетах на его входе. Это не доказывает, что src_ip — единственный внутренний ключ, но pre-NAT объяснение для этого тракта больше не требуется.
2. Состояние динамическое
Адрес может быть BAD, затем восстановиться, затем снова ухудшиться. Это видно и в полевой ротации Wi‑Fi NAT, и в серии 14 сентября.
3. У состояния есть инерция
Текущее поведение insides не всегда объясняет текущий статус. Quiet BAD возможен. Это согласуется с моделью, где решение зависит от истории, временного окна или TTL некоторого состояния.
4. Концентрация за NAT важна, но число пользователей само по себе недостаточно
После перехода GW1 на same мы получили почти одинаковое число активных inside на каждом из 30 публичных адресов: 59–76, CV 0.06. Но количество flows при этом различалось более чем втрое — от ~7 тыс. до ~22.8 тыс. за 5 минут.
Значит, следующий кандидат — не просто users_per_ip, а агрегированный профиль: flows/s, SYN/s, число новых соединений, uniq dst, uniq dst:port, протокольный mix и отдельные очень активные абоненты.
5. Один inside способен радикально изменить профиль всего NAT-IP
На GW3 адрес 203.0.113.92 выглядел аномально не потому, что на нём было больше пользователей, чем у соседей. Один 100.64.72.64 дал около 1.79 млн flows за 15 минут, 98.4% UDP и более 10 тыс. destinations. Это почти полностью объяснило перекос целого публичного NAT.
6. Реакция может быть destination/profile-specific
Даже «рабочий» NAT по одному Google marker не обязан быть зелёным по всей матрице. Поэтому правильнее говорить не «IP заблокирован/разблокирован», а про профиль reachability и его изменение во времени.
Текущая рабочая модель
После уточнения реальной топологии модель стала проще в одном месте и осторожнее в другом.
То, что мы знаем о тракте:
inside-клиенты
      ↓
    CGNAT
      ↓
public NAT-IP + агрегированный профиль
      ↓
    ТСПУ
      ↓
  Интернет
То, что мы наблюдаем:
одинаковый dst / один GW / одно время
             │
        меняем src IP
             │
      OK  ←→  selective FAIL
             │
   heal после простоя / вмешательства
             │
       возможный re-degrade
А вот следующий слой остаётся гипотезой:
public source + traffic profile
 (flows, SYN, fan-out, dst/port, protocol, history ...)
                    ↓
        некоторое внешнее state / policy
                    ↓
        selective → тяжёлая деградация
                    ↓
          cooldown / TTL / пересчёт / heal
Мы не знаем, один ли это механизм. Более того, измерения уже намекают как минимум на разные временные классы: краткие окна порядка 10–15 минут и многочасовые/sticky состояния, а эксплуатационная ротация Wi‑Fi даёт ещё и горизонт 2–3 суток.
Поэтому слово «память IP» в заголовке — удобная метафора наблюдаемой инерции, а не утверждение о конкретной структуре данных внутри ТСПУ.
15 сентября: выровняли CGNAT через action=same
До этого у сравнения NAT-IP оставалась фундаментальная слабость: разные белые адреса обслуживали сильно разные внутренние диапазоны. На одном могло быть несколько десятков активных клиентов, на другом — сотни. Любую разницу можно было списать на размер когорты.
Чтобы убрать эту переменную, на GW1 мы начали переводить абонентский NAT с набора статических 1:1-правил на RouterOS action=same с same-not-by-dst=yes. Пилот стартовал на .7–15, затем за счёт свободных адресов и переноса непрерывного блока пул расширили до:
203.0.113.2–203.0.113.31
То есть 30 публичных IP.
Смысл правила — не «лечить ТСПУ», а создать более чистую экспериментальную установку: один inside стабильно получает один адрес из общего пула, а клиенты распределяются между public IP значительно равномернее.
Упрощённо правило выглядит так:
/ip firewall nat
add chain=srcnat action=same \
    src-address-list=CGNAT-POOL-TEST \
    out-interface=ether-wan \
    to-addresses=203.0.113.2-203.0.113.31 \
    same-not-by-dst=yes
Старые статические правила не удаляли — их отключили и оставили как rollback.
Грабли: старый conntrack делает same визуально «кривым»
Первые замеры выглядели плохо. В 5-минутном окне около 15:12–15:28 MSK примерно 39–41% inside одновременно наблюдались на двух публичных NAT. Отдельные адреса держали более 200 inside, тогда как другие — около 60–80.
Причина оказалась не в алгоритме same. Старые соединения сохраняли прежний 1:1 NAT в conntrack, а новые уже получали адрес из нового пула. NetFlow видел смесь двух эпох.
После удаления старых conntrack-маппингов картина буквально схлопнулась.
Чистый срез после flush
Окно 12:29–12:33 UTC (~15:33 MSK):
| Метрика |
Результат |
| public IP в пуле |
30/30 |
| активных inside за 5 минут |
2023 |
| inside одновременно на >1 NAT |
0 / 2023 |
| среднее клиентов на public IP |
67.4 |
| медиана |
67 |
| min–max |
59–76 |
| max/min |
1.29× |
| CV |
0.06 |
Это уже почти идеальная база для дальнейшего сравнения clean → selective → full: число клиентов на каждом публичном IP близкое.
Но flows всё равно не выровнялись
И тут появился следующий важный результат. При одинаковых 59–76 inside объём flows отличался более чем втрое:
203.0.113.26   70 inside   22 805 flows / 5m
203.0.113.18   66 inside   16 574 flows / 5m
203.0.113.9    65 inside    6 974 flows / 5m
То есть users_per_ip — слишком грубая величина. Два NAT с одинаковыми 67 клиентами могут выглядеть для внешнего анализатора совершенно по-разному.
Теперь основной эксперимент становится намного чище: держим количество inside примерно одинаковым и смотрим, что лучше предсказывает ухудшение — flows/s, новые TCP, SYN-rate, fan-out, uniq dst, uniq dst:port, доля UDP, география destinations или конкретные профили отдельных клиентов.
Один абонент против всего NAT
Почти одновременно на GW3 нашёлся полезный контрпример к модели «главное — количество клиентов».
203.0.113.92 обслуживал примерно столько же inside, сколько соседние NAT, но создавал на порядок больше flows. Drill-down показал источник:
inside:    100.64.72.64
flows:     ~1 791 481 / 15 min
uniq dst:  10 256
UDP:       98.4%
traffic:   ~2.1 GB
Один inside короткими UDP-очередями последовательно бил множество destinations и почти в одиночку формировал аномальный профиль публичного .92.
Это не доказывает, что именно такой трафик вызывает исследуемую фильтрацию. Но оно доказывает более полезную вещь для следующего этапа: считать только количество пользователей за NAT недостаточно; один пользователь способен сделать профиль адреса принципиально другим.
Что этот эксперимент даст дальше
Если после выравнивания числа клиентов отдельные .2–31 всё равно начнут расходиться по reachability, мы сможем сравнить их уже без старого возражения «на плохом просто было в пять раз больше абонентов».
Если же деградация начнёт хорошо коррелировать с определёнными нагрузочными признаками, мы приблизимся к практическому ответу — какой профиль публичного CGNAT надо не допускать, независимо от того, как именно он называется внутри ТСПУ.
Важно: same здесь — инструмент эксперимента и способ равномернее распределить агрегацию, а не заявленное средство обхода или гарантированное лечение фильтрации.
Что будем мерить дальше
Теперь основная задача — не расширять количество красивых дашбордов, а измерить жизненный цикл одного NAT-IP.
1. GOOD/BAD paired probe постоянно
Для каждого инцидента сохранять хотя бы одну пару:
BAD source → marker A/B/C
GOOD source → те же marker A/B/C
с периодом 1–5 минут.
2. Фиксировать момент снятия NAT-нагрузки
Для ротации Wi‑Fi адресов особенно интересно получить строгую шкалу:
T0        IP сняли с NAT
T+6h      всё ещё BAD
T+24h     selective
T+48h     часть маркеров OK
T+60h     clean
Пока «2–3 дня» — устойчивое эксплуатационное наблюдение. Его надо превратить в таблицу.
3. Фиксировать момент повторного ввода
После восстановления вернуть адрес под контролируемую нагрузку и измерить time-to-degrade.
Это будет гораздо полезнее ещё одной разовой матрицы.
4. Разделять L4 и application probe
Новая версия mt_cc_full_matrix.py уже умеет после fetch смотреть conntrack. Для спорных endpoints должны храниться отдельно:
ICMP_OK
TCP_REPLY
TLS/HTTP_OK
FETCH_OK
5. Маленький маркерный набор вместо постоянных 403 URL
Полная матрица — диагностика/снимок. Для continuous monitoring лучше 5–10 хорошо изученных targets разных классов, у которых известна нормальная семантика теста.
6. Автоматические задания на проблемные NAT
Логика может выглядеть так:
H45 selective/full OR escalate_impact
        ↓
выбрать BAD NAT
        ↓
выбрать CLEAN NAT того же GW/префикса
        ↓
создать paired probe job на 1–5 минутный интервал
        ↓
писать timeline в ClickHouse
        ↓
при heal продолжить наблюдение ещё N часов
Именно продолжение после heal важно: 14 сентября показало, что «сейчас снова работает» ещё не означает устойчивого восстановления.
7. Бакетировать длительность fail-окон
Теперь к paired probes добавляется ещё одна ось — время непрерывного отказа. Для каждого SNAT считаем серии по 5-минутным окнам и разделяем хотя бы на:
короткие ≤15 мин
средние 15–120 мин
длинные ≥2 часов
Это должно помочь не смешивать краткие src×dst cooldown-паттерны с нашим H80-подобным многочасовым reblock. Контрольный сосед обязателен: если такие же длинные окна регулярно есть и у «чистого» адреса, метрика сама по себе недостаточна.
8. Длительное наблюдение за уже выровненным same-пулом
Сам эксперимент с распределением уже запущен: GW1 работает через 203.0.113.2–31, и после очистки старого conntrack число активных inside распределилось почти равномерно.
Теперь для каждого из 30 адресов нужно вести единый временной ряд:
inside_unique
flows/s
new TCP/s
SYN/s
uniq dst
uniq dst:port
UDP%
RU/non-RU dst
CC marker success%
H45 selective/full/clean
time_since_clean
Ключевой вопрос теперь звучит не «много ли абонентов за адресом», а почему два NAT с одинаковыми ~67 активными inside могут иметь разную нагрузку и, возможно, разную судьбу reachability.
Отдельно нужно помечать single-inside outliers наподобие 100.64.72.64, чтобы не спутать поведение когорты с поведением одного очень активного источника.
Что теперь можно утверждать достаточно уверенно
Первое. У нас есть воспроизводимые случаи, когда reachability к одному destination зависит от публичного source IP.
Второе. Эффект наблюдается в пределах одного префикса и одного GW, в том числе на соседних адресах .54/.55.
Третье. ICMP может оставаться полностью живым, когда TCP/application probe различается по source.
Четвёртое. Независимая точка наблюдения на стороне ТСПУ в одном из тестов увидела ICMP от обоих адресов, но TCP/443-сессию только от рабочего source.
Пятое. Принудительная смена upstream path аплинк-A → аплинк-B не устранила selective эффект.
Шестое. Короткая агрессивная матрица сама по себе не воспроизвела «сгорание» контрольного NAT.
Седьмое. Состояние может улучшаться и снова ухудшаться. 14 сентября после наблюдаемого heal нескольких SNAT часть из них за несколько часов вернулась в тяжёлый профиль.
Восьмое. Наш прежний бинарный fetch OK/FAIL был слишком грубым: часть FAIL происходит после успешного TCP. L4 и application-level результат нужно разделять.
Девятое. На исследуемом тракте ТСПУ находится после CGNAT, поэтому публичный NAT-IP и агрегированный за ним трафик непосредственно видны системе на входе. Это усиливает source-dependent гипотезу, но не раскрывает внутренний алгоритм.
Десятое. У отказов могут быть разные временные классы: краткие ~10–15 минут, многочасовые sticky-окна и эксплуатационный цикл восстановления порядка нескольких суток.
Одиннадцатое. После перевода GW1 на same и очистки старого conntrack 2023 активных inside распределились по 30 public IP почти равномерно: 59–76 на адрес, CV 0.06, dual-NAT=0.
Двенадцатое. Равное число клиентов не означает равный трафик: при почти одинаковом inside_unique flows различаются более чем втрое. Следовательно, для поиска триггера нужно анализировать профиль, а не только users/IP.
Тринадцатое. Один активный inside способен доминировать в профиле целого NAT: кейс 100.64.72.64 дал ~1.79 млн flows/15m и >10 тыс. destinations через .92.
И чего мы всё ещё не доказали
Мы не доказали, что конкретный механизм — это именно один определённый «список репутации ТСПУ».
Мы не знаем, какой traffic feature является главным триггером. После same стало даже понятнее, что простое число клиентов слишком грубо: одинаковые по размеру когорты дают очень разный flows/SYN/fan-out профиль.
Мы не доказали, что каждый selective FAIL создан ТСПУ: часть endpoints и часть ошибок /tool fetch имеют другие причины.
Мы не знаем, является ли публичный src_ip самостоятельным ключом, частью src×dst/profile-классификации или просто одним из нескольких признаков. Мы знаем только, что в нашей топологии он непосредственно виден ТСПУ, потому что ТСПУ расположен после CGNAT.
Мы не знаем, равны ли 2–3 дня полевого «отлёживания» TTL какого-либо списка. Это только наблюдаемый период восстановления. И пока не доказано, что многосуточный цикл Wi‑Fi, многочасовой reblock 14 сентября и короткие ~10-минутные cooldown-окна — один механизм.
Мы также не должны путать результат приложения с результатом сети: fetch FAIL может происходить уже после успешного TCP handshake.
Главный методологический итог этой части остаётся прежним: чем сильнее хочется назвать найденный паттерн доказательством, тем важнее поставить эксперимент, который может его опровергнуть. Переход на same как раз и нужен для следующего такого эксперимента — мы убрали сильный confounder в виде wildly-разного числа клиентов за разными NAT.
Вместо вывода
Начинали мы с довольно простой картинки: за NAT много пользователей, ТСПУ «не любит» адрес, он ломается.
После недели измерений картинка стала сложнее, но и полезнее.
Мы увидели:
source-dependent reachability
        +
динамический heal / re-degrade
        +
необязательная корреляция с текущим шумом
        +
устойчивость эффекта к смене uplink path
        +
независимое различие TCP при одинаковом ICMP
Это уже достаточно, чтобы перестать обсуждать проблему в терминах «у абонента иногда сайт не открывается».
Теперь это измеряемое состояние публичного egress, для которого можно строить историю, сравнивать контрольные адреса, ловить начало деградации и проверять восстановление.
А 15 сентября мы изменили уже не только измерительный контур, но и саму экспериментальную установку: вместо сильно неравномерных статических 1:1-NAT получили 30 публичных адресов с почти одинаковым количеством активных клиентов через same. Это убирает один из главных confounders предыдущих сравнений.
Следующая цель — поймать полный цикл одного из выровненных адресов от clean до selective/full, сопоставить момент деградации с flows/SYN/fan-out/profile, затем снять его с нагрузки, измерить время восстановления и снова ввести под контролируемую нагрузку.
Если этот цикл окажется воспроизводимым, спор о том, «кажется нам или не кажется», закончится. Останется более интересный вопрос: какое именно поведение переводит публичный IP из одного состояния в другое и как оператору строить NAT, чтобы один активный абонент не портил связность сотне соседей.
Технические артефакты этой части
Скрипты выложены для скачивания:
Дисклеймер. Это эксплуатационное исследование сетевой доступности на собственной инфраструктуре оператора. Оно не является описанием способа обхода фильтрации и не претендует на знание внутренней реализации ТСПУ. Все выводы о механизме, выходящие за непосредственно измеренные сетевые эффекты, помечаются как гипотезы.
#network #monitoring #netflow