Цифровой дворник

network

Обложка

Заходишь в свою веб-аналитику, а там тишина. За сутки — горстка просмотров и пара посетителей. Вроде сайт живой, статьи публикуются, кто-то их читает. Но панель упорно показывает, что кроме тебя и пары друзей никто не заходит.

Знакомо? У меня так было с блогом. Пока я не полез в access-логи веб-сервера и не обнаружил, что на сайт ходят толпы ботов, а аналитика их просто не видит. Дальше — почему так вышло и что я с этим сделал.

Как Umami считает визиты

Umami (и почти любая JS-аналитика) работает через скрипт на странице:

<script async src="https://analytics.example/script.js"
        data-website-id="..."></script>

Логика простая: браузер загружает страницу → выполняет скрипт → скрипт шлёт событие на api/send. Всё считает клиент, на стороне сервера — только приём.

И вот тут первая ловушка: боты не исполняют JavaScript. Поисковики, AI-краулеры, SEO-сканеры скачивают HTML и уходят. Они не запускают скрипт аналитики, поэтому для Umami их просто не существует.

Вторая ловушка: Umami по умолчанию фильтрует ботов по User-Agent. Даже если какой-то краулер решит выполнить скрипт, встроенная детекция ботов его отсеет. То есть панель намеренно показывает только «настоящих» людей.

Звучит разумно, пока тебе не нужно понять: а кто вообще стучится в мой сайт?

Что я увидел в логах

Когда я сравнил картину из Umami и из access-логов Caddy, разница оказалась смешной.

Umami за сутки: около полусотни просмотров, двадцать с лишним посетителей.

А в логах веб-сервера за тот же день — толпа. Вот кто приходил:

  • AhrefsBot — SEO-краулер
  • GPTBot, ChatGPT-User — краулеры OpenAI
  • ClaudeBot — Anthropic
  • PerplexityBot — Perplexity
  • Googlebot, Yandex, Bing — поисковики
  • TelegramBot — превью ссылок в мессенджере
  • плюс всякая мелочь вроде сканеров уязвимостей

Суммарно — под сотню обращений в день. И ни одного из них в Umami.

Вывод простой: JS-аналитика считает людей, а не трафик. Если хочешь видеть всех — надо смотреть логи сервера.

GoAccess вместо панели

GoAccess — это терминальный (и не только) анализатор логов, который гоняет access-лог и выдаёт отчёт: кто, откуда, сколько, какие страницы, какие статусы, какие боты. Никакого JS — только то, что реально дошло до сервера.

Ставится элементарно:

apt install goaccess

Но есть нюанс. Caddy по умолчанию пишет логи в stderr, а не в файл. Чтобы GoAccess их увидел, нужен файл:

log {
    output file /var/log/caddy/access.log
}

Тут я наступил на граблю: Caddy в systemd крутится под ProtectSystem=full, и файл лога вне разрешённых путей он создать не может — падает с «permission denied». Лечится drop-in'ом:

# /etc/systemd/system/caddy.service.d/rw-logs.conf
[Service]
ReadWritePaths=/var/log/caddy

Потом systemctl daemon-reload && systemctl reload caddy.

JSON-логи Caddy — не для GoAccess

Вторая засада: Caddy пишет логи в JSON, а GoAccess ест классический Combined Log Format. Приходится конвертировать. Я сделал это через jq:

jq -r 'select(.request != null)
  | select((.request.headers["User-Agent"][0] // "") | test("Uptime-Kuma|curl/|Python-urllib"; "i") | not)
  | "\(.request.client_ip // .request.remote_ip) - - [\(.ts|strftime("%d/%b/%Y:%H:%M:%S %z"))] \"\(.request.method) \(.request.uri) \(.request.proto)\" \(.status) \(.size // 0) \"\(.request.headers.Referer[0] // "-")\" \"\(.request.headers["User-Agent"][0] // "-")\""' \
  access.log > access.clf

Заметили фильтр? Я отсекаю собственный мониторинг (Uptime-Kuma долбит сайт каждые 30 секунд — за сутки это тысячи строк шума) и свои же curl-запросы. Иначе отчёт превращается в статистику «сколько раз мой мониторинг пинговал самого себя».

Дальше — рендер:

goaccess --log-format='%h %^[%d:%t %^] "%r" %s %b "%R" "%u"' \
  --date-format='%d/%b/%Y' --time-format='%H:%M:%S' \
  -f access.clf -o /var/www/logs/index.html --no-global-config

Обновляю отчёт по cron раз в пять минут. Финальный штрих — отдаю HTML через Caddy на поддомен logs.example, закрытый тем же allow-list'ом, что и админки (снаружи пускаю только свои IP).

Что в итоге

Теперь у меня два инструмента, и каждый на своём месте:

  • Umami — чтобы видеть живых людей: что читают, откуда пришли, что держится на странице. Тут чистота важнее полноты.
  • GoAccess по логам — чтобы видеть весь трафик: людей, ботов, сканеры, статусы 404 и 500, откуда реально ломятся.

Один не заменяет другой. Панель аналитики молчит про ботов не потому, что их нет, а потому что она про них не должна знать. А логи не знают про поведение человека на странице, зато честно показывают каждый запрос.

Мораль: если кажется, что «на сайт никто не заходит» — проверьте логи, прежде чем расстраиваться. Возможно, там как раз наоборот — заходят, и ещё как.


А у вас чем смотрите трафик? Только панель, или логи тоже смотрите?

#selfhosting #analytics #monitoring #network #goaccess #umami

Обложка

Цикл «Виды связности и SDN», часть 3. Предыдущая часть: «Underlay и overlay: сеть под сетью».

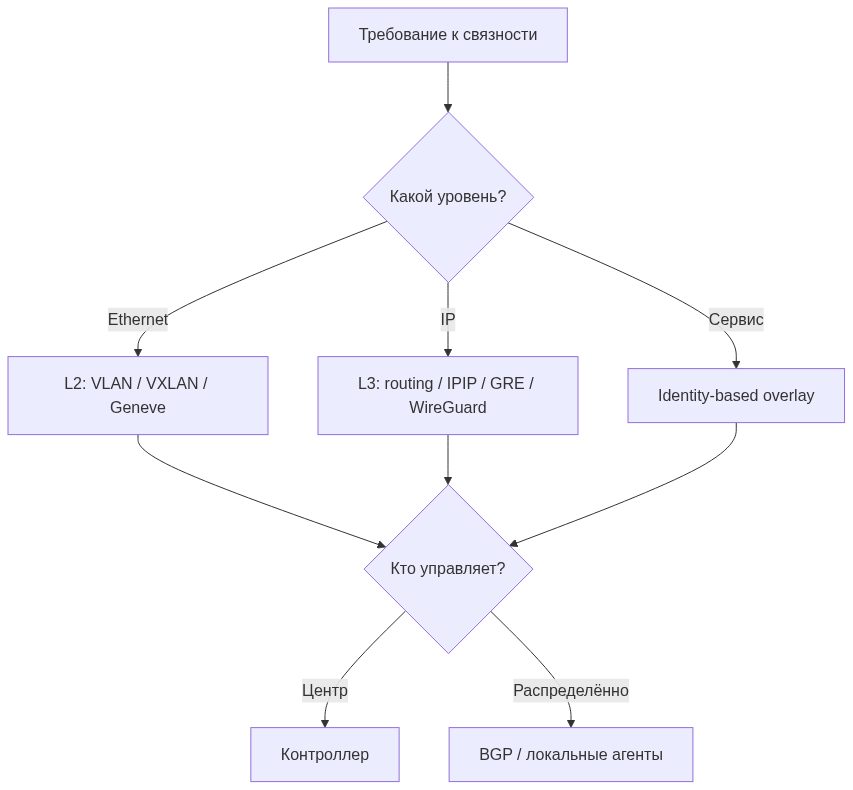
Ось: уровень — L2.

VLAN хорошо разделяет сеть внутри одного L2-домена, но его идентификатор имеет 12 бит, а сам VLAN не объясняет, как перенести Ethernet через маршрутизируемую фабрику или Интернет.

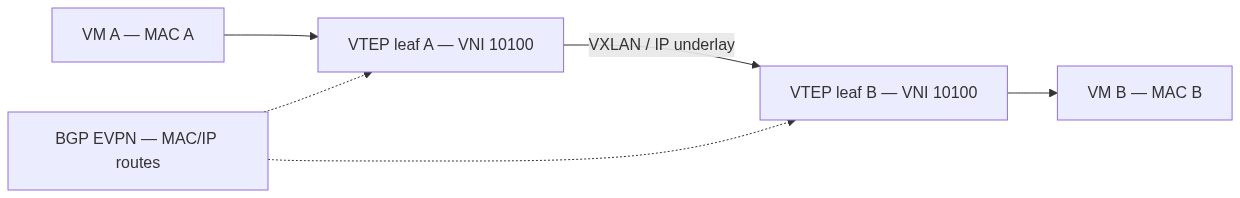
VXLAN решает эту задачу: помещает Ethernet-кадр в UDP и доставляет его между VXLAN Tunnel Endpoint — VTEP. VTEP — точка, где кадр входит в туннель и выходит из него.

VNI вместо VLAN ID

VXLAN Network Identifier имеет 24 бита. Теоретически это около 16 миллионов логических сегментов вместо примерно четырёх тысяч VLAN.

VNI не обязан совпадать с VLAN ID. На границе VTEP локальный VLAN может отображаться в VNI, переноситься через IP-фабрику и на другой стороне снова превращаться в локальный VLAN.

Underlay при этом не знает MAC-адресов виртуальных машин. Он маршрутизирует только внешние IP-адреса VTEP.

Откуда VTEP знает удалённый MAC

Простейшая модель — flood-and-learn. Неизвестный unicast, broadcast и часть multicast-трафика — вместе их называют BUM — рассылаются удалённым VTEP. Получая кадры, каждый VTEP изучает соответствие MAC и источника туннеля.

На маленькой лаборатории это работает. В крупной фабрике массовое flooding становится дорогим, а сходимость — не слишком предсказуемой.

EVPN переносит информацию о MAC и IP через BGP. Вместо того чтобы сначала залить кадр всем и посмотреть, кто ответит, VTEP получает маршрут вида «этот MAC и этот IP находятся за таким VTEP».

Для L2 особенно важны EVPN Type 2 — MAC/IP Advertisement routes. Они помогают распространять привязки MAC и IP хоста и выполнять ARP/ND suppression. Сам BUM EVPN не отменяет: для него обычно нужен Type 3 (Inclusive Multicast Ethernet Tag), чаще всего через ingress replication. Type 2 убирает unknown-unicast learning и лишний ARP, а не «любое flooding навсегда».

ARP suppression

В обычной L2-сети запрос ARP является broadcast. Если control plane уже знает, какой MAC соответствует IP, локальный VTEP может ответить сам и не рассылать запрос по всей фабрике.

Это не отменяет ARP, но не позволяет каждому запросу гулять по всем стойкам. В большой виртуализированной среде разница заметна.

Geneve рядом с VXLAN

Geneve решает похожую задачу, но имеет расширяемые option fields. В них можно передавать дополнительные метаданные для сетевой обработки, политик или сервисов.

OVN обычно использует Geneve между гипервизорами. Cilium поддерживает и VXLAN, и Geneve. Выбирать Geneve только потому, что он «новее», не стоит: нужно проверить поддержку offload, сетевого оборудования, MTU и конкретных функций платформы.

VXLAN не обязан быть одним большим L2

Современная фабрика может использовать VXLAN как транспорт, а границу маршрутизации ставить близко к серверам: отдельные Ethernet-сегменты плюс распределённый шлюз. Как именно это раскладывается на L2VNI, L3VNI и anycast gateway — в части 10.

Практический вывод уже здесь: «у нас VXLAN» не означает «у нас один broadcast-домен на весь ЦОД».

Когда растянутый L2 оправдан

  • миграция виртуальных машин с сохранением адреса;
  • legacy-приложение, которое невозможно быстро перевести на маршрутизируемую схему;
  • кластер, официально требующий общей L2-сети;
  • временная миграция между площадками;
  • подключение bare metal к tenant-сегменту.

Где это ломается

Если L2 растягивается только потому, что менять адреса неудобно, цена обычно выше ожидаемой:

  • broadcast и unknown unicast получают дальность действия;
  • отказ или петля затрагивают больше систем;
  • сложнее локализовать асимметрию;
  • возрастает зависимость от control plane;
  • аварийное переключение площадок может конфликтовать с внешней маршрутизацией;
  • flood-and-learn на большой фабрике маскирует отсутствие EVPN до первого инцидента.

Практическое правило: L2 растягиваем только для конкретного требования и заранее знаем, где расположена граница маршрутизации.

Где здесь SDN

Контроллер создаёт логический switch, порты, ACL и привязки к VNI. Локальные агенты превращают эту модель в flow rules и tunnel endpoints. Пользователь работает с логической сетью, не настраивая каждый гипервизор вручную.

OVN как раз предоставляет логические L2- и L3-сети, ACL, DHCP, DNS и распределённые маршрутизаторы поверх Open vSwitch.

В следующей части откажемся от идеи общей Ethernet-среды и перейдём к L3: IPIP, GRE, BGP, native routing и CrossSubnet.

Предыдущая часть: «Underlay и overlay: сеть под сетью»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet»

Схема

#network #selfhosting

Иногда задача выглядит совсем простой: заменить адрес NetFlow-коллектора на двух пограничных маршрутизаторах Juniper MX. Добавили новый flow-server, сделали commit, увидели растущие счётчики — вроде бы можно расходиться.

Но один маршрутизатор отправляет данные нормально, а второй либо не виден на коллекторе, либо экспортирует в несколько раз меньше. Причём Junos уверенно показывает Flows Exported, а Export Packet Failures остаётся равным нулю.

Именно с такой ситуацией мы столкнулись на двух MX, работавших на разных ветках Junos: один на достаточно старом 20.4R2.7, другой на ветке 23.4. В итоге разница версий оказалась не причиной неисправности, но заставила внимательно проверить ограничения платформы и способ доставки экспортных пакетов.

Все имена, IP-адреса, номера VLAN и интерфейсов ниже изменены. Для адресов используются специальные тестовые сети RFC 5737.

Коротко: что такое inline J-Flow

J-Flow — название технологии учёта потоков у Juniper. Коллектору данные обычно отправляются в формате NetFlow v9 или IPFIX.

В режиме inline-jflow потоки обрабатывает не Routing Engine, а Packet Forwarding Engine — PFE. Он выбирает пакеты согласно sampling rate, создаёт flow records, обновляет их и экспортирует на коллектор по UDP.

Это важное архитектурное различие. Команда ping, запущенная из CLI, обычно проверяет доступность от Routing Engine. Успешный ping ещё не доказывает, что PFE сможет отправить тем же путём NetFlow-пакеты.

Juniper прямо указывает, что inline collectors обычно недоступны через management-интерфейсы вроде fxp0. Поддержка экспорта через mgmt_junos появилась отдельно в Junos OS Evolved 24.2R1 и только на поддерживаемых платформах. Для классического Junos на MX нельзя считать, что это автоматически работает.

Исходная схема

Условно у нас было два маршрутизатора:

  • EDGE-A — Junos 20.4R2.7;
  • EDGE-B — Junos ветки 23.4;
  • старый коллектор — 198.51.100.10;
  • новый коллектор — 198.51.100.20, UDP/9992.

На обоих MX уже работал inline-jflow. Задача состояла в том, чтобы добавить или заменить коллектор и убедиться, что новый сервер получает потоки.

Базовая часть конфигурации выглядела примерно так:

set services flow-monitoring version9 template NF-V9 ipv4-template
set services flow-monitoring version9 template NF-V9 flow-active-timeout 60
set services flow-monitoring version9 template NF-V9 flow-inactive-timeout 15
set services flow-monitoring version9 template NF-V9 template-refresh-rate packets 1000
set services flow-monitoring version9 template NF-V9 template-refresh-rate seconds 30

set forwarding-options sampling instance NF-SAMPLE input rate 1024
set forwarding-options sampling instance NF-SAMPLE family inet output flow-server 198.51.100.20 port 9992
set forwarding-options sampling instance NF-SAMPLE family inet output flow-server 198.51.100.20 version9 template NF-V9
set forwarding-options sampling instance NF-SAMPLE family inet output inline-jflow source-address 192.0.2.40

set chassis fpc 0 sampling-instance NF-SAMPLE

На нужных логических интерфейсах включается sampling, например:

set interfaces et-0/0/2 unit 110 family inet sampling input
set interfaces et-0/0/2 unit 120 family inet sampling input

Номера портов и units здесь условные. В реальной сети sampling нужно включать осознанно: на тех направлениях и в той стороне, которые действительно должны участвовать в учёте.

Ловушка №1: маршрут есть, ping проходит, экспорта нет

На проблемном маршрутизаторе адрес источника J-Flow находился на fxp0, а маршрут к коллектору уходил в mgmt_junos:

inline-jflow в PFE → mgmt_junos → fxp0 → collector

С Routing Engine коллектор отвечал на ping. Счётчики показывали созданные и экспортированные flows. Ошибки экспорта не увеличивались. И всё же на сервере нормального потока UDP-пакетов не было.

Это один из самых неприятных сценариев диагностики: каждая отдельная проверка выглядит успешной, но проверяется не тот путь.

Для inline monitoring Juniper отдельно предупреждает: flow records и templates нельзя экспортировать через management interface, кроме специально оговорённых сочетаний Junos OS Evolved, релиза и платформы. На обычном MX с классическим Junos рассчитывать на fxp0 нельзя.

Поэтому такая проверка недостаточна:

ping 198.51.100.20 routing-instance mgmt_junos source 192.0.2.40 rapid count 5

Она подтверждает только то, что Routing Engine видит сервер через management VRF.

Надёжная конечная проверка делается на самом коллекторе:

tcpdump -ni any 'src host 192.0.2.40 and udp dst port 9992'

Если UDP-пакеты приходят, но система не показывает flows, нужно проверять уже не маршрутизацию, а обработку NetFlow v9 templates, ACL коллектора и привязку нового exporter IP.

Рабочее решение: отдельный data-plane VRF

Мы не стали переделывать основную таблицу маршрутизации и трогать BGP/OSPF. Вместо этого создали небольшой отдельный VRF только для экспорта J-Flow и вывели его через обычный порт PFE.

Схема стала такой:

inline-jflow в PFE → NF-EXPORT VRF → et-* VLAN → gateway → collector

Пример с полностью вымышленными параметрами:

set interfaces et-0/0/3 unit 3900 description NETFLOW-EXPORT
set interfaces et-0/0/3 unit 3900 vlan-id 3900
set interfaces et-0/0/3 unit 3900 family inet address 192.0.2.40/24

set routing-instances NF-EXPORT instance-type vrf
set routing-instances NF-EXPORT route-distinguisher 64512:3900
set routing-instances NF-EXPORT vrf-target target:64512:3900
set routing-instances NF-EXPORT interface et-0/0/3.3900

set routing-instances NF-EXPORT routing-options static route 198.51.100.10/32 next-hop 192.0.2.1
set routing-instances NF-EXPORT routing-options static route 198.51.100.20/32 next-hop 192.0.2.1

После этого коллектор связывается с VRF непосредственно в sampling configuration:

set forwarding-options sampling instance NF-SAMPLE family inet output flow-server 198.51.100.20 routing-instance NF-EXPORT

delete forwarding-options sampling instance NF-SAMPLE family inet output inline-jflow source-address
set forwarding-options sampling instance NF-SAMPLE family inet output inline-jflow source-address 192.0.2.40

Если одновременно используются два collectors и платформа это поддерживает:

set forwarding-options sampling instance NF-SAMPLE family inet output flow-server 198.51.100.10 routing-instance NF-EXPORT
set forwarding-options sampling instance NF-SAMPLE family inet output flow-server 198.51.100.20 routing-instance NF-EXPORT

Нужно также разрешить VLAN на промежуточном коммутаторе, обеспечить обратный маршрут к 192.0.2.40 и разрешить нужный UDP-порт на коллекторе и межсетевых экранах.

Применять такую конфигурацию безопаснее через подтверждаемый commit:

commit check
show | compare
commit confirmed 10

После проверки не забываем зафиксировать изменения:

commit

Почему именно VRF, а не virtual-router

В Junos типы routing instance vrf и virtual-router похожи внешне, но для flow monitoring это не взаимозаменяемые сущности.

В документации к flow-server ... routing-instance явно указано: routing instance должен иметь instance-type vrf. Возможность отправлять NetFlow v9 и IPFIX через WAN-порты non-default VRF в классическом Junos существует давно, но обычный virtual-router под это требование формально не подходит.

Переводить существующий большой virtual-router с полной таблицей BGP в vrf только ради NetFlow — плохая идея. Такая операция перезапустит протоколы и потребует пересоздания таблиц и меток. Отдельный маленький VRF для экспорта проще, понятнее и почти не затрагивает рабочую маршрутизацию.

Нюансы разных версий Junos

Главный вывод из практики: номер релиза сам по себе редко отвечает на вопрос «заработает ли J-Flow». Смотреть нужно сочетание:

модель устройства + тип Junos + релиз + линейная карта + формат экспорта

1. Базовая конфигурация на 20.4 и 23.4 почти одинаковая

На классическом Junos для MX основные иерархии остаются прежними:

  • services flow-monitoring — шаблон;
  • forwarding-options sampling — sampling instance, collector и source address;
  • chassis fpc ... sampling-instance — привязка к PFE;
  • interfaces ... sampling input|output — выбор трафика.

Поэтому наличие старой и новой версии на двух одинаковых маршрутизаторах ещё не объясняет различие в объёме данных.

2. Несколько collectors — платформозависимая функция

В разных разделах документации встречаются ограничения от одного до четырёх collectors на family. Поддержка зависит от устройства и релиза. Нельзя делать вывод только по тому, что команда принимается CLI.

Правильный порядок:

  1. Проверить модель и релиз в Juniper Feature Explorer.
  2. Выполнить commit check с нужным количеством flow-server.
  3. Убедиться по tcpdump, что templates и data records приходят на каждый сервер.
  4. Проверить, что у всех collectors одной family используется один source IP и совместимый template.

В нашей конфигурации два collectors работали на обоих релизах, но это не следует автоматически переносить на любую серию MX, PTX, ACX или QFX.

3. mgmt_junos — не универсальное решение

Поддержка экспорта через management VRF появилась в Junos OS Evolved 24.2R1 только для поддерживаемых платформ. Это не означает, что fxp0 заработал для inline J-Flow на всех MX после обновления.

Для классического Junos на MX безопасное правило остаётся простым: collector должен быть достижим через data-plane интерфейс.

4. Поддержка полей менялась между релизами

Например, NetFlow v9 для IPv6 появился позже, чем для IPv4. Начиная с 18.4R1 изменились рекомендуемые опции для MPLS templates. В 24.2R1 для ряда платформ появилась более точная обработка нескольких BGP next hops.

Если коллектору важны MPLS, IPv6, AS path, BGP next hop или корректный outgoing interface, нужно проверять не только факт прихода packets, но и состав полей конкретного template на конкретном релизе.

5. Обновление Junos не исправляет неправильный путь

Можно обновить маршрутизатор с 20.4 до более свежей ветки и получить тот же результат, если source address по-прежнему находится на fxp0, а collector доступен только через management table.

Сначала проверяем архитектуру экспорта, затем известные проблемы релиза, и только потом рассматриваем обновление как исправление.

Проверка после настройки

Сначала убеждаемся, что интерфейс и VRF поднялись:

show interfaces terse et-0/0/3.3900
show route table NF-EXPORT.inet.0 198.51.100.20 exact
ping 198.51.100.20 routing-instance NF-EXPORT source 192.0.2.40 rapid count 5

Затем смотрим состояние inline J-Flow:

show services accounting status inline-jflow fpc-slot 0
show services accounting flow inline-jflow fpc-slot 0
show services accounting errors inline-jflow fpc-slot 0

Полезный короткий вывод:

show services accounting flow inline-jflow fpc-slot 0 | match "Flow Packets:|Flows Exported:|Flow Packets Exported:"

Что означают основные счётчики:

  • Flow Packets — сколько sampled packets обработано;
  • Flows Exported — сколько flow records сформировано;
  • Flow Packets Exported — сколько экспортных UDP-пакетов сформировано;
  • Export Packet Failures — ошибки экспорта, видимые самому механизму J-Flow.

На коллекторе:

tcpdump -ni any 'src host 192.0.2.40 and udp dst port 9992'

Для NetFlow v9 важно увидеть не только data packets, но и templates. Без актуального template сервер может получать UDP, но не уметь разобрать flow records. После изменения exporter IP некоторые системы также создают новый источник, который нужно отдельно разрешить или привязать.

Ловушка №2: «второй MX экспортирует в пять раз меньше»

После исправления маршрутизации оба маршрутизатора начали нормально отправлять J-Flow. Но на коллекторе объём от EDGE-B всё равно был примерно в пять раз меньше, чем от EDGE-A.

Первое подозрение — потери в новом VRF. Однако сравнение счётчиков показало почти одинаковую пропорцию на всех этапах:

sampled packets → flow records → export UDP packets

Если Flow Packets, Flows Exported и Flow Packets Exported отличаются между двумя маршрутизаторами примерно в одно и то же число раз, экспорт обычно работает нормально. Просто один маршрутизатор видит меньше sampled traffic.

Вот фактическая дельта counters за один и тот же контрольный интервал:

Счётчик EDGE-B, Junos 23.4 EDGE-A, Junos 20.4R2.7 Соотношение
Flow Packets 36 595 190 594 EDGE-A ×5,21
Flow Bytes 41 005 542 186 773 793 EDGE-A ×4,55
Flows Exported 29 112 151 742 EDGE-A ×5,21
Flow Packets Exported 7 348 38 008 EDGE-A ×5,17

Картина почти идеальная: старый MX обработал примерно в 5,2 раза больше sampled packets, сформировал в 5,2 раза больше flow records и отправил в 5,17 раза больше экспортных UDP-пакетов. Если бы проблема находилась между PFE и коллектором, такая ровная пропорция на всех трёх стадиях была бы маловероятна.

То есть старый Junos здесь не только не мешал — маршрутизатор на 20.4R2.7 фактически экспортировал больше. Причиной оказалось распределение реального трафика и различный охват интерфейсов sampling.

Причины могут быть совершенно штатными:

  • через один MX реально проходит больше трафика;
  • sampling включён на разном количестве интерфейсов;
  • на одном устройстве забыли один peer или VLAN;
  • входящий трафик распределён несимметрично из-за BGP;
  • внутренний исходящий трафик предпочитает один маршрутизатор по IGP metric;
  • сравниваются накопительные counters с разным uptime.

Сравнивать нужно не абсолютные значения, а прирост за одинаковый интервал. Например, снять counters на обоих устройствах, через 60 секунд повторить и посчитать delta.

При sampling rate 1:1024 грубая оценка исходного packet rate выглядит так:

исходный PPS ≈ прирост Flow Packets / интервал × 1024

Но не стоит напрямую приравнивать число flows к битрейту. Один длинный поток и тысячи коротких соединений могут передать одинаковый объём данных, но сформировать совершенно разное количество flow records.

Ещё несколько нюансов, о которых легко забыть

Sampling на входе и выходе — это не одно и то же

Если включить sampling сразу в обе стороны без понимания схемы, один и тот же пользовательский трафик можно учесть дважды. Сначала нужно определить точку учёта: внешние uplinks, абонентские интерфейсы, BNG-facing links или другой однозначный срез.

На одном FPC доступен один sampling instance

Пользовательский sampling instance имеет приоритет над global instance. Не стоит создавать несколько похожих конфигураций в надежде разделить collectors — результат может оказаться не тем, который ожидается.

Flow table тоже имеет предел

При большом количестве одновременных потоков нужно проверить размер flow hash table и ошибки accounting. Менять её вслепую не стоит: доступный размер зависит от платформы и линейной карты.

sFlow и mirroring могут конфликтовать

Juniper предупреждает о непредсказуемом поведении при одновременном использовании inline active flow monitoring и sFlow на одном интерфейсе. Аналогичное предупреждение есть для egress port mirroring.

Поля next hop и outgoing interface не всегда идеальны

При ECMP, разных VRF на входе и выходе, агрегированных интерфейсах и некоторых старых релизах отдельные поля могут быть нулевыми или отражать только первый известный путь. Поэтому NetFlow — отличный инструмент учёта и аналитики, но его поля нужно интерпретировать с учётом архитектуры PFE и возможностей релиза.

Короткий чек-лист диагностики

Если J-Flow «как будто работает», а данных нет или мало:

  1. Проверить, на каких интерфейсах и в каком направлении включён sampling.
  2. Проверить привязку sampling instance к нужному FPC.
  3. Убедиться, что source IP существует и достижим обратно с коллектора.
  4. Посмотреть маршрут к collector именно в указанном routing instance.
  5. Не считать успешный ping через mgmt_junos доказательством доступности от PFE.
  6. Проверить UDP на collector через tcpdump.
  7. Убедиться, что приходят NetFlow v9/IPFIX templates.
  8. Проверить ACL и регистрацию нового exporter IP на collector.
  9. Сравнивать delta counters за одинаковый интервал.
  10. Сверить platform/release support в Feature Explorer, особенно для нескольких collectors и non-default VRF.

Итог

Разные версии Junos действительно добавляют нюансы, но в этой истории главным оказался не релиз.

Inline J-Flow живёт в PFE. Поэтому маршрут, работающий для Routing Engine через fxp0, может быть бесполезен для экспорта flow records. Надёжное решение для классического Junos на MX — обеспечить collector data-plane маршрутом. Если не хочется вмешиваться в основную таблицу, отдельный маленький VRF и технологический VLAN решают задачу аккуратно и предсказуемо.

А если после этого один маршрутизатор экспортирует меньше другого, сначала сравните охват interfaces, реальный traffic и прирост counters. Иногда «потерянный NetFlow» — это просто трафик, который всё это время шёл через соседний MX.

Официальная документация


#network
Обложка

Цикл «Не светим лишнего». Выпуск 4.

Если у нас есть офис со статическим внешним адресом, открыть ему доступ к корпоративной панели проще простого: добавили IP в allow-list, сделали правило и забыли. Иногда это действительно лучший вариант.

Статический список хорошо подходит площадкам, филиалам, собственным серверам, внешним API и известным шлюзам. В нём мало движущихся частей, нет отдельного портала и нечему разъехаться по времени.

Но белый список часто начинают воспринимать как список пользователей. А это уже ошибка.

Что видит firewall

Firewall видит исходный адрес пакета после всех внешних NAT. Если в офисе двести человек выходят через один публичный IP, для нашего периметра это один источник. Если подрядчик включил корпоративный VPN, мы увидим адрес выхода этого VPN. Если мобильный оператор использует CGNAT, рядом с нашим инженером под тем же IP могут находиться другие абоненты.

Поэтому запись 198.51.100.27 -> allow означает только одно: любой подходящий трафик, пришедший с 198.51.100.27, проходит это условие. Кто его отправил — решает уже следующий слой.

Где статический список уместен

  • межплощадочный доступ между собственными фиксированными адресами;
  • внешний сервер, который обращается к нашему API;
  • корпоративный VPN-шлюз, где пользователь уже аутентифицирован отдельно;
  • bastion или jump host с контролируемой конфигурацией;
  • мониторинг с известной площадки;
  • временно — известный адрес подрядчика, если есть процесс удаления.

Для людей с домашним динамическим Интернетом схема уже менее приятная. Сегодня адрес один, завтра другой. Администратор каждый раз лезет в правила, а старую запись обычно никто не удаляет.

Плюсы

  • очень простая реализация;
  • работает с любыми протоколами;
  • легко увидеть и проверить;
  • не требует действий от пользователя;
  • хорошо сочетается с дополнительной авторизацией ресурса;
  • почти не зависит от внешних сервисов.

Минусы

  • IP не равен пользователю;
  • общий NAT расширяет круг фактически допущенных клиентов;
  • динамические адреса меняются;
  • списки копят устаревшие исключения;
  • при передаче адреса другому абоненту доверие может перейти вместе с ним;
  • IPv4 и IPv6 приходится учитывать отдельно.

Где можно больно ошибиться

Разрешить адрес прокси по заголовку. Если приложение берёт X-Forwarded-For от любого клиента, злоумышленник просто напишет туда нужный IP. Сетевой firewall использует настоящий адрес соединения; веб-приложение должно доверять заголовкам только от своих reverse proxy.

Разрешить слишком широкую сеть. Подрядчик дал /24, потому что «у нас адреса могут меняться». Это уже 256 возможных источников, владельцев которых мы не контролируем.

Не вести владельца и срок. У каждой записи должны быть комментарий, ответственный, причина и дата пересмотра. trusted-temp-2 без истории через год никто не удалит.

Забыть про доступ в обход. Если HTTP закрыт по IP на reverse proxy, но backend доступен напрямую на другом адресе, вся конструкция бессмысленна.

Как сделать статические списки терпимыми

Я бы разделил их минимум на три класса: собственные площадки, системные интеграции и человеческие исключения. Первые два пересматриваются по инвентаризации. Третий класс лучше вообще не делать постоянным: выдавать запись с timeout или управлять ею через портал.

Следующий выпуск как раз про это — тот же allow-list, но с коротким сроком жизни, журналом и нормальным отзывом.

Ранее в цикле

Документация и источники

#network

Обложка

Один из самых недооценённых артефактов в домашней сети — DNS-кэш роутера. Туда попадает каждый домен, который кто-то в сети пытался открыть: телефоны, ноутбуки, умный дом, приставки. Роутер это всё запоминает, потому что кэширует ответы DNS-сервера.

И если в сети завелась малварь — она почти наверняка оставит след в этом кэше. Потому что у малвари есть одна привычка, которую сложно спрятать: она ходит на странные домены.

Почему малварь палится по DNS

Вредоносное ПО должно с кем-то общаться: получать команды (C2), вытаскивать данные, скачивать обновления. Вариантов немного:

  • Жёстко зашитый IP — быстро сгорает, блокируется, легко находится.
  • Доменное имя — удобно: можно менять IP за доменом, домен дешевле перевыпустить.

Но у доменов малвари есть характерные черты, которых нет у нормальных сайтов:

  1. Длинные бессмысленные поддомены. Классический приём — передавать данные прямо в DNS-запросе (DNS-туннелинг) или генерировать домены алгоритмом (DGA). Выглядит это как xkcd90210-4f8a2b... .example.com — каша из случайных символов, а не www.
  2. Высокая энтропия. Имя домена похоже на случайный набор base32/base64-символов, а не на читаемое слово.
  3. Свежие или «одноразовые» домены. Зарегистрированы неделю назад, живут месяц.
  4. Необычные TLD и зоны там, где им не место.
  5. Аномальная частота запросов — биение (beaconing) каждые N минут.

Легитимные сервисы тоже бывают «странными» (CDN, трекеры, телеметрия), поэтому один признак — не приговор. Но совокупность — уже повод копать.

Как посмотреть кэш на MikroTik

Всё, что нужно, — одна команда на роутере:

/ip dns cache all print

Или в одну строку (удобнее для обработки):

/ip dns cache all print terse

Флаги: S — статическая запись, N — негативная (имя не разрешилось), пусто — обычный кэш.

Для сравнения — на Linux/маке:

# macOS
sudo dscacheutil -cachedump -entries Host

# systemd-resolved
resolvectl statistics
resolvectl query example.com

Но у роутера есть преимущество: он видит DNS-запросы всей сети, а не одного устройства. Это глобальный наблюдатель, который уже стоит у тебя дома.

Что мы нашли в своём кэше

Проверили оба наших MikroTik (дача и дом). Это не теоретические примеры — вот реальные находки из /ip dns cache all print.

1. Домен-трекер, который долбится по три раза

q7x2m9k.ru
hit.q7x2m9k.ru

Короткое бессмысленное имя, похожее на случайный набор символов, и при этом три дубля в кэше — значит, кто-то в сети реально ходил на него несколько раз. Резолвится в 203.0.113.x — подсеть, где живёт куча рекламных/трекерных доменов (WAN-облако).

Рядом с ним в кэше — rmetrics-demo.ru, eventtrace-demo.ru — та же подсеть, те же «мусорные» трекеры, тоже по 3 записи. Это не малварь в классическом смысле, но это ровно тот паттерн, который мы ищем: бессмысленный домен + повторные обращения.

2. Punycode-домен

xn----8sbhbcdy1d.xn--80aswg

Это IDN-домен (кириллица в punycode). Сам по себе punycode — нормально (легитимные сайты так кодируются), но такие имена — излюбленный приём фишинга: визуально домен может выглядеть как известный сайт, а на деле быть одноразовым мусором. Резолвится в 203.0.113.148. Проверка по whois/VirusTotal обязательна.

3. UUID в имени домена

0f4a2c9e-77b3-4d81-8e2f-a1b6c3d4e5f6-netseer-ipaddr-assoc.xz.social-cdn.net

Выглядит как «случайная строка + домен» — классический вид DNS-туннелинга. Но тут важный урок: не всё странное — зло. Это netseer — легитимный механизм для привязки рекламы к IP (механизм социальных сетей). UUID в имени — это на самом деле идентификатор. Вывод: сначала гуглим домен, потом паникуем.

4. Негативные записи корпоративного домена (самое интересное)

На втором роутере нашли вот такое:

wpad.LAB.test
_kerberos._tcp.dc._msdcs.LAB.LAB.test
_ldap._tcp.VPN._sites.dc._msdcs.LAB.LAB.test
sw-sccm-01.LAB.LAB.test
pac.LAB.LAB.test

Это негативный кэш (флаг N) — кто-то в домашней сети искал корпоративную инфраструктуру Windows: WPAD (автообнаружение прокси), Kerberos, LDAP, SCCM-сервер. Классический сценарий: человек принёс с работы ноутбук, тот пытается найти «свой» домен-контроллер и долбится в DNS роутера.

Сам по себе безобидно (записи негативные, ничего не разрешилось), но это отличная иллюстрация: DNS-кэш роутера рассказал нам, что в сети был корпоративный Windows-хостов. Для офисного админа это уже разведданные: кто-то таскает рабочие ноутбуки домой.

Кто и зачем туда ломился (разбор наших находок)

Недостаточно увидеть странный домен — интересно понять, кто в сети к нему ходил. Мы докопались до владельцев и устройств. Вот что выяснилось.

Трекеры из российского облака. q7x2m9k.ru, hit.q7x2m9k.ru, rmetrics-demo.ru, eventtrace-demo.ru — все резолвятся в подсеть 203.0.113.x, а это российское облако. Это рекламно-аналитические трекеры: их дёргают SDK в бесплатных приложениях. Кто в сети на них ходит? Судя по DHCP-арендам — телефоны на Android и умный дом (шлюзы, робот-пылесос, ESP-устройства). Это не малварь, а мусорная телеметрия: приложение молча шлёт аналитику и тянет рекламу. Три дубля в кэше = обращались несколько раз.

Мёртвый трекер. whitei-demo.net резолвился в 203.0.113.70, но сейчас домен уже не резолвится — его отключили. В кэше он просто доживает свой TTL. Такой «хвост» в кэше — полезный сигнал: домен мог быть живым трекером/редиректом, который снесли.

Безобидный punycode. xn----8sbhbcdy1d.xn--80aswg выглядит зловеще, но это кириллический IDN-домен. Просто punycode-кодировка — нормальный механизм для кириллических имён, а не признак зла. Урок: сначала декодируй и гугли, потом паникуй.

Корпоративный ноутбук дома. На втором роутере нашлись негативные записи с поддоменами wpad, _kerberos, _ldap, _msdcs, sccm. Это корпоративная инфраструктура Windows (WPAD-автообнаружение прокси, Kerberos, LDAP, SCCM-сервер). Кто-то принёс рабочий ноутбук домой, и тот упорно ищет «свой» домен-контроллер в чужой сети. Записи негативные (ничего не нашёл), но сам факт засветился в кэше. Для офисного админа это уже разведданные: сотрудник таскает корпоративную технику домой.

Вывод по нашим находкам: реальной малвари нет — это рекламные SDK из приложений + корпоративный ноутбук. Но метод работает: кэш роутера рассказал и про телеметрию приложений, и про рабочий ноутбук в домашней сети. Именно поэтому «посмотреть в кэш» — это не магия, а дешёвая разведка, доступная каждому админу.

Как проверять подозрительные находки

Нашёл странный домен — не паникуй, а прогони по чек-листу:

# 1. Что это за IP
dig +short suspicious-domain.ru A

# 2. Кто владелец
whois suspicious-domain.ru

# 3. Есть ли этот домен в репутационных базах
#    VirusTotal, urlscan.io, ThreatFox — вбить имя руками

# 4. Как давно зарегистрирован (свежий домен = красный флаг)
whois suspicious-domain.ru | grep -i "created"

Легитимные «странности», которые часто пугают: – googlevideo.com / rr3---sn-... — YouTube CDN, длинные имена — норма – edgesuite.net, akamaized.net — Akamai CDN – *.push.apple.com — push-уведомления Apple – netseer...fbcdn.net — реклама Facebook – *.3gppnetwork.org — VoWiFi/VoLTE (операторская связь)

Красные флаги: – Домен зарегистрирован < 30 дней назад – Имя — случайная каша, и оно повторяется в кэше – Резолвится в подсеть, известную трекерами/спамом – Негативные записи _kerberos, _ldap, wpad, _msdcs — в доме кто-то ищет корпоративный домен

Что делать, если нашёл реальную малварь

  1. Найди, кто ходил. ip dhcp-server lease print → сопоставь по времени/устройству. Или ip firewall connection print в момент запроса.
  2. Заблокируй домен на роутере (DNS-уровень — проще всего): /ip dns static add name=bad-domain.ru type=NXDOMAIN
  3. Заблокируй IP (если домен уже разрешился): /ip firewall address-list add list=blocked address=1.2.3.4 /ip firewall filter add chain=forward src-address-list=blocked action=drop /ip firewall filter add chain=forward dst-address-list=blocked action=drop
  4. Почисти устройство. Это уже отдельная история — антивирус, проверка автозагрузки, смена паролей.
  5. Проверь сам роутер. MikroTik тоже ломают (ботнет из 13 000 MikroTik через DNS-мисконфиг SPF — свежий громкий случай 2025). Обнови RouterOS, смени пароли, выключи ненужные сервисы.

Бонус: как это автоматизировать

Раз в день снимать кэш и искать аномалии можно скриптом:

ssh admin@router "/ip dns cache all print" \
  | awk 'length($0) > 60 && $0 !~ /googlevideo|edgesuite|akamaized|apple|google|microsoft/ {print}'

А для полноценного анализа — считать энтропию имён (Shannon entropy): всё, что выше порога, отправлять на проверку. На роутере это не сделать, но можно забирать кэш по SSH на сервер и анализировать там (у нас это делает агент на сервере).

Вывод

DNS-кэш роутера — это бесплатный детектор аномалий, который уже стоит в каждой домашней сети. Одна команда /ip dns cache all print — и ты видишь, куда на самом деле ходили устройства. Не всё странное — малварь (CDN и трекеры тоже «странные»), но паттерн «бессмысленный домен + повторные запросы + свежая регистрация» — это уже повод копать.

А если найдёшь в кэше _kerberos._tcp.dc._msdcs — знай: кто-то притащил рабочий ноутбук домой. И теперь ты об этом знаешь.

#selfhosting #network #monitoring #openclaw #llm

Обложка

Вышел новый релиз connect-check v1.6.0 — сетевого диагностического инструмента.

Что нового

  • CRM в этапе банков/сервисов: Bitrix24 (+ авторизация / Паспорт), amoCRM / Kommo, Мегаплан, RetailCRM, МойСклад, Planfix, YCLIENTS, ELMA365, Creatio, Salesforce, HubSpot.
  • При ≥10 сбоях: кнопка «Письмо в НОК» в HTML-отчёте и GUI — mailto на info@noc.gov.ru (cc support@on-telecom.ru), тема/тело с внешним IP и сводкой; скачивается TXT сбоев; если почтовый клиент не открылся — инструкция в отчёте/логе.
  • Sidecar TXT сбоев рядом с HTML (*_problems.txt).

Скачать

Зеркало (если GitHub недоступен):

Оригинал: Релиз v1.6.0 на GitHub

#monitoring #network

Обложка

Цикл «Виды связности и SDN», часть 2. Предыдущая часть: «SDN без магии: карта видов связности».

Ось: underlay и overlay (транспорт).

Представим, что сервер в офисе должен общаться с виртуальной машиной в облаке так, будто они находятся в одной внутренней сети. Между ними уже есть Интернет. Мы не меняем Интернет, а создаём поверх него собственную логическую связность.

Интернет в этой схеме — underlay. Туннель — overlay.

Что происходит с пакетом

Приложение формирует обычный IP-пакет. Overlay-компонент добавляет к нему свой заголовок, затем внешний IP-заголовок. Underlay видит только наружные адреса узлов туннеля и доставляет контейнер целиком.

На принимающей стороне внешние заголовки снимаются, и исходный пакет продолжает путь так, будто никакого Интернета между участниками не было.

VXLAN обычно вкладывает Ethernet-кадр в UDP. Geneve делает похожее, но имеет расширяемые поля параметров. IPIP помещает IPv4-пакет внутрь другого IPv4-пакета. GRE добавляет собственный заголовок между внешним IP и полезной нагрузкой. WireGuard не только инкапсулирует, но и шифрует содержимое.

Внешний заголовок не всегда UDP. IPIP использует IP protocol 4, GRE — protocol 47. У них нет номера TCP- или UDP-порта.

Требования к underlay

Минимальное требование почти всегда одно: адреса конечных точек туннеля должны быть достижимы друг для друга. Но дальше начинаются детали.

Для VXLAN и Geneve межсетевые экраны должны пропускать соответствующий UDP. Порт зависит от реализации, а не только от названия протокола:

Механизм Внешний транспорт Типичный порт
VXLAN по IANA UDP 4789
VXLAN в Linux, Cilium, Flannel UDP 8472
VXLAN в Calico UDP 4789
Flannel VXLAN на Windows UDP 4789
Geneve UDP 6081
WireGuard UDP 51820; Cilium — 51871
IPIP IP protocol 4 порта нет
GRE IP protocol 47 порта нет

Если firewall разрешает только TCP и UDP, правило «порт для IPIP» не поможет: такого порта не существует.

Цена заголовков

Обычный Ethernet часто имеет MTU 1500. После добавления внешних заголовков внутри туннеля остаётся меньше места.

Примерные накладные расходы:

Механизм IPv4 IPv6
IPIP 20 — (это IPv4-in-IPv4)
VXLAN 50 70
Geneve без options ~50 ~70
WireGuard 60 80

VXLAN 50 байт на IPv4 складываются так: внешний IPv4 (20) + UDP (8) + VXLAN (8) + внутренний Ethernet (14). IPIP Ethernet внутрь не кладёт, поэтому налог меньше. Options у Geneve увеличивают размер сверху базовых 50. VXLAN поверх WireGuard складывает расходы обоих слоёв.

Если inner MTU не уменьшить, большой пакет придётся фрагментировать или отправитель должен узнать допустимый размер через Path MTU Discovery. Когда ICMP-сообщения о необходимости уменьшить пакет фильтруются, возникает PMTUD black hole.

Для IPv4 это ICMP Type 3 Code 4 (Fragmentation Needed). Для IPv6 — ICMPv6 Packet Too Big: промежуточные маршрутизаторы IPv6 не фрагментируют, поэтому без PTB большой пакет просто не проходит.

Маленький ping проходит, SSH открывается, а загрузка страницы или передача большого файла зависает. Администратор смотрит на зелёный мониторинг и начинает подозревать приложение. Приложение обычно ни при чём.

Overlay не повышает качество underlay

Если underlay теряет 3% пакетов, WireGuard их не вернёт. Если между площадками 90 мс задержки, VXLAN не сделает 2 мс. Если маршрутизация асимметрична, stateful firewall может продолжать отбрасывать часть трафика.

Добавляется собственная служебная нагрузка:

  • keepalive для сохранения NAT mapping;
  • сообщения control plane;
  • STUN и negotiation для mesh-сетей;
  • BFD или другие проверки доступности;
  • дополнительная обработка и шифрование.

Поэтому сначала проверяют underlay: адреса, маршруты, потери, задержку, MTU, ECMP и firewall. Затем — overlay.

Overlay и ECMP

Внешняя сеть принимает решение по внешним заголовкам. Если все внутренние потоки между двумя узлами получают одинаковую внешнюю пару адресов и портов, underlay может считать их одним большим потоком и отправлять по одному ECMP-пути.

Некоторые реализации меняют UDP source port на основе хеша внутреннего потока. Тогда разные пользовательские соединения лучше распределяются между равнозначными путями. Это важная деталь для производительности фабрики ЦОД, хотя конечные виртуальные машины о ней не знают.

Где ставить границу

Overlay можно завершить на:

  • физическом маршрутизаторе;
  • коммутаторе с VTEP;
  • гипервизоре;
  • Kubernetes-узле;
  • отдельном шлюзе площадки;
  • клиентском ноутбуке.

Чем ближе конечная точка к приложению, тем меньше незашифрованный участок и точнее политики. Но тем больше агентов, ключей, туннелей и состояний приходится обслуживать.

Практический порядок диагностики

  1. Проверить достижимость внешних адресов конечных точек.
  2. Проверить разрешённый внешний протокол и порт.
  3. Измерить максимальный пакет без фрагментации.
  4. Посмотреть route lookup до внешнего адреса туннеля.
  5. Проверить состояние интерфейса туннеля.
  6. Снять дамп одновременно до и после инкапсуляции.
  7. Только после этого разбирать маршруты и политики внутри overlay.

Где это ломается

  • Inner MTU оставили 1500, а ICMP Fragmentation Needed или IPv6 Packet Too Big отфильтровали.
  • Ищут «порт VXLAN», а реализация слушает 8472 вместо 4789 — или наоборот.
  • Пытаются открыть «порт IPIP» на firewall, который пропускает только TCP/UDP.
  • Overlay считают лечением потерь и асимметрии underlay.
  • Все внутренние потоки схлопываются в один ECMP-путь из-за одинаковой внешней 5-tuple.

В следующей части поднимемся на L2 и попробуем растянуть Ethernet. Посмотрим, зачем VXLAN понадобился VNI, какую работу выполняет EVPN и почему broadcast-домен через несколько площадок нужно создавать только при наличии уважительной причины.

Предыдущая часть: «SDN без магии: карта видов связности»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «L2-overlay: VLAN, VXLAN, Geneve и EVPN»

Схема

#network #selfhosting

Обложка

Когда пришлось слезать с VMware на что-то реестровое, у всех всплыл один и тот же вопрос: «а на чём теперь крутить виртуалки?». Рынок мгновенно расцвёл — на карте уже больше трёх десятков логотипов. Но если открыть капот, почти всё сводится к двум гипервизорам: KVM и Xen. Разница — в обвязке.

Два столпа

KVM — гипервизор прямо в ядре Linux. Это не отдельная программа: ядро получает модуль kvm, и каждая виртуалка превращается в обычный процесс — qemu эмулирует ей железо (диски, сеть, PCI), а libvirt даёт единый API сверху. Плюс: виртуалка наследует весь зоопарк ядра — планировщик, memory management, cgroups. Минус: qemu сам по себе тяжёлый, и «поднять вручную» без libvirt быстро превращается в боль.

Xen — гипервизор отдельного типа: он стоит ниже операционных систем и запускает их как «домены». Есть привилегированный домен dom0 (управляющий) и рабочие domU. Классика Xen — паравиртуализация: гость знает, что он гость, и зовёт гипервизор напрямую, без полной эмуляции железа. Современный Xen умеет и HVM с аппаратной виртуализацией. Управляется через xapi/XAPI — тот же стек, что в XCP-ng.

Коротко: KVM — «виртуалка как процесс в Linux», Xen — «виртуалка как отдельный домен под гипервизором». Для админа разница чаще в обвязке, чем в производительности.

Кто на чём сидит

На oVirt (менеджмент поверх KVM) — целая пачка известных имён: РЕД Виртуализация, ROSA Virtualization, HOSTVM. Все трое — это KVM под капотом, а отличаются консолью, поддержкой и порталами для провайдеров.

На OpenStack (облачная платформа, тоже поверх KVM) — «Кибер Инфраструктура» и «Кибер Протект». Тут уже не просто виртуалки, а полноценный IaaS с тенантами и самообслуживанием.

На OpenNebula — «Альт Сервер Виртуализации» (basealt). Менее раскрученный, но тоже KVM-менеджмент.

Proxmox стоит отдельно: свой стек на KVM + LXC, без привязки к oVirt/OpenStack. Любимчик сисадминов за простоту.

«Собственная разработка» — самая интересная полка: БАЗИС.Dynamix, Брест, Астра, VMmanager, Space, ДаКом и остальные. Тут у каждого свой менеджмент-слой и свой гипервизор — но в ядре всё равно чаще всего KVM (реже Xen), просто написанный с нуля UI и кластерная логика.

Мораль

По данным исследования рынка на 2025 год, больше половины известных решений — это не уникальные технологии, а разные упаковки над одними и теми же открытыми гипервизорами. Поэтому выбирать стоит не по логотипу, а по трём вещам: кто поддержит, как переживается потеря узла и насколько честно работает живая миграция. «Под капотом» у большинства — одно и то же, а вот «что снаружи» — разное.

#selfhosting #network

Обложка

Цикл «Виды связности и SDN», часть 1.

Оси этой части: карта координат — уровень, underlay/overlay, управление, топология, шифрование.

Слово SDN успело побывать всем: технологией, архитектурой, пунктом в коммерческом предложении и наклейкой на обычном VPN с веб-интерфейсом. Из-за этого обсуждение часто начинается вопросом «что лучше — L3, mesh или WireGuard?» Примерно как «что лучше — грузовик, дизель или кольцевая дорога?»

Чтобы дальше не путаться, сначала разложим связность по отдельным осям. Через весь цикл используется одна лаборатория: офис за NAT, ЦОД A с белым IPv4, ЦОД B за CGNAT, облачная ВМ, ноутбук администратора и небольшой Kubernetes-кластер. Эту же инфраструктуру будем соединять разными способами.

Уровень сети

На L2 мы переносим Ethernet-кадры и имеем дело с MAC-адресами, ARP, broadcast и VLAN. Такой overlay может сделать вид, что две виртуальные машины в разных ЦОДах подключены к одному коммутатору.

На L3 мы переносим IP-пакеты и маршрутизируем отдельные сети. За каждым узлом или площадкой может находиться собственная подсеть, а остальная система должна знать путь до неё.

Сервисный overlay идёт ещё выше. Он может вообще не выдавать участнику адрес общей виртуальной сети, а предоставлять доступ только к конкретному приложению: например, к crm.internal:443. Так работает часть ZTNA-решений и OpenZiti.

Underlay и overlay

Underlay — сеть, которая уже умеет доставить внешний пакет от одного узла до другого. Это может быть Интернет, операторский L3VPN, собственная магистраль или IP-фабрика ЦОД.

Overlay — логическая сеть поверх неё. Исходный пакет помещается внутрь другого пакета и едет по underlay как груз в контейнере. VXLAN, Geneve, IPIP, GRE, WireGuard и IPsec делают это по-разному, но общая идея одна.

Overlay способен скрыть устройство нижележащей сети от конечных систем. Но он не чинит потери, перегруженные каналы, сломанный PMTUD и неправильную маршрутизацию под ним. Он только добавляет ещё одно место, где можно искать проблему.

Кто принимает решения

У сети может быть центральный контроллер. Он знает участников, выдаёт адреса, распространяет политики и сообщает узлам, как связаться друг с другом.

При этом пользовательский трафик не обязан идти через контроллер. В Tailscale, NetBird и похожих системах управление централизовано, а data plane по возможности строится напрямую между участниками.

Другой вариант — распределённый control plane. Например, маршрутизаторы обмениваются маршрутами по BGP, и каждый самостоятельно строит таблицу пересылки.

Есть смешанные схемы: центральная база хранит желаемое состояние, локальные агенты применяют политики, а маршруты распространяются распределённым протоколом.

Топология

Point-to-point — один туннель между двумя участниками.

Hub-and-spoke — все филиалы подключаются к центральному хабу. Просто управлять, но хаб становится транзитной точкой и потенциальным местом отказа.

Partial mesh — прямые связи создаются только там, где они нужны.

Full mesh — каждый участник может иметь прямую связь с каждым. Число потенциальных пар растёт квадратично; счёт и выбор топологии — в части 6.

Dynamic mesh не обязан держать все туннели постоянно. Контроллер может выдать двум узлам координаты друг друга только при появлении трафика.

Шифрование

VXLAN, Geneve, IPIP и GRE сами по себе не защищают содержимое. Они решают задачу переноса пакета, а не конфиденциальности.

MACsec шифрует связь на L2 между соседними устройствами. IPsec и WireGuard защищают IP-трафик между узлами. TLS и mTLS защищают конкретные прикладные соединения.

Иногда эти слои складываются: пакет приложения уже защищён TLS, затем попадает в VXLAN, а весь межузловой трафик дополнительно помещается в WireGuard. Без расчёта MTU такой сетевой матрёшке быстро становится тесно.

Где здесь SDN

Software-defined networking начинается там, где желаемая логика сети описывается программно и отделяется от конкретного устройства, пересылающего пакет.

Контроллеру говорят: «эта группа может обращаться к сервису, эти две сети изолированы, а маршрут площадки должен иметь два выхода». Он переводит это намерение в правила OVS, eBPF-программы, маршруты BGP, ACL или конфигурации туннелей.

Генератор десяти peer-конфигов WireGuard — это автоматизация, а не SDN. Между таким скриптом и OVN с распределёнными логическими маршрутизаторами лежит заметная архитектурная дистанция: во втором случае есть модель намерения, отдельный control plane и независимый data plane.

Пять вопросов перед выбором

Перед обсуждением продукта полезно ответить:

  1. Нам нужен Ethernet или маршрутизация IP?
  2. Какая сеть уже существует между узлами?
  3. Кто будет распространять адреса, маршруты, ключи и политики?
  4. Нужны прямые связи или допустим центральный транзит?
  5. Какое содержимое и между какими точками должно быть зашифровано?

После этого сравнение становится честнее. VXLAN конкурирует с Geneve как способ инкапсуляции. BGP и контроллер OVN решают задачу распространения состояния. WireGuard добавляет защищённый транспорт. Mesh описывает отношения между участниками.

Где это ломается

  • Overlay не чинит сломанный underlay: потери, асимметрия и фильтр ICMP остаются на месте.
  • «Пинг проходит» не означает исправный HTTPS: обычно виноват MTU, а не приложение.
  • Контроллер и data plane — разные отказы; зелёная панель не доказывает, что пакеты ходят напрямую.
  • Full mesh на схеме ещё не означает, что все пары реально подняты и нужны.
  • Сравнение «VXLAN vs контроллер vs WireGuard» почти всегда смешивает разные оси.

В следующей части разберём underlay и overlay подробнее: что именно вкладывается в туннель, откуда берётся потерянный MTU и почему «пинг проходит» ещё не означает исправную связность.

Предыдущая часть: —

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Underlay и overlay: сеть под сетью»

Схема

#network #selfhosting

Цикл «Не светим лишнего». Выпуск 3.

VPN обычно всплывает первым: «Надо пустить человека во внутреннюю сеть? Давайте VPN». И это не глупый ответ. Туннель даёт клиенту виртуальный адрес, шифрует трафик и позволяет работать с приватными IP так, будто пользователь находится рядом.

Проблема начинается, когда VPN используют не потому, что нужен туннель, а потому что других способов доступа никто не настроил.

Что VPN действительно умеет хорошо

Пользователь может открыть обычный RDP-клиент, SSH, WinBox, 1С, базу данных, файловую шару — всё, что говорит по IP. Не нужно публиковать каждый внутренний сервис отдельным DNAT. На шлюзе можно назначать разные адресные пулы и политики группам пользователей. Индивидуальный сертификат или ключ позволяет отличить устройства лучше, чем внешний IP.

Если есть филиал, постоянный администратор или управляемый корпоративный ноутбук, это очень удобная модель.

Split tunnel означает, что в туннель идут только нужные сети, а обычный Интернет остаётся через локального провайдера. Full tunnel, наоборот, забирает через корпоративный шлюз почти весь трафик клиента.

Где начинаются неудобства

На рабочей машине уже может быть VPN заказчика, личный WireGuard, агент безопасности с собственным туннелем или второй корпоративный клиент. Два туннеля начинают делить маршруты, DNS и приоритеты интерфейсов. Если обе стороны используют популярную сеть вроде 10.0.0.0/8 или 192.168.1.0/24, часть адресов становится физически неотличимой.

Некоторые клиенты включают kill switch и режут локальные маршруты. Некоторые установки требуют административных прав. Мобильному подрядчику надо объяснить, какой профиль импортировать, что нажать и почему его антивирус ругается на новый сетевой адаптер.

Ещё одна неприятность — чрезмерная связность. Человеку нужен один сервер на 443-м порту, а ему выдали маршрут до всей /24, потому что так было быстрее настроить.

Плюсы VPN

  • шифрование между клиентом и шлюзом;
  • любые протоколы поверх IP;
  • не нужно публиковать внутренние адреса наружу;
  • индивидуальные ключи, сертификаты и пользовательские политики;
  • хорошая модель для постоянных сотрудников и управляемых устройств.

Минусы

  • профиль или отдельный клиент на устройстве;
  • конфликты маршрутов, DNS и других VPN;
  • пересечение внутренних адресных пространств;
  • дополнительная нагрузка на шлюз;
  • риск выдать доступ к сети вместо доступа к конкретному ресурсу;
  • отдельная эксплуатация PKI, ключей, RADIUS и отзыва пользователей.

Где можно больно ошибиться

Считать VPN признаком безопасного устройства. Если ноутбук заражён, туннель честно перенесёт его трафик внутрь. VPN подтверждает ключ или учётную запись, но сам по себе не проверяет состояние ОС.

Один общий ключ. Общий WireGuard-конфиг или PSK для всех подрядчиков невозможно нормально отозвать у одного человека и трудно расследовать.

Слишком широкие маршруты. Даже если firewall потом режет трафик, пользователю лучше не анонсировать лишние сети без причины.

Нет MFA или второго барьера. Для постоянного административного туннеля одного пароля мало. Сертификат устройства плюс пользовательская авторизация выглядит значительно спокойнее.

Забытые профили. Человек ушёл, договор закончился, а сертификат и RADIUS-учётка продолжают жить.

Когда выбирать VPN

VPN стоит брать, когда человеку действительно нужна L3-связность: много сервисов, толстые клиенты, приватный DNS, постоянная работа, управляемое устройство. Для одного сайта логичнее reverse proxy. Для разового RDP — web-bastion. Для «открыть несколько портов на час с текущего адреса» временный allow-list может быть проще.

То есть мы VPN не отменяем. Просто перестаём использовать его как отвёртку, молоток и разводной ключ одновременно.

Ранее в цикле

Документация и источники

#network