Цифровой дворник

network

Обложка

Цикл «Виды связности и SDN», часть 5. Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet».

Ось: управление (control plane).

У SDN есть неприятная особенность: красивая панель управления легко отвлекает от вопроса, кто в действительности пересылает пакет.

Полезно отделять control plane от data plane.

Control plane знает участников, адреса, маршруты, ключи и политики. Data plane принимает конкретный пакет и решает, куда его отправить.

Центральное управление, прямой трафик

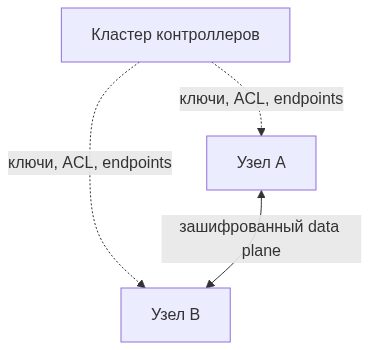
В mesh-системах контроллер часто выполняет роль диспетчера:

  • регистрирует узел;
  • проверяет пользователя или устройство;
  • выдаёт виртуальный адрес;
  • сообщает разрешённых участников;
  • распространяет публичные ключи и ACL;
  • помогает выбрать прямой endpoint или relay.

После этого два узла могут обмениваться зашифрованным трафиком напрямую. Контроллер не видит пользовательских пакетов и не является транзитным хабом.

При его отказе уже созданные туннели могут продолжать работу. Но новый узел не зарегистрируется, изменившийся endpoint не будет распространён, ключи не обновятся, а новая политика не применится.

У самого WireGuard есть исключение: если одна сторона сменила внешний адрес и отправила пакет первой, пир может обновить endpoint по входящему пакету. Это roaming протокола, а не замена контроллера. Когда обе стороны неизвестны друг другу или адрес нужно раздать третьим узлам, без control plane не обойтись.

Один контроллер

Для лаборатории и небольшой некритичной сети это нормальный вариант. Он прост, его легко резервно копировать и обновлять.

Проблема появляется, когда единственный контроллер начинают считать отказоустойчивым только потому, что он работает в виртуальной машине с автозапуском. Перезапуск VM — восстановление, но не всегда HA.

Нужно знать:

  • где хранится состояние;
  • можно ли поднять второй экземпляр;
  • поддерживает ли база конкурентную запись;
  • есть ли leader election;
  • как клиенты узнают адрес резервного узла;
  • можно ли обновить систему без разрыва управления.

Active-standby

Резервный экземпляр запускается после отказа основного или принимает его виртуальный адрес. Такая схема проще active-active, но имеет время обнаружения и переключения.

Если оба экземпляра случайно считают себя основными, можно получить split brain: разные версии политик, адресов и ключей. Поэтому одной репликации базы недостаточно — нужен механизм владения ролью.

Active-active и консенсус

Несколько контроллеров одновременно обслуживают клиентов. Изменения состояния согласуются через общую базу или распределённый журнал.

OpenZiti использует RAFT-кластер. Три контроллера с правом голоса переживают отказ одного, пять — двух. Для записи нужен кворум большинства. Потерявшая кворум часть может сохранить чтение старого состояния, но не должна принимать независимые изменения.

NetBird Community — один экземпляр Management. Active-active для Management и Signal относится к Enterprise: несколько инстансов плюс PostgreSQL, Redis и NATS. Postgres у одного Management высокой доступности не даёт.

Headscale ориентирован на один tailnet и небольшие установки; штатного active-active у него нет. SQLite рекомендован, PostgreSQL поддерживается в режиме сопровождения. Это не делает Headscale плохим, но определяет область применения. Подробнее о продуктах — в части 9.

Распределённый control plane

BGP не требует единого сервера, который знает все маршруты. Участники обмениваются информацией и локально строят RIB/FIB.

Но «распределённый» не означает «без важных центральных элементов». В крупном кластере появляются route reflectors. В EVPN-фабрике важны RR, border leaf и внешние пиринги. Их также нужно резервировать.

Федерация

Несколько площадок могут иметь собственный control plane и обмениваться только частью состояния. Такой подход ограничивает радиус аварии: ошибка одной площадки не обязана немедленно распространяться на все остальные.

Цена — сложнее глобальные политики, адресное планирование и маршрутизация между доменами.

Четыре теста отказа

Для любой SDN-платформы нужно отдельно проверить:

  1. Продолжается ли существующий поток после потери контроллера?
  2. Можно ли открыть новый поток между уже известными узлами?
  3. Можно ли добавить новый узел или распространить изменившийся адрес?
  4. Что происходит с изменениями ACL и отзывом скомпрометированного устройства?

Ответ «сеть продолжит работать» без уточнения обычно описывает только первый пункт.

Control plane тоже имеет сеть

Контроллеры, базы, brokers, STUN и relay сами зависят от DNS, TLS-сертификатов, маршрутизации и времени. Можно построить отказоустойчивый кластер из трёх узлов и разместить все три за одним маршрутизатором, одним DNS-провайдером и одним внешним IP.

Логическое резервирование не исправляет общую физическую точку отказа.

Где это ломается

  • Существующие туннели живы, а новый узел и новая ACL — нет; это принимают за «полное HA».
  • Два контроллера без выбора лидера дают split brain.
  • Community-редакцию масштабируют «просто Postgres’ом» и ждут active-active.
  • Три контроллера в одной стойке и за одним внешним адресом.
  • Забывают, что STUN, relay и DNS — тоже control/signalling plane.

В следующей части перейдём от управления к форме сети: hub-and-spoke, partial mesh, full mesh и региональные хабы.

Предыдущая часть: «L3-overlay и native routing: IPIP, GRE, BGP и CrossSubnet»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh»

Схема

#network #selfhosting

Обложка

Практический разбор операторской сети с IPoE, PPPoE, OSPF и NAT.

Все названия узлов, интерфейсов и IP-адреса изменены. Для примеров используется документационный диапазон 198.51.100.0/24. Сетевая логика и последовательность диагностики сохранены.

Иногда диагностика выглядит почти издевательски. На MikroTik есть маршрут до нужного адреса. OSPF-соседи в состоянии Full. С самого маршрутизатора цель доступна. Но абонент говорит: «не работает», и он тоже прав.

В нашем случае пакет проигрывал не в OSPF, не в firewall и даже не в NAT. Он вообще не добирался до маршрутизатора: CPE решил, что адрес назначения находится рядом с ним в одном L2-сегменте, отправил ARP-запрос и остался ждать ответа.

Разберём по порядку: как к этому привели общая публичная /24, тысячи изолированных VLAN и arp=reply-only, почему помог proxy-arp, какие побочные эффекты у такого лечения — и уже после разбора кейса пройдёмся по всем режимам ARP в RouterOS как по справочнику.

Исходная схема

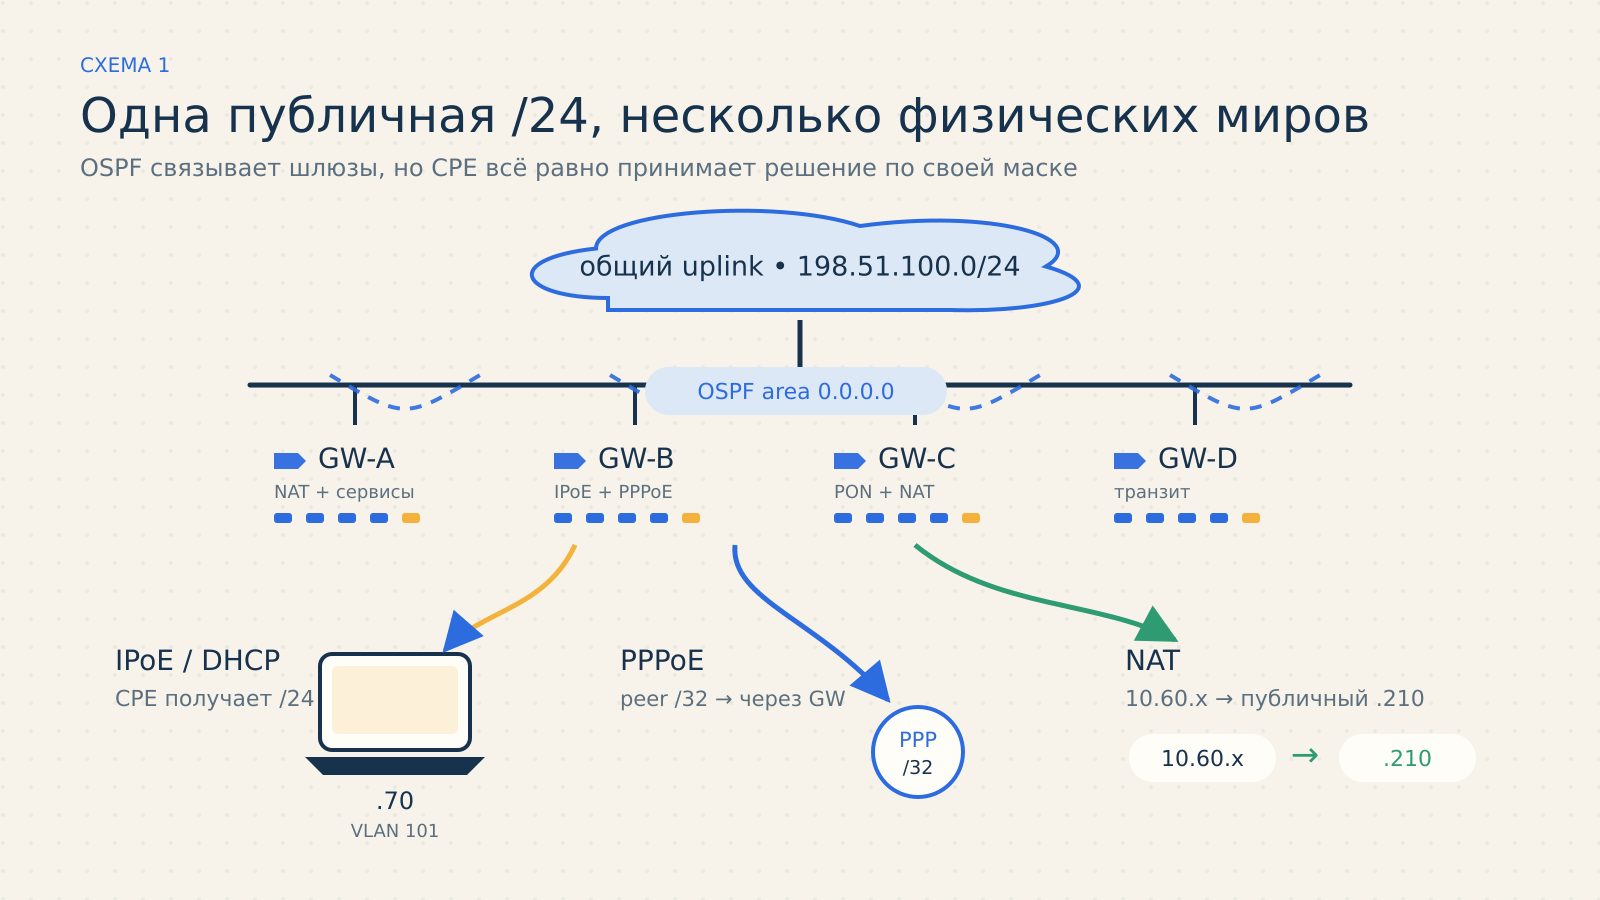
В сети было несколько MikroTik-шлюзов. Между ними работал OSPF, через который распространялись абонентские /32 и другие нужные маршруты.

Одновременно на общей uplink-сети использовался публичный блок 198.51.100.0/24. Адреса из него встречались сразу в нескольких ролях:

  • IPoE-абоненты в отдельных PON/VLAN-сегментах;
  • PPPoE-клиенты с адресом peer /32;
  • публичные адреса на uplink, используемые для src-nat и dst-nat;
  • служебные адреса самих шлюзов.

Упрощённая топология: четыре шлюза, OSPF, IPoE, PPPoE и NAT

IPoE-клиенту DHCP выдавал адрес из этого блока, шлюз и маску /24. Физически соседние адреса могли находиться на разных VLAN и даже на разных маршрутизаторах, но CPE об этом не знал: для него весь 198.51.100.0/24 выглядел одной локальной сетью.

Это и было заложенной миной.

Симптом

Типичная жалоба: IPoE-абонент 198.51.100.70 не пингует 198.51.100.123. На шлюзе при этом виден маршрут 198.51.100.123/32, полученный через OSPF.

Логика инженера понятна:

  1. маршрут есть;
  2. next hop доступен;
  3. значит, пакет должен уйти на соседний GW.

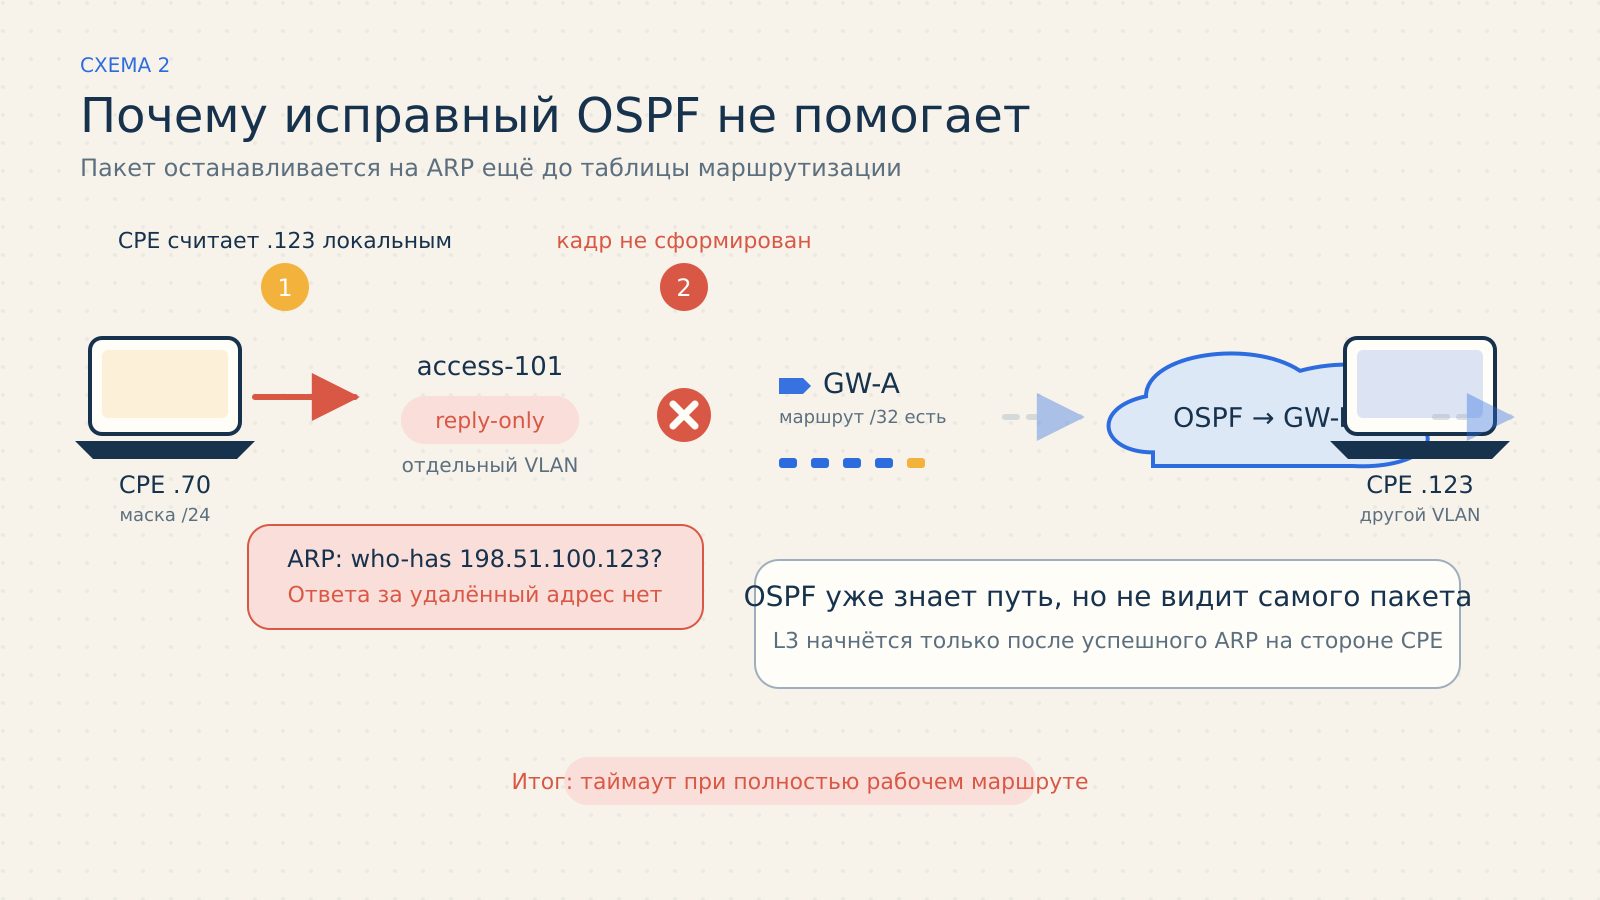
Но CPE с маской /24 рассуждает иначе:

  1. адрес назначения входит в мою локальную сеть;
  2. шлюз мне не нужен;
  3. сначала узнаю MAC-адрес 198.51.100.123 через ARP.

ARP broadcast остаётся внутри абонентского VLAN. Настоящего владельца адреса там нет. Ответить за него мог бы маршрутизатор, но на интерфейсе был включён arp=reply-only.

До исправления: ARP-запрос остаётся без ответа, а OSPF даже не получает пакет

Именно поэтому хороший маршрут не помогал: маршрутизация начинается только после того, как CPE сформировал Ethernet-кадр. Без MAC-адреса назначения кадра нет, IP-пакет не уходит со стороны клиента, и OSPF в этой сцене просто не получает реплики.

Что именно делал reply-only

Тут важна аккуратная формулировка. reply-only — не режим «отвечать только за адрес шлюза». В RouterOS он отключает динамическое ARP-обучение и опирается на заранее заданные соответствия IP/MAC в /ip arp. Такой режим часто используют вместе с DHCP add-arp=yes, чтобы неизвестное устройство не могло свободно подменить адрес.

Но reply-only не делает маршрутизатор ARP-посредником для адресов за другими интерфейсами. Валидный клиент может обращаться к самому шлюзу, однако на ARP-запрос о чужом 198.51.100.x маршрутизатор своим MAC не ответит.

Короткая памятка:

Режим Что происходит Где уместен
enabled Обычное динамическое ARP-обучение Стандартный L2-сегмент
reply-only Работа по статическим IP/MAC-записям, без динамического обучения Контролируемый access с DHCP add-arp=yes или ручными ARP-записями
proxy-arp Роутер отвечает своим MAC за адрес, путь к которому лежит через другой интерфейс Разнесённые L2-сегменты, которым выдали адреса из общего IP-префикса
local-proxy-arp Роутер проксирует ARP между узлами на одном и том же интерфейсе Изоляция клиентов внутри общего интерфейса/сегмента

В нашем кейсе адрес назначения находился за другим интерфейсом, поэтому нужен был именно proxy-arp, а не local-proxy-arp.

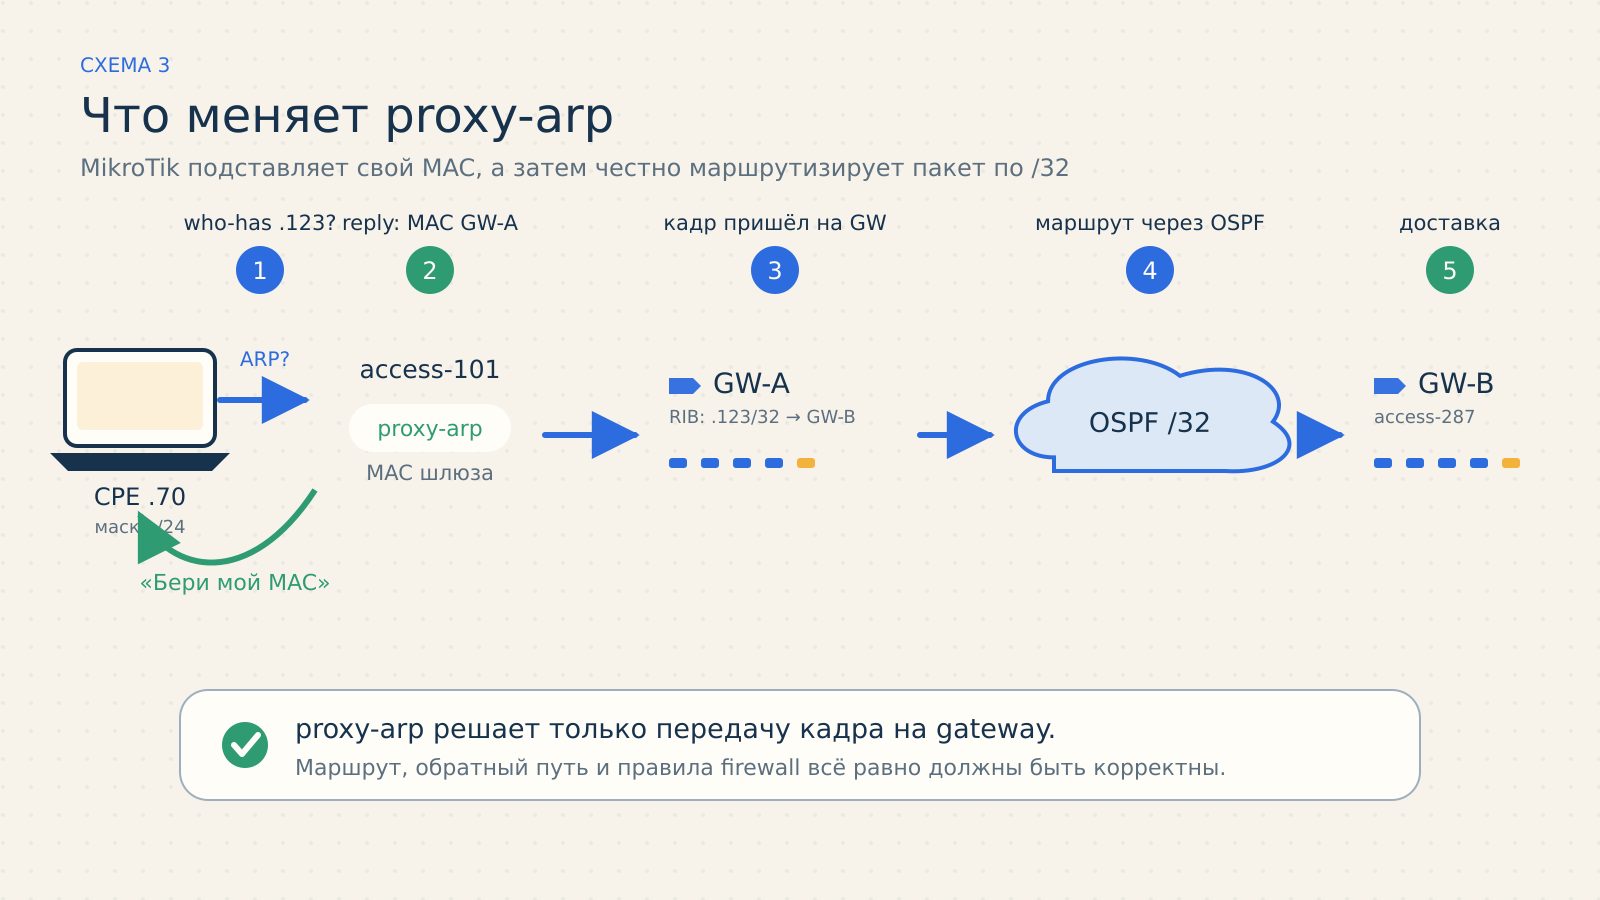
Как сработал proxy-arp

Proxy ARP — приём, описанный ещё в RFC 1027: маршрутизатор отвечает своим MAC-адресом на ARP-запросы о тех IP, которые лежат не в этом сегменте, а за другими его интерфейсами, и до которых у него есть маршрут. Хост получает ответ, считает, что цель находится рядом на канальном уровне, и отправляет кадр маршрутизатору. Тот, ничего не меняя в IP-заголовке, делает обычный L3-forwarding.

Важно, что «склейка» происходит не на канальном уровне, а через таблицу маршрутизации: маршрутизатор отвечает не за всё подряд, а только за адреса с активным маршрутом, и только если маршрут указывает не на тот интерфейс, откуда пришёл запрос.

На выбранных абонентских VLAN режим ARP сменили на proxy-arp, и последовательность стала такой:

  1. CPE спрашивает: «Кто такой 198.51.100.123?»
  2. MikroTik проверяет таблицу маршрутизации и видит путь к адресу через другой интерфейс.
  3. Маршрутизатор отвечает собственным MAC.
  4. CPE отправляет Ethernet-кадр на MikroTik, хотя IP-адрес назначения остаётся прежним.
  5. После этого начинается обычный L3-forwarding: маршрут /32, OSPF, соседний GW и нужный абонентский интерфейс.

После исправления: MikroTik отвечает своим MAC и передаёт пакет по маршруту

Пример точечной настройки:

/interface vlan print detail where arp=reply-only
/interface vlan set [find where name="access-101"] arp=proxy-arp
/interface vlan print detail where name="access-101"

Соблазн сразу выполнить что-то вроде set [find arp=reply-only] понятен, особенно когда VLAN несколько тысяч. Но сначала нужно определить, какие интерфейсы действительно относятся к этой модели IPoE: reply-only мог быть включён осознанно как часть защиты IP/MAC, а глобальное переключение изменит поведение всей сети доступа.

Если проксировать нужно буквально несколько адресов, RouterOS позволяет создать точечную опубликованную ARP-запись вместо включения proxy ARP для всего интерфейса:

/ip arp add address=198.51.100.123 interface=access-101 published=yes

Устройство ответит за этот IP только при наличии активного маршрута до него. Для тысяч динамически размещённых абонентов такой способ быстро превращается в отдельную систему учёта, но для единичного сервисного адреса он бывает аккуратнее — и, что важно, не отменяет reply-only для остальных адресов сегмента.

Перед массовой правкой стоит:

  • сохранить export и список исходных ARP-режимов;
  • отобрать интерфейсы по понятным именам, спискам или комментариям;
  • проверить один тестовый VLAN;
  • убедиться, что фильтры forward по-прежнему обеспечивают нужную изоляцию абонентов;
  • подготовить обратное переключение для каждого изменяемого интерфейса.

Что получилось после изменения

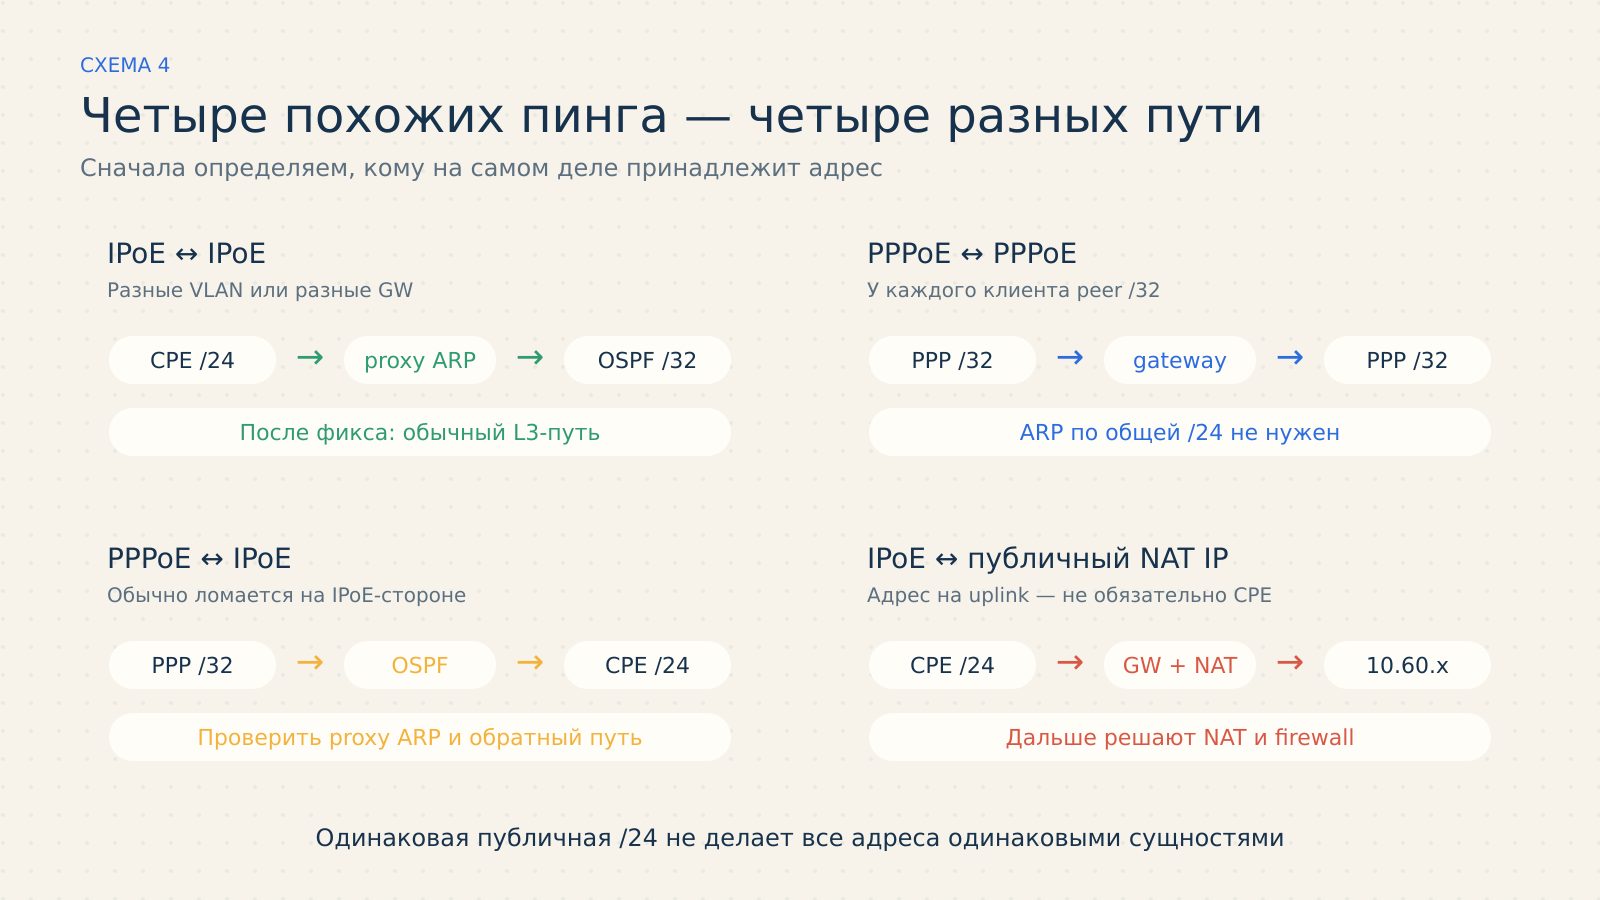
Сценарий До После proxy-arp на IPoE-VLAN
IPoE ↔ IPoE, разные VLAN/GW CPE ждёт ARP, пакет не доходит до GW CPE отправляет кадр на MAC шлюза, дальше работает L3
PPPoE ↔ PPPoE Обычно работало через peer /32 По сути без изменений
PPPoE ↔ IPoE Часто ломался обратный путь на стороне IPoE Работает при корректных маршрутах и firewall
IPoE ↔ публичный NAT IP Выглядело как поломка связи двух абонентов ARP-часть исправлена, но результат всё ещё зависит от NAT/firewall

Последняя строка таблицы — не формальность: именно на ней разбор чуть не увёл в неверную сторону.

Ловушка: адрес выглядит абонентским, но это NAT

Во время разбора попалась пара адресов, которая сначала казалась идеальным тестом:

  • 198.51.100.70 — настоящий IPoE-клиент на одном GW;
  • 198.51.100.210 — «белый IP», который ожидали увидеть у другого абонента.

Но второй адрес оказался назначен uplink-интерфейсу другого маршрутизатора и использовался как внешний адрес для NAT частного пула. Никакого CPE с адресом .210 не существовало.

Это меняет смысл проверки. Пинг «абонент ↔ абонент» внезапно становится проверкой «IPoE-клиент ↔ адрес самого GW или сервис за dst-nat», а результат зависит уже от правил NAT, firewall и того, есть ли вообще трансляция для ICMP.

Четыре разных сценария, которые снаружи выглядят как связь между адресами одной /24

Поэтому перед выводом «абоненты друг друга не видят» полезно установить владельца каждого IP:

/ip address print detail where address~"198.51.100.210"
/ip arp print detail where address=198.51.100.210
/ppp active print detail where address=198.51.100.210
/ip firewall nat print detail where dst-address~"198.51.100.210"

А затем проверить, есть ли для него host route и где он был получен.

При чём здесь OSPF

OSPF в этой истории не был причиной поломки — он лишь доставлял между шлюзами информацию о том, где находится конкретный абонентский /32. Но чтобы proxy-arp заработал, должны выполняться два условия:

  • нужный /32 действительно должен присутствовать в RIB/FIB выбранного MikroTik;
  • маршрут должен указывать через другой интерфейс, иначе обычный proxy-arp не решит задачу.

Для RouterOS v7 маршрут удобно смотреть так:

/routing route print detail where dst-address=198.51.100.123/32
/routing ospf neighbor print detail

В RouterOS v6 таблица маршрутов проверяется через:

/ip route print detail where dst-address=198.51.100.123/32

Если /32 не анонсируется, соседство застряло в ExStart/Exchange или маршрут отфильтрован, proxy-arp проблему не исправит: он помогает клиенту передать пакет маршрутизатору, но маршрут до цели всё равно должен существовать. Это прямое следствие механики режима — решение об ARP-ответе принимается по таблице маршрутизации, поэтому пустая FIB означает тишину в ответ на who-has.

Практический порядок диагностики

Из всего этого сложилась рабочая последовательность.

1. Проверить логику CPE

Посмотреть выданную маску. Если клиент получил /24, он будет ARP-ить любой адрес из этой /24, даже если оператор разнёс адреса по разным VLAN.

2. Посмотреть ARP на access-интерфейсе

/interface vlan print detail where name="access-101"
/tool sniffer quick interface=access-101 mac-protocol=arp

Характерный симптом: от CPE приходит who-has, но ответа за удалённый адрес нет.

3. Проверить маршрут до точного адреса

Смотреть нужно не только общий connected /24, но и специфичный /32. Иначе трафик может уйти на общий uplink или не к тому GW.

4. Установить реального владельца IP

Адрес может принадлежать IPoE-клиенту, PPP-сессии, интерфейсу маршрутизатора, NAT-пулу или вообще быть свободным. Одинаковая запись в заявке «белый IP» ещё не означает одинаковую сетевую сущность.

5. Проверить OSPF и обратный путь

Соседство должно быть Full, нужный /32 — установлен, а обратный маршрут — симметричен или хотя бы допустим правилами firewall и rp-filter.

6. Только после этого включать proxy-arp

Сначала на одном VLAN, затем на небольшой группе, и лишь потом — массово. После изменения проверяются ARP, ping, TCP-сессия и счётчики firewall в обоих направлениях.

Как устроен proxy ARP: режимы RouterOS

Кейс на этом закрыт. Дальше — справочная часть: что именно RouterOS делает с ARP в каждом режиме и почему в нашей ситуации выбор был безальтернативным.

Начать стоит с логики хоста. Собираясь отправить IP-пакет, он сначала решает, «локальный» адрес назначения или нет: применяет свою маску к своему и к целевому адресу. Если адреса попали в одну подсеть, шлюз не используется вовсе — хост рассылает широковещательный ARP-запрос who-has и ждёт, кто отзовётся своим MAC. Ethernet-кадр без MAC назначения не собирается, поэтому при отсутствии ответа никакого IP-трафика просто не появляется.

Proxy ARP в RFC 1027 прямо называли «ARP-хаком» для подсетей: механизм придумали для стеков, которые не умели работать с подсетями. Живёт он ровно по той же причине, что и в нашем кейсе: адреса одной подсети оказались разнесены по разным линкам, VLAN или тоннелям, а хосты об этом не знают. Побочный эффект хорошо видно в ARP-таблице клиента: десятки разных IP там отображаются на один и тот же MAC шлюза.

Теперь по режимам, которые RouterOS позволяет задать на интерфейсе (подробности — в официальной документации по ARP):

  • enabled — поведение по умолчанию. Маршрутизатор отвечает на запросы о своих адресах, сам рассылает who-has, когда нужно, и динамически учит соответствия IP/MAC. Подходит для обычного доверенного сегмента: серверная сеть, офисный LAN, транзитный линк.
  • disabled — ARP на интерфейсе не работает совсем: ни ответов, ни обучения. Связность возможна только со статическими записями в /ip arp с обеих сторон. Применяется в жёстко зафиксированных схемах и на линках, где ARP не нужен по своей природе (PPP-подобные точка-точка).
  • reply-only — компромисс между контролем и удобством: динамического обучения нет, маршрутизатор работает исключительно по статическим и добавленным DHCP-сервером записям. Отсюда и связка с параметром add-arp=yes: клиент получил адрес по DHCP — запись появилась; сменил IP или MAC вручную — не общается ни с кем. Это ровно тот режим, который и стоял на наших access-VLAN.
  • proxy-arp — маршрутизатор дополнительно отвечает своим MAC за адреса, достижимые через другие интерфейсы. Именно этот режим нужен, когда хосты одной подсети физически раскиданы по разным сегментам, а переделать маску на всех CPE нельзя.
  • local-proxy-arp — маршрутизатор проксирует ARP между узлами того же интерфейса: клиент A спрашивает про клиента B, находящегося в том же VLAN или бридже, и получает MAC шлюза, после чего весь трафик между ними идёт через маршрутизатор. Так делают, когда на L2 включена изоляция портов (bridge horizon, PON client isolation), но соседи всё же должны видеть друг друга — уже под контролем firewall и учёта.

Разница между двумя proxy-режимами — исключительно в том, где находится цель: за другим интерфейсом или в том же сегменте. Подменить один другим не получится, это отдельные значения параметра, и на интерфейсе действует одно из них. Соответственно, включая proxy-arp, вы отказываетесь от строгости reply-only на этом интерфейсе, и защиту от подмены адресов приходится переносить на DHCP snooping, ACL и firewall.

Когда proxy-arp полезен

Несмотря на репутацию «костыля», у режима есть сценарии, где он не просто работает, а является наиболее логичным решением.

  • Адреса одной /24 разнесены по разным VLAN и интерфейсам, а CPE считает их локальными — наш случай. Клиент никогда не отправит пакет шлюзу, потому что по своей маске он «уже дома»; единственный способ вклиниться в этот диалог — ответить ему на ARP.
  • Тоннели и мосты, где удалённая подсеть должна выглядеть локальной. Через EoIP, GRE или IPIP приходят адреса того же префикса, и хостам на одной стороне нужно ARP-разрешать адреса другой; proxy ARP позволяет не растягивать broadcast-домен и не поднимать полноценный L2-мост, оставив стык на маршрутизации.
  • Быстрое восстановление связности без миграции адресации. Переразметка сети с /24 на per-subscriber /32 — это проект на недели, с перевыпуском DHCP-опций и правкой профилей; включение proxy-arp на нужных интерфейсах возвращает сервис за минуты и не требует прикасаться к абонентскому оборудованию.
  • Единичные «белые» адреса и сервисы для устройств с зашитой маской. Старый принтер, терминал или контроллер с жёстко прописанными адресом и /24 физически не умеет ходить через шлюз к соседнему префиксу; proxy ARP (а лучше — точечная опубликованная ARP-запись) делает такой адрес достижимым, не требуя перенастройки самого устройства.
  • Ситуации, где local-proxy-arp не подходит. Если цель находится за другим интерфейсом, а не среди соседей по сегменту, локальный вариант не сработает вообще: он рассчитан на проксирование внутри одного интерфейса и не смотрит на маршруты за его пределы.

Цена решения

proxy-arp оказался рабочим операционным исправлением, но он не превращает исходный дизайн в идеальный. Что приходится учитывать:

  • маршрутизатор становится обязательным посредником между адресами, которые CPE считает локальными;
  • ARP-таблицы и uplink могут стать шумнее;
  • при неоднозначной маршрутизации несколько GW способны отвечать за один адрес, поэтому нужны специфичные /32 и аккуратная фильтрация анонсов;
  • клиентская изоляция теперь должна явно обеспечиваться firewall, а не случайным отсутствием ARP-ответа;
  • широкое включение proxy-arp частично меняет исходную модель защиты reply-only.

«Костылём» этот режим называют вполне обоснованно. Во-первых, он поощряет клиента ARP-ить весь префикс: каждое новое направление добавляет запись в ARP-кэш CPE и порождает широковещательный запрос в сегменте, а на масштабе тысяч VLAN и десятков тысяч устройств это заметная фоновая нагрузка и раздутые таблицы соседств. Во-вторых, он размывает границу между L2 и L3: логически адреса маршрутизируются, но топология в голове хоста остаётся плоской, из-за чего диагностика перестаёт совпадать со схемой — «локальный» по мнению CPE адрес фактически лежит через два хопа и чужой firewall. В-третьих, страдает изоляция: пока ARP-ответа не было, соседи по префиксу физически не могли достучаться друг до друга, а теперь между ними есть исправно работающий посредник, и единственное, что их разделяет, — правила в forward.

Отдельная категория неприятностей — неоднозначность. Если один и тот же префикс присутствует на нескольких шлюзах, за один и тот же адрес потенциально может ответить не тот маршрутизатор, у которого лучший путь, а тот, чей ARP-ответ пришёл первым; клиент закрепит в кэше «случайный» MAC на время жизни записи. Дальше подключается асимметрия: трафик уходит через одного GW, возвращается через другого, и rp-filter вместе с connection tracking начинают отбрасывать вполне легитимные пакеты, а причина выглядит как «иногда работает, иногда нет». Всё это лечится специфичными /32, аккуратной фильтрацией анонсов OSPF и предсказуемой политикой обратного пути.

И всё же в операторских IPoE-сетях proxy-arp регулярно оказывается единственным быстрым фиксом. Абонентские устройства оператору не принадлежат, маску и шлюз в них меняет только DHCP, а массовое переучивание парка CPE на новую адресную модель — это согласования, окна работ и обращения в поддержку. Когда связность нужна сейчас, а адресация исторически плоская, включение прокси на нужных access-интерфейсах даёт результат в пределах одной сессии в терминале и оставляет время на нормальный редизайн.

Стратегически чище выдавать абоненту /32 с маршрутом через gateway либо использовать адресную модель, в которой CPE не считает весь публичный блок своим L2-сегментом. PPPoE изначально ближе к этой логике: у клиента есть peer, и чужой адрес сразу отправляется маршрутизатору.

Но миграция адресации — отдельный проект. Когда сеть уже построена на общей /24, а простоя быть не должно, точечно включённый proxy-arp позволяет восстановить связность без переделки всех CPE за одну ночь.

Вывод

Главный урок этого случая простой: наличие маршрута ещё не доказывает, что пакет дошёл до уровня маршрутизации. При слишком широкой маске CPE сначала ищет удалённый адрес через ARP, и с reply-only этот запрос остаётся без ответа. proxy-arp подставляет MAC шлюза, после чего уже начинают работать OSPF, NAT и привычная L3-диагностика.

В следующий раз, когда OSPF уверенно показывает нужный /32, а абонент всё равно никого не видит, стоит посмотреть не только route print, но и один скромный who-has, который так и не получил ответа.


Официальная документация MikroTik: ARP и режимы proxy/reply-only, DHCP и параметр add-arp, OSPF в RouterOS, Packet Sniffer, отличия маршрутизации RouterOS v6 и v7. Термин proxy ARP и исходное описание механизма — RFC 1027.

#network #mikrotik #ospf

Обложка

Исследовательская статья, август–сентябрь 2026. Все адреса абонентов и часть публичных адресов в примерах обезличены. Это не инструкция по обходу ограничений, а описание эксплуатационной диагностики сети оператора.

Есть довольно мерзкий тип сетевой аварии: почти всё, что обычно смотрит мониторинг, зелёное. Линк поднят, маршрутизация есть, DNS отвечает, пинг идёт, speedtest иногда даже показывает вполне приличную скорость. Но при этом Windows пишет «без доступа к Интернету», телефон решает, что Wi‑Fi плохой, игра не может авторизоваться, IoT теряет облако, часть HTTPS-сайтов открывается, часть висит до тайм-аута, а некоторые системные connectivity-check вообще перестают проходить.

Для пользователя диагноз простой:

Интернет сломался.

Для оператора всё значительно веселее: по классическим метрикам он как будто не сломался.

Мы впервые плотно столкнулись с этим летом 2026 года. Началось всё с одного домашнего подключения и Wireshark, а к сентябрю выросло в отдельный операторский контур из NetFlow v9, GoFlow2, ClickHouse, Grafana и собственной системы проверок доступности. Вместе с контуром поменялся и главный вопрос. Сначала он звучал так:

Почему у одного клиента «нет Интернета», когда пинг есть?

Теперь так:

Можно ли на уровне оператора увидеть сетевой след фильтрации, понять, какой публичный CGNAT уже деградирует, и найти внутри него абонента, который генерирует особенно аномальный трафик?

Спойлер: прочитать внутреннее правило ТСПУ по NetFlow нельзя. Но увидеть последствия происходящего — вполне.


С чего всё началось: июньский Wireshark

Вот один из дампов, снятых ещё в июне.
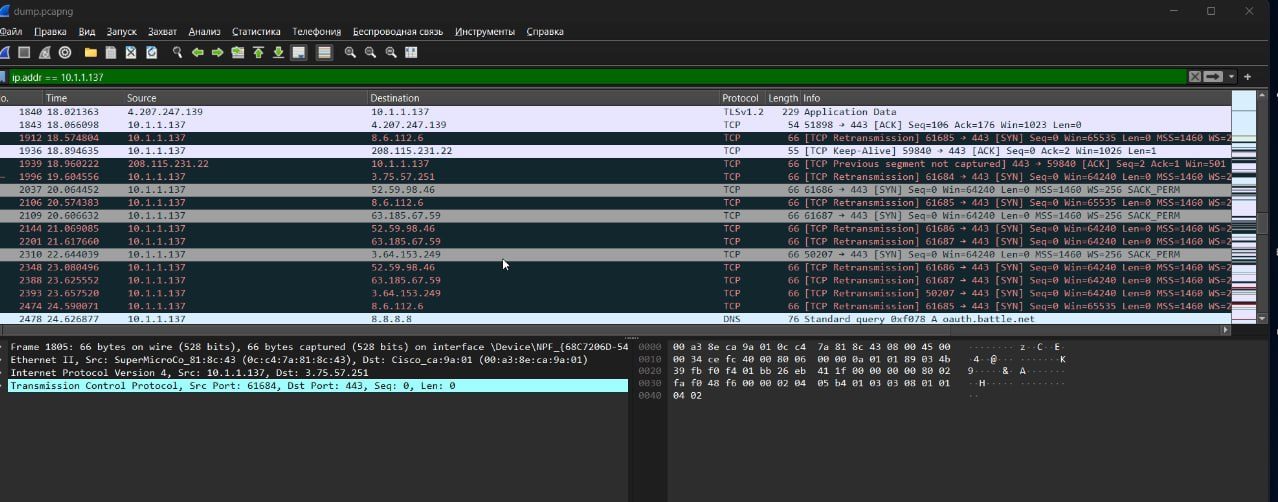
Wireshark: повторные SYN к TCP/443 при живом остальном трафике

На этом скриншоте интереснее всего не отдельная строка, а соседство совершенно разных картин. В одних TCP-сессиях видны нормальные ACK и keepalive, внизу живёт DNS — то есть интерфейс не отвалился, IP-маршрутизация не исчезла, стек TCP в целом работает. А рядом к нескольким другим адресам на TCP/443 идут:

SYN →
...
SYN Retransmission →
...
SYN Retransmission →

И сессия так и не переходит в нормальный handshake. Нет ни ожидаемого:

SYN →
    ← SYN-ACK
ACK →

ни явного отказа:

SYN →
    ← RST

Просто тишина и повторные SYN.

Наблюдение оказалось важным: оно объясняло, почему «пинг есть» вообще ничего не гарантирует. ICMP может прекрасно проходить, DNS может отвечать, часть уже установленных соединений может жить, а новые TCP-сессии к определённым направлениям при этом не устанавливаются. Для приложения это выглядит как обычный сетевой тайм-аут: оно ждёт, повторяет попытку, снова ждёт. Для пользователя — как «Интернет то есть, то нет». Для простого ICMP-мониторинга — как отсутствие аварии.

Именно этот июньский дамп потом оказался полезен второй раз: в сентябре мы увидели почти тот же симптом, только уже не в PCAP одного клиента, а массово в NetFlow оператора.


Из той истории появился connect-check

Прежде чем строить операторскую аналитику, пришлось научиться фиксировать сам факт деградации со стороны клиента. Ручной перебор сайтов и curl довольно быстро перестал быть полезным: если не открывается один зарубежный сервис, это ещё ничего не говорит, а если не открывается ресурс, который и должен быть ограничен, — тем более.

Нужен был набор независимых проверок разных классов:

  • connectivity-check Android, Windows и Apple;
  • российские сайты;
  • банки и государственные сервисы;
  • зарубежные HTTPS-ресурсы;
  • игровые платформы;
  • AI-сервисы;
  • DoH и DoT;
  • QUIC;
  • NTP;
  • MQTT и IoT;
  • push;
  • CDN;
  • почтовые сервисы.

Так появился наш connect-check:

https://github.com/cooler58/connect-check

Он выполняет сотни проверок и складывает результат в один HTML-отчёт. Но для нынешнего исследования особенно важна одна вещь: в каталоге есть признак expected_block.

Условно:

expected_block = 1

означает: недоступность этого ресурса сама по себе сейчас не доказывает локальную проблему нашего egress.

А:

expected_block = 0

означает: ресурс в нормальной ситуации должен быть доступен, и его неожиданный fail уже интересен как внешняя фактура деградации.

Это избавляет нас от очень удобной, но неправильной логики: «увидели высокий score в NetFlow — значит, ТСПУ заблокировал адрес». Высокий score — только гипотеза. Событием для калибровки становится независимое наблюдение: например, на известном публичном egress одновременно перестают проходить обычные российские сервисы и системные проверки, которые падать не должны.


Почему домашнего tcpdump стало мало

PCAP отлично отвечает на вопрос, что происходит с конкретным клиентом прямо сейчас. Но у оператора задача другая: за одним публичным IPv4 через CGNAT могут сидеть десятки или сотни абонентов:

10.20.55.10  ─┐
10.20.55.11  ─┤
10.20.55.12  ─┤
10.20.55.13  ─┤
      ...      ├── CGNAT ── PUBLIC IPv4 ── Internet
10.20.55.184 ─┤
      ...      │
10.20.55.240 ─┘

Для внешнего мира вся эта компания — один адрес. И отсюда вырастает уже операторский вопрос:

Если внешний фильтр, WAF, антифрод или какая-то другая stateful-система принимает решение на уровне публичного IPv4, может ли один особенно «шумный» inside испортить жизнь соседям по NAT?

Сам по себе такой collateral effect давно известен и вообще не уникален для ТСПУ. Например, Cloudflare в 2025 году показал, что CGNAT-адреса попадали под rate limiting примерно втрое чаще обычных IP, хотя медианный bot-rate у CGNAT и non-CGNAT был почти одинаковым. Причина банальна: за одним адресом смешивается поведение множества разных людей и устройств.

Источник: Cloudflare — One IP address, many users: detecting CGNAT to reduce collateral effects.

Поэтому наша гипотеза с самого начала была шире формулировки «ТСПУ банит NAT». Нас интересует shared-IP collateral: может ли аномальная активность одного или нескольких insides менять сетевую судьбу всего публичного egress.


Операторский контур: NetFlow вместо тотального PCAP

Можно было зеркалировать весь трафик и писать PCAP. На небольшой лаборатории это прекрасная идея, а на операторской сети она довольно быстро превращается в отдельный проект по хранению, производительности, приватности и поиску по терабайтам захватов. Поэтому первый массовый слой мы сделали на NetFlow v9.

Схема получилась такой:

MikroTik / edge routers
        │
        │ NetFlow v9
        ▼
     GoFlow2
        │
        ▼
 Python ingest
 batch + disk spool
        │
        ▼
   ClickHouse
 raw + 1m/5m aggregates
        │
        ├── threat views
        ├── TSPU/silent-drop views
        ├── connect-check views
        └── BEFORE/EVENT/AFTER
                 │
                 ▼
              Grafana

Kafka на первом этапе не добавляли: чем меньше компонентов в исследовательском стенде, тем проще понять, кто именно врёт. Raw flow при этом сохраняем отдельно с TTL, и это оказалось принципиально важно — заранее мы несколько раз ошиблись в том, какая именно метрика окажется полезной. Если бы остались только готовые минутные агрегаты, каждую новую гипотезу пришлось бы проверять только на будущих данных.


Что NetFlow видит, а чего не видит

NetFlow не превращается в DPI только потому, что рядом появился ClickHouse. Мы не видим:

  • содержимое TLS;
  • HTTP payload;
  • точное SNI каждой сессии;
  • последовательность отдельных TCP-пакетов;
  • retransmission так же подробно, как в PCAP;
  • внутреннюю метку ТСПУ «эта сессия заблокирована»;
  • конкретное правило, принявшее решение.

Зато видим форму трафика:

src / dst
src_port / dst_port
protocol
tcp_flags
packets
bytes
duration
NAT fields
exporter
timestamp

А из неё уже можно считать:

  • flows/sec;
  • SYN flows;
  • SYN без ACK;
  • RST flows;
  • долю очень коротких flows;
  • число уникальных destination;
  • число destination ports;
  • число внутренних адресов за NAT;
  • UDP/443 и TCP/443;
  • изменение всего перечисленного относительно обычного baseline.

И вот этого неожиданно хватило, чтобы увидеть очень характерные профили.


Нюанс, на котором легко сломать всю аналитику: TCP flags

В нашем NetFlow tcp_flags — это OR флагов за жизнь flow. Поэтому мы сознательно говорим:

SYN flow, а не SYN packet.

Если в записи присутствует SYN, это значит, что внутри flow был SYN, но не обязательно, что запись состояла из одного-единственного SYN-пакета. На первый взгляд мелочь, а на практике без этой оговорки очень легко нарисовать красивую, но физически неправильную историю.


Первая серьёзная ошибка: мы смотрели на inside, а надо было на egress

Когда жалуется клиент 10.x.x.x, рука сама тянется строить аналитику вокруг него. Для CGNAT это неправильная единица исследования: внешняя система не знает, какой именно 10.20.55.xxx сейчас создаёт соединение, она видит публичный SNAT. Поэтому модель пришлось перевернуть:

PUBLIC NAT
   │
   ├── inside A
   ├── inside B
   ├── inside C
   └── inside N

Сначала мы отвечаем, что происходит с публичным egress, и только потом — кто внутри внёс максимальный вклад в его профиль. Это, пожалуй, самый важный архитектурный вывод всего эксперимента.


Вторая ошибка: postNATSource не всегда означает наш NAT

Стоило начать считать по публичным адресам, как у MikroTik NetFlow v9 обнаружилась занятная ловушка. NAT-поля присутствуют и на входящем трафике, поэтому без дополнительной проверки в топы nat_ip внезапно начинали попадать чужие внешние peer-адреса. Получалось очень убедительно и совершенно бессмысленно.

Реальный egress пришлось определять жёстче:

src = private / CGNAT
nat_src = public
nat_src != src
nat_src принадлежит нашей адресации

Только после этого аналитика по публичным NAT стала пригодна для сравнения.


Третья ошибка: BitTorrent прекрасно притворяется сканером

Следующая ловушка ждала уже в самих эвристиках. Наивный скан-детектор выглядит примерно так:

uniq_dst ↑
uniq_dst_port ↑
flows ↑

Проблема в том, что хороший активный P2P-клиент выглядит примерно так же: сотни peers, множество портов, масса коротких UDP flows, постоянные новые destination. Если просто поставить порог на fan-out, половина «злоумышленников» окажется торрентами. Поэтому в threat-профиль пришлось добавить отдельный p2p_like и dampen: если трафик похож на BitTorrent/DHT, высокий fan-out сам по себе не превращается в port-scan.

Отсюда общее правило для подобных исследований:

Одна высокая метрика почти никогда ничего не доказывает.


Что говорят открытые материалы про ТСПУ

Здесь нужна важная оговорка. У нас нет доступа к внутренним логам ТСПУ или ЦСУ. Для понимания возможной архитектуры мы используем открытый проект DanielLavrushin/tspu-docs — подробную реконструкцию по материалам лекции. Мы не считаем её официальной нормативной документацией и используем только как источник технических гипотез. Но несколько деталей из неё очень хорошо рифмуются с нашими наблюдениями.

1. Для protocol-block описан send RST off

В главе 17 описан параметр send RST off: при его выключенном состоянии TCP Reset при блокировке распознанных протоколов не отправляется, соединение молча отбрасывается и клиент дожидается тайм-аута. Мотивация там тоже понятна: немедленный RST заставляет приложение быстро создавать новую попытку и может породить ещё больше сессий.

Для нас это важно не как «доказательство внутренней настройки конкретной площадки», а как объяснение, почему отсутствие RST вообще не противоречит модели фильтрации. То, что в июне выглядело как повторные SYN в Wireshark, а в сентябре — как высокий syn_no_ack в NetFlow, физически вполне согласуется с silent drop.

2. Для протоколов описана двухстадийная схема

В главе 8 описана схема:

DPI recognition
behavior = ignore
       │
       ▼
protocol logs
       │
       ▼
SPFS / ЦСУ
очистка false positives
       │
       ▼
IP + port lists
       │
       ├── filter: block
       └── Eco Highway: L3/L4 block

То есть предварительное распознавание шифрованного протокола само по себе не обязано сразу рвать сессию. Сначала результаты собираются, затем централизованно очищаются, после чего формируются списки IP+порт. Там же для тестовой зоны приведён ориентир полного цикла порядка 5–15 минут — от обнаружения нового протокольного endpoint до загрузки очищенного списка. Для нашей аналитики это подсказка смотреть не только момент уже случившегося fail, но и 5–30 минут до него.

3. Разные механизмы могут оставлять разные следы

Открытая реконструкция описывает и DPI-фильтры, и второй эшелон, где готовые IP+port-списки могут применяться на L3/L4. Для NetFlow это означает неприятную, но полезную вещь:

не надо требовать одного универсального «отпечатка блокировки».

В разных сценариях мы можем получить:

  • RST-heavy;
  • silent SYN drop;
  • короткие оборванные flows;
  • изменение TCP/443 ↔ UDP/443;
  • частичную, а не полную деградацию.

Именно это мы в итоге увидели на живых данных.


Июнь и сентябрь: один симптом в двух масштабах

Июньский PCAP показывал локально:

новый TCP/443
SYN
тишина
повторный SYN
тишина

В сентябре на части публичных NAT мы увидели то же самое уже статистически:

syn ≈ syn_no_ack
short3 ↑
RST ≈ low

То есть большая доля TCP flows содержит SYN, но не показывает признаков нормального развития handshake, а сами записи очень короткие. Мы назвали этот класс:

silent_syn_drop

Это название наблюдаемого эффекта, а не утверждение «мы доказали конкретное внутреннее правило ТСПУ».


Фактура 8 сентября: один особенно интересный CGNAT

Первое событие, где статистика и клиентская фактура сошлись по времени, мы получили 8 сентября — от абонента за одним из публичных NAT. В публикации адрес обезличим.

inside:  10.20.55.xxx
egress:  203.0.113.xxx

Сводка connect-check:

FAIL     209
WARNING  113
OK       198

То есть это не «чёрный экран и полный обрыв Интернета». Почти двести проверок продолжали работать — и именно поэтому проблема выглядела так неприятно: часть Интернета есть, часть нет, часть отвечает нестабильно. Среди неожиданных fail были ресурсы с expected_block=0, в том числе Госуслуги и Ведомости; параллельно массово ломались системные connectivity-check и разные зарубежные HTTPS/IoT-сервисы. Это уже хорошая метка времени: на данном egress действительно наблюдалась заметная частичная деградация, которая не сводилась к обычному списку ожидаемо ограниченных ресурсов.

Теперь смотрим NetFlow того же публичного NAT примерно в тот же период. В одном из срезов:

Метрика Наблюдение
внутренних адресов за NAT ~186
short flows до 3 пакетов ~88%
RST ~0.4%
уникальных destination ~2682
уникальных destination ports ~790
flow rate ~266 flows/s

На raw-окне порядка 15 минут только TCP/443 было около 145 тыс. flows примерно к 3,8 тыс. destination. Отдельно бросался в глаза fan-out по TCP/22: около 1,8 тыс. flows примерно к 322 адресам назначения.

Сами по себе цифры «виноват ТСПУ» не доказывают, но профиль откровенно шумный и по составу совпадает с описанным выше silent-классом — теперь на масштабе целого NAT. И одновременно независимый connect-check говорит: на этом же публичном адресе уже плохо работают сервисы, которые должны быть доступны. Вот такое совпадение двух независимых слоёв интереснее любого отдельно взятого score.


Но у этого кейса есть неприятная деталь — и мы её не прячем

В HTML connect-check того же клиента присутствовала проблема локальной среды: тест показывал 100% loss до Wi‑Fi gateway с некорректно определённым 0.0.0.0. Если бы нашей целью была эффектная история, эту строчку проще всего было бы не замечать, но для исследования это плохая привычка. Поэтому кейс нельзя честно назвать однозначным доказательством блокировки именно ТСПУ.

Он сильно поддерживает рабочую модель, потому что одновременно есть:

  • unexpected fail обычных ресурсов;
  • известный публичный egress;
  • silent SYN pattern;
  • очень высокий short-flow ratio;
  • низкий RST;
  • около 186 insides на одном NAT;
  • выраженный fan-out.

Но для чистого подтверждения нужен контрольный connect-check с Ethernet либо другой клиент на том же egress. Без таких оговорок очень быстро получается не исследование, а коллекция подтверждений заранее любимой теории.


А RST всё-таки бывает

После июньского PCAP и первых сентябрьских данных можно было легко уйти в другую крайность и решить, что RST нам вообще не интересен и всё всегда silent. Тоже нет. На другом публичном NAT в сегодняшнем срезе обнаружился совершенно иной профиль:

RST ≈ 43%
short3 ≈ 99%

То есть почти учебниковая RST-heavy картина. Конкретный адрес мы сознательно не публикуем, но сам факт важен:

на одной и той же операторской сети существуют как минимум два наблюдаемых класса деградации.

Условно:

Класс A — silent

syn_no_ack ↑
short3 ↑
RST low

Класс B — RST-heavy

RST ↑↑
short3 ↑↑

Это хорошо отрезвляет: искать один универсальный индикатор «ТСПУ=1» бессмысленно.


Масштаб: это не один странный NAT

Оставался вопрос, насколько сентябрьский кейс единичен. После того как детектор silent-drop перестроили с RST-first на syn_no_ack + short3, он начал находить похожие публичные egress по всей выборке.

На снимке 8 сентября около 16:40:

~65 публичных NAT

попадали в v_silent_drop_nat, и порядка:

~67 NAT

были помечены connect-check-ориентированным view как кандидаты на тихую деградацию.

Здесь очень важно слово «кандидаты»: порог пока исследовательский, а confirmed-фактуры у нас значительно меньше. Именно поэтому следующим этапом мы не собираемся «повышать чувствительность алерта», а хотим получить несколько независимых connect-check с разных NAT и сравнить их с контрольной группой.


Может ли «шумный» inside мешать соседям?

Это один из самых интересных вопросов всего проекта. Возьмём тот же CGNAT:

                       ┌── обычный абонент A
                       ├── обычный абонент B
                       ├── обычный абонент C
                       │
PUBLIC IPv4 ◄──────────┼── noisy inside
                       │    ├── много SYN
                       │    ├── сотни dst
                       │    ├── сотни ports
                       │    └── short flows
                       │
                       ├── обычный абонент Y
                       └── обычный абонент Z

Для любого внешнего механизма, который опирается на IP reputation, rate, поведенческий профиль или состояние большого числа сессий, всё это — один источник, и технически идея collateral damage на CGNAT совершенно реалистична (см. упомянутые выше данные Cloudflare). Но применительно именно к нашим событиям ТСПУ причинность пока не доказана.

Мы видим корреляцию:

аномальный NAT
+
noisy insides
+
неожиданные fail
+
характерный TCP-след

Чтобы сказать:

«вот этот конкретный inside своей активностью вызвал деградацию публичного адреса»

нужна повторяемая временная последовательность. Именно поэтому теперь основная единица анализа — не EVENT, а BEFORE → EVENT → AFTER.


BEFORE / EVENT / AFTER: как не перепутать причину со следствием

Высокий SYN может означать две противоположные вещи.

Вариант 1. SYN был причиной аномального профиля

Например, устройство действительно:

  • сканирует сеть;
  • перебирает сервисы;
  • заражено;
  • создаёт огромное количество новых соединений.

Вариант 2. SYN уже является следствием проблемы

Соединения перестали устанавливаться, приложения начинают ретраи, и количество SYN растёт после начала деградации. Если смотреть только на EVENT, эти два сценария легко перепутать.

Поэтому каждое подтверждённое внешним тестом событие теперь режем на три окна:

        BEFORE             EVENT              AFTER
───────────────┬─────────────────────┬────────────────
   до fail     │ connect-check fail  │ после события
───────────────┴─────────────────────┴────────────────

Для каждого окна считаем:

flows_sec
syn_sec
syn_no_ack_pct
rst_pct
short3_pct
uniq_dst
uniq_dst_port
uniq_inside
tcp443
udp443
scan_score
amp_score
p2p_like

Самое интересное окно — BEFORE. EVENT показывает, как выглядит уже пострадавший egress, а BEFORE потенциально позволяет найти, что происходило до того, как клиент заметил проблему.


Почему здесь интересны 5–15 минут

Ширину этого окна нам фактически подсказал уже упомянутый ориентир полного цикла из открытой реконструкции. Мы не знаем, совпадает ли этот интервал с конкретными реальными событиями нашей сети в 2026 году, но как исследовательская гипотеза он очень удобен.

Если в будущем несколько независимых кейсов будут выглядеть так:

T-20m  на NAT появляется необычный fan-out
T-15m  резко растут новые сессии
T-10m  выделяется один noisy inside
T0     expected_block=0 начинает FAIL
T+...  профиль меняется или доступность восстанавливается

это будет уже гораздо сильнее простой одновременной корреляции. Если такой последовательности не окажется — значит, гипотеза не выдержала проверку. Тоже полезный результат.


Что именно считаем «шумным» профилем

Мы постепенно пришли к трём основным осям.

1. Порты

uniq_dst_port

Много разных destination ports за короткий период может быть признаком port-scan, сервисного перебора или просто очень необычного приложения. Сам по себе показатель слабый, но вместе с высоким SYN и short-flow ratio уже интереснее.

2. Destination

uniq_dst
uniq_dst_pair

Насколько широко источник размазывает соединения по Интернету. Современный браузер, CDN и P2P могут давать большой fan-out совершенно легально, поэтому контекст обязателен.

3. Незавершённые TCP-сессии

syn_no_ack_pct
short3_pct

Особенно интересна комбинация:

syn_no_ack high
short3 high
RST low

Именно она лучше всего соответствует нашему наблюдаемому silent-классу.

Дополнительные оси:

  • flows_sec;
  • tcp443 / udp443;
  • amp-порты вроде 53/123/1900/11211;
  • P2P dampen;
  • отклонение от собственного baseline.

Baseline важнее абсолютного числа

Последняя ось из списка на практике оказалась главной. Допустим, мы видим:

100 SYN flows/sec

Само это число ни о чём не говорит: для офиса на десять компьютеров подозрительно, а для большого CGNAT, хостинга или игрового сегмента — возможно, совершенно нормально. Поэтому абсолютные пороги остаются только первым слоем, а для каждого объекта полезнее хранить собственную историю:

average
median
p95
p99
max
stddev

И смотреть не только:

сейчас = 100

а:

сейчас = 100
обычно = 8
p99 = 17

Вот это уже настоящая аномалия конкретного объекта.


Почему мы пока не делаем auto-ban

Когда на графике красиво видно port-scan-ish, очень хочется сразу автоматизировать «лечение». Мы этого сознательно не делаем, потому что под тем же профилем могут скрываться:

  • легитимный vulnerability scanner клиента;
  • мониторинг;
  • Kubernetes;
  • P2P;
  • игровой launcher;
  • backup;
  • CDN;
  • корпоративный proxy;
  • заражённый хост.

NetFlow-эвристика должна сначала привести человека к правильному месту расследования, а не сама вынести приговор. Поэтому сейчас workflow выглядит так:

NetFlow
   ↓
метрики + score
   ↓
публичный NAT
   ↓
вкладчики inside
   ↓
hourly digest / Grafana
   ↓
человек
   ↓
connect-check / PCAP / контакт с абонентом

Это скорее инструмент NOC и security operations, чем автоматическая IDS.


Отдельно пришлось мониторить сам мониторинг

Ещё одна прекрасная возможность обмануть себя — потерять NetFlow на collector и принять дырку в данных за сетевое событие. На первом варианте установки ingest, ClickHouse, Grafana и остальные компоненты жили почти вместе; после подключения нескольких реальных exporters нагрузка быстро стала неприятной, так что роли пришлось разнести и добавить disk spool.

Теперь отдельно смотрим:

  • состояние GoFlow2;
  • UDP receive;
  • exporter sequence gaps;
  • задержку ingest;
  • ClickHouse inserts;
  • CPU/RAM/disk.

Правило простое:

Если у коллектора sequence gap, сначала чините коллектор. ТСПУ подождёт.


Что получилось в Grafana

Вместо одного гигантского дашборда мы разделили задачи.

Почему этому NAT плохо?

Публичный NAT как ключ:

silent drop?
RST?
fan-out?
P2P?
сколько inside?
что происходило до события?

Scanners

Port-scan-ish и host-scan-ish профили.

Amplifiers

Активность по типичным UDP amplification ports.

Malware-ish

Долго живущие или регулярно повторяющиеся аномальные inside. Это именно эвристика, а не диагноз «найден вирус».

Infra

Здоровье самого NetFlow-контура.

Самой полезной частью в итоге оказался не красивый общий score, а возможность провалиться:

problem NAT
   ↓
insides behind NAT
   ↓
кто дал SYN?
   ↓
кто дал fan-out?
   ↓
кто дал port sweep?

То есть перейти от «плохо всему адресу» к конкретным кандидатам внутри CGNAT.


Июнь 2026 вообще был показательным

Наш локальный Wireshark-скриншот не существовал в вакууме. В июне публично обсуждались проблемы с доступом к российским облачным сервисам: Habr, ссылаясь на сообщения отрасли и публикации РБК, писал о подтверждённых сбоях у ряда российских хостеров и о том, что решения могли приниматься по косвенным признакам зашифрованных соединений — в том числе диапазонам IP и частоте подключений.

Источник: Habr — «РКН устроил проблемы с доступом российским облачным сервисам и сайтам».

Мы не используем эту публикацию как доказательство конкретно нашего июньского дампа. Но она важна как фон: collateral damage от поведенческих и IP-ориентированных механизмов в 2026 году уже наблюдался публично далеко не только нами.


QUIC тоже нельзя забывать

Современный HTTPS — это уже не только TCP/443: браузеры и приложения активно используют QUIC на UDP/443, и если UDP/443 становится недоступен или деградирует, клиент может откатиться на TCP. Поэтому мы отдельно смотрим:

udp443

tcp443

udp443 / tcp443

Пока данных недостаточно, чтобы считать это сильным индикатором. Но резкое изменение отношения на проблемном NAT вполне может оказаться полезным дополнительным признаком.


NetFlow, PCAP и connect-check отвечают на разные вопросы

В результате сложилась довольно удобная трёхслойная модель.

NetFlow

Показывает, где среди тысяч абонентов вообще стоит искать проблему.

connect-check

Показывает, что в этот момент реально видел клиент и какие классы сервисов перестали работать.

PCAP

Показывает, что физически происходило с конкретными сессиями.

Условно:

NetFlow
   "кажется, проблема вот на этом egress"
              │
              ▼
connect-check
   "да, здесь в 15:11 уже падают unexpected ресурсы"
              │
              ▼
PCAP
   "а теперь посмотрим конкретный handshake"

Июньский Wireshark и сентябрьский NetFlow как раз замыкают эту историю.


Что мы уже можем говорить достаточно уверенно

1. «Пинг есть» больше не является достаточной проверкой доступности

Частичная TCP/TLS-деградация прекрасно сосуществует с живым ICMP, DNS и частью установленных соединений.

2. NetFlow способен показать след такой деградации

Не внутреннее решение DPI, а статистический результат на edge.

3. На нашей площадке silent SYN-drop оказался важнее RST

Рабочей оказалась silent-комбинация, описанная выше. Но RST-heavy кейсы тоже существуют, поэтому единственного fingerprint нет.

4. Для CGNAT главная сущность — публичный egress

Inside нужен для attribution, а не как первичный ключ внешнего события.

5. P2P обязательно нужно отделять от сканирования

Иначе top offenders очень быстро превращаются в «список людей с торрентами».

6. Калиброваться надо от внешней фактуры

connect-check expected_block=0 FAIL с известным egress полезнее любого самостоятельно придуманного anomaly score.

7. Самое интересное — BEFORE

Именно поведение перед событием может когда-нибудь дать нам предиктивный сигнал.


Чего мы пока не можем утверждать

Вот здесь лучше быть скучными. Мы не знаем машинного порога вида:

N SYN = блок

Мы не можем по одному NetFlow доказать, какое именно правило сработало внутри ТСПУ, и не можем утверждать, что каждый silent_syn_drop — это ТСПУ: причиной могут быть и другие middlebox, серверная сторона, маршрутизация, локальные проблемы клиента и ошибки измерительного контура.

Мы пока не доказали причинную связь:

noisy inside → решение внешнего фильтра → collateral для всего CGNAT.

Она выглядит правдоподобно и хорошо рифмуется с общей проблемой shared-IP reputation, но для конкретного ТСПУ нам нужны десятки повторяемых labeled events. И мы специально не называем «малварью» любой высокий scan_score — это только кандидат для расследования.


Что будем делать дальше

Сейчас ценнее не ещё десять панелей в Grafana, а фактура. Нужны разные классы реальных событий:

  1. Silent drop — описанный выше класс.
  2. RST-heavy — чтобы понять другой тип поведения.
  3. P2P control — высокий fan-out без деградации.
  4. Настоящие scanners — для отделения от P2P.
  5. Чистые CGNAT с сопоставимой нагрузкой, где connect-check полностью здоров.

Для каждого подтверждённого случая:

когда началось
какой public NAT
что fail
что OK
какие insides сидели за NAT
что происходило BEFORE
что происходило EVENT
что изменилось AFTER

После нескольких десятков таких кейсов уже можно считать распределения и квантили, а не спорить о красивых порогах вручную. Например, сравнить:

P(degradation | syn_no_ack, fanout, ports, baseline_delta)

и понять, существует ли вообще устойчивый предиктивный профиль. Если существует — получим ранний сигнал для NOC. Если нет — тоже прекрасно: значит, ещё одна красивая гипотеза умерла от данных, как и положено.


Возможно, главный результат проекта вообще не про ТСПУ

Начиналось всё с попытки понять странную фильтрацию. Но даже если завтра убрать из системы слово «ТСПУ», контур всё равно остаётся полезным. Он уже позволяет видеть:

  • аномальные публичные NAT;
  • массовые незавершённые TCP-сессии;
  • scanners;
  • amp-port activity;
  • P2P;
  • необычный fan-out;
  • noisy insides внутри CGNAT;
  • отклонение от собственного baseline;
  • момент, когда пользовательская доступность расходится с зелёным ICMP.

То есть из узкой попытки разобраться с одним странным сетевым эффектом получился довольно универсальный инструмент эксплуатации CGNAT.


Вместо заключения

В июне мы смотрели на Wireshark и видели повторные SYN к :443 среди совершенно живого остального трафика. В сентябре тот же класс симптомов появился уже на операторской статистике:

syn_no_ack
short flows
fan-out
публичный NAT
сотни insides

Потом рядом нашёлся и другой класс — RST-heavy. То есть простого ответа вида:

TSPU_BLOCKED = true

скорее всего, никогда и не будет. Зато можно сделать кое-что полезнее — не гадать по жалобе «опять ТСПУ или у клиента роутер завис», а собрать несколько независимых слоёв:

реальный fail клиента
+
известный public egress
+
NetFlow до/во время/после
+
вклад конкретных insides
+
при необходимости PCAP

По отдельности каждый признак слабый. Вместе они превращают фразу:

«кажется, Интернет опять как-то странно работает»

в вполне измеримое сетевое событие. А с измеримыми событиями уже можно работать.


Ссылки

Предыдущая часть истории — «Две недели “интернета нет” при зелёных пингах»:

https://articles.clr58.ru/dve-nedeli-net-interneta

connect-check:

https://github.com/cooler58/connect-check

Открытая реконструкция архитектуры ТСПУ:

https://github.com/DanielLavrushin/tspu-docs

Про send RST off:

https://github.com/DanielLavrushin/tspu-docs/blob/main/chapters/17.md

Про двухстадийное формирование списков:

https://github.com/DanielLavrushin/tspu-docs/blob/main/chapters/08.md

Cloudflare про collateral effect CGNAT:

https://blog.cloudflare.com/detecting-cgn-to-reduce-collateral-damage/

Habr про проблемы российских облачных сервисов в июне 2026:

https://habr.com/ru/amp/publications/1046025/


Дисклеймер. Материал описывает эксплуатационные наблюдения на стороне оператора связи и анализ доступных сетевых метаданных. Он не является официальным описанием ТСПУ, инструкцией по обходу ограничений или доказательством того, что конкретное сетевое событие вызвано конкретным правилом Роскомнадзора. Открытые материалы по архитектуре ТСПУ используются как источник гипотез и требуют соответствующей оговорки. Аномальный NetFlow-профиль сам по себе не является основанием обвинять или автоматически блокировать абонента.

#network #monitoring #netflow
Обложка

Цикл «Не светим лишнего». Выпуск 6.

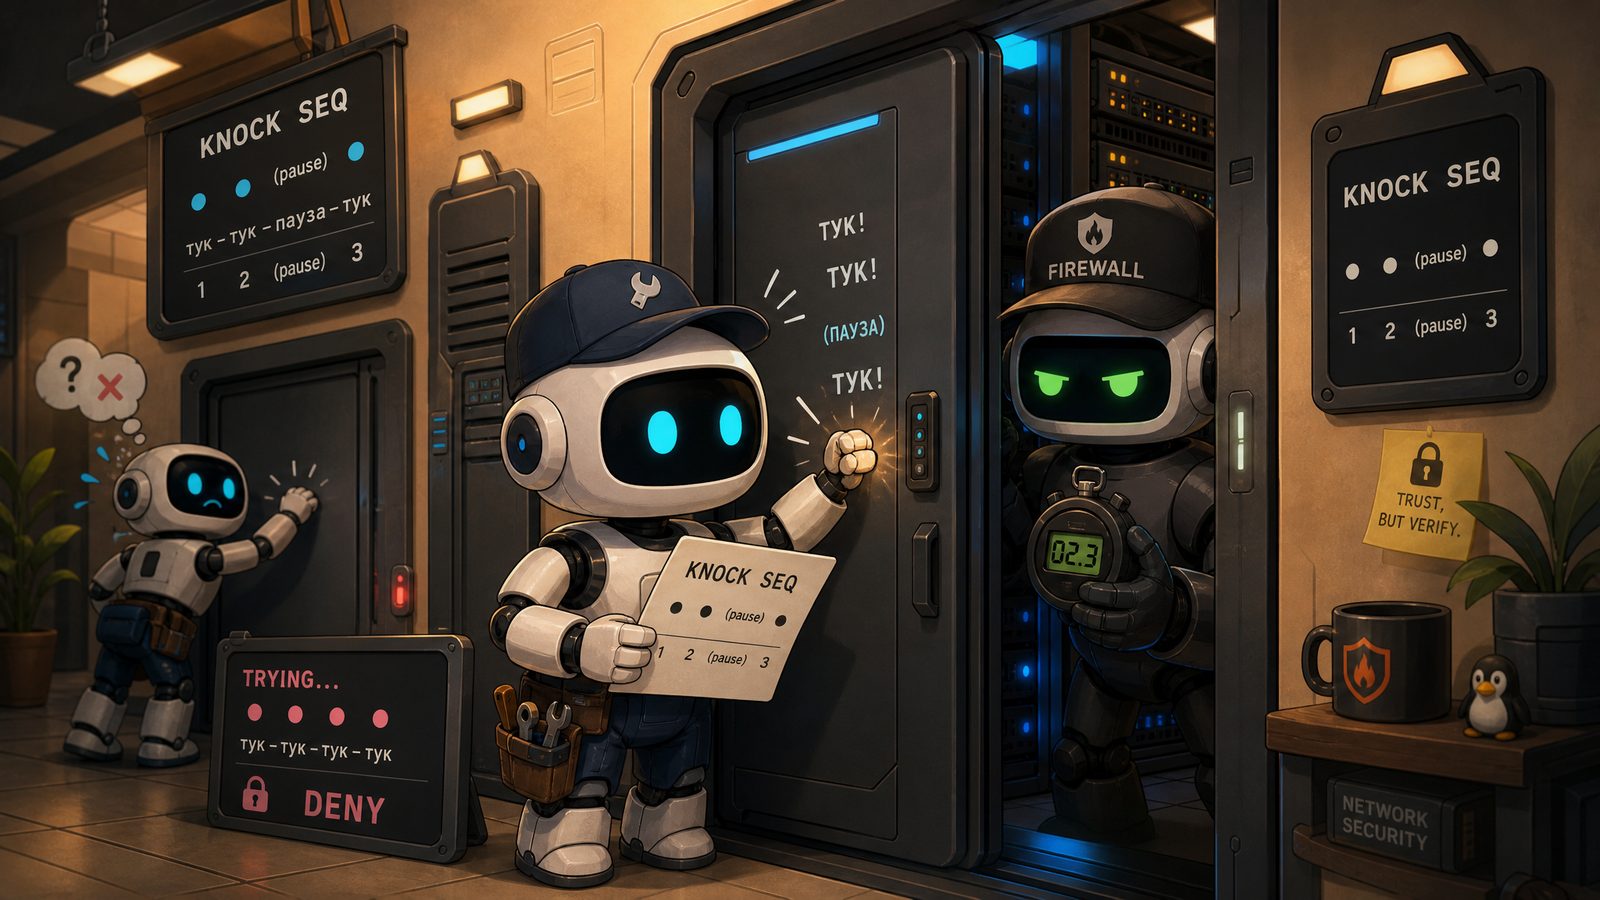
Представим SSH, который снаружи вообще не отвечает. Порт закрыт firewall, баннера нет, перебирать пароль некуда. Но если клиент сначала обратится к порту 888, потом к 555 и затем к 222, его IP на полчаса попадёт в список secured, и SSH откроется.

Это и есть классический port knocking.

Как собирается последовательность

На первом шаге firewall ловит пакет к закрытому порту и добавляет источник в промежуточный список на 20–30 секунд. Второй шаг срабатывает только для адресов из первого списка и переносит их дальше. Последний шаг добавляет IP в рабочий allow-list с более длинным timeout.

Сервис на «стучащих» портах слушать не обязан. Firewall просто замечает попытки соединения.

Последовательность может использовать TCP, UDP или ICMP. В ICMP-варианте различают, например, размеры Echo Request или другие доступные признаки пакета. Это бывает удобно в сетях, где исходящие TCP/UDP ограничены, но ping проходит. Правда, бывает и наоборот: ICMP режут первым.

Что knocking даёт

Он хорошо скрывает поверхность атаки от обычного сканирования. Пока последовательность не выполнена, SSH, WinBox или служебный NAT выглядят закрытыми. Боты не видят форму входа и не начинают перебор.

Реализовать базовую схему можно прямо на MikroTik без отдельного сервера. Клиенту иногда достаточно нескольких команд nc или ping. Для аварийного доступа это может быть полезным резервом.

Чего knocking не даёт

Обычная последовательность портов не шифруется. Человек, который видит трафик, может её повторить. Даже без прослушивания секрет из трёх коротких портов теоретически перебирается, если нет ограничений частоты и защитных списков.

Firewall опять же открывает внешний IP. За общим NAT правильный стук одного инженера может открыть путь соседнему клиенту того же NAT. Собственная авторизация SSH или веб-системы остаётся обязательной.

Плюсы

  • сервис не виден обычному сканеру;
  • минимальная серверная инфраструктура;
  • любые защищаемые протоколы после открытия;
  • короткий timeout автоматически закрывает доступ;
  • можно использовать как аварийный канал;
  • легко сочетать с обычным allow-list.

Минусы

  • последовательность можно подсмотреть и воспроизвести;
  • неудобство на телефоне и чужом компьютере;
  • NAT объединяет пользователей;
  • ICMP/UDP могут фильтроваться;
  • диагностика выглядит странно: правильные пакеты специально получают drop;
  • состояние последовательности можно сбить или зашумить.

Где можно больно ошибиться

Сделать короткий секрет и длинное открытие. Последовательность из трёх известных портов с доступом на сутки — слабая конструкция.

Не сбрасывать неправильную последовательность. Если промежуточные списки слишком терпеливы, порты можно набрать вразнобой.

Открыть управление всем сервисам. Последний knock должен включать конкретную группу, а не общий accept from secured to any.

Считать knocking заменой пароля. Он уменьшает видимость сервиса, но не делает дырявый SSH безопасным и не заменяет ключи.

Забыть порядок firewall. Правила knocking должны увидеть пакет раньше финального drop, а рабочий allow — стоять в правильной цепочке input или forward.

Не ограничить перебор. Источники, которые постоянно стучат по шагам в неправильном порядке, можно временно отправлять в отдельный blacklist.

Когда применять

Port knocking хорош как лёгкий дополнительный слой для небольшой группы администраторов, особенно если отдельный портал пока избыточен. Для массового пользовательского доступа он неудобен. Для более сильной версии той же идеи существует Single Packet Authorization: один криптографически защищённый пакет вместо наблюдаемой последовательности.

Ранее в цикле

Документация и источники

#network

Обложка

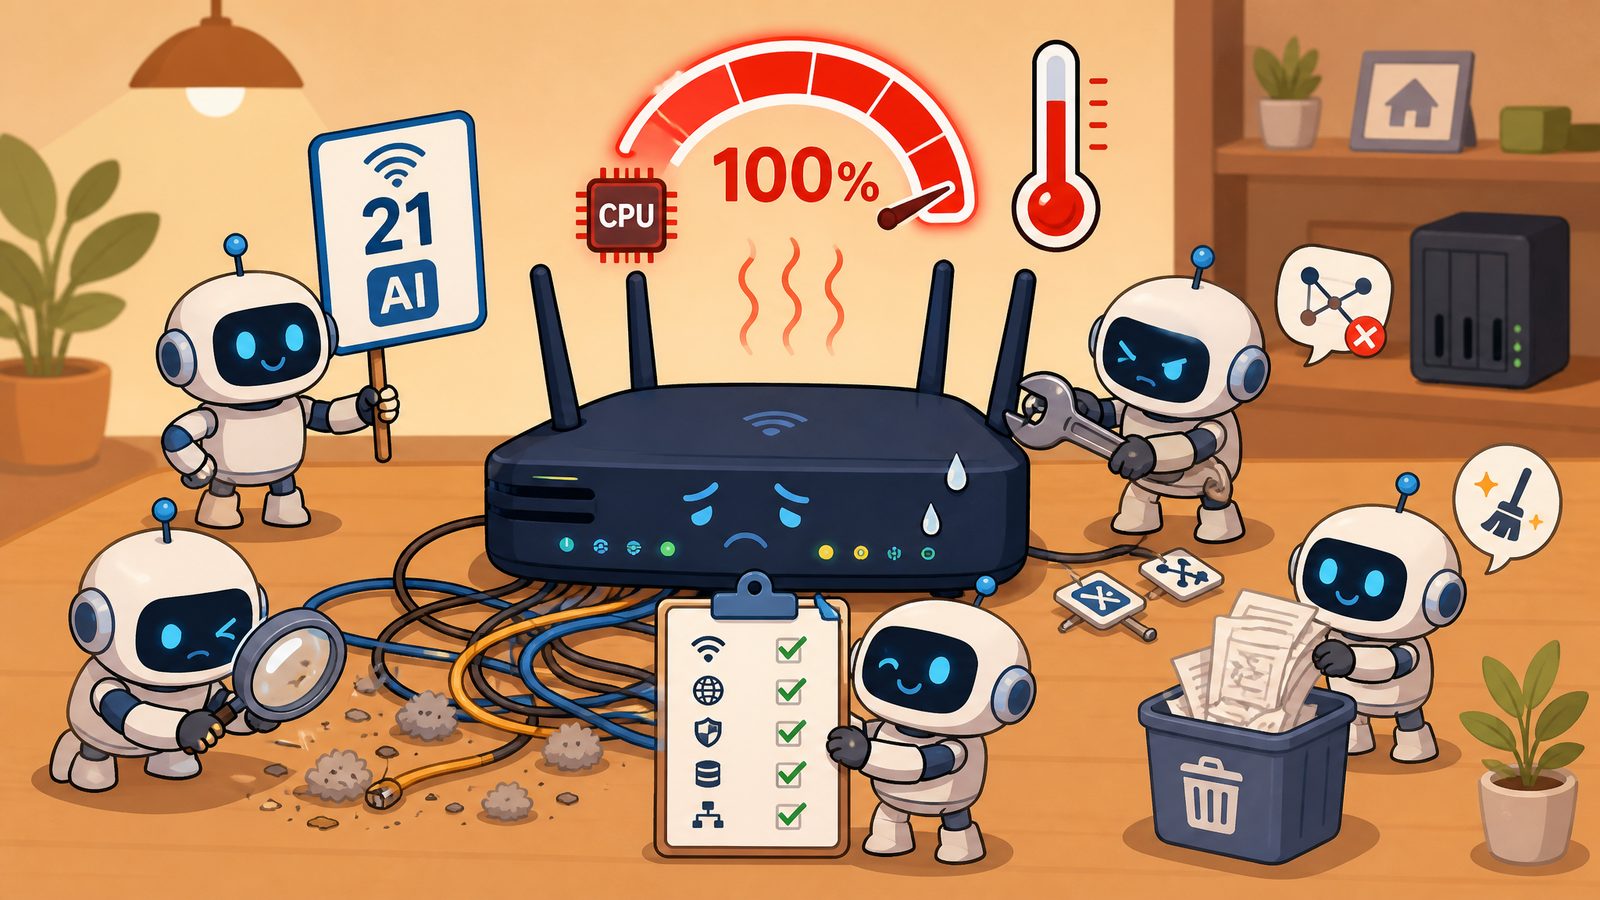
Домашний MikroTik hAP ac lite — MIPS 650 МГц, 64 МБ памяти — начал задыхаться: CPU 99–100%, свободной оперативки 17 МБ. Классический совет в такой ситуации — «купи нормальный роутер». Но прежде чем тратить деньги, я решил разобраться, что он вообще делает.

Сначала проверил сам

Прогнал конфиг: SNMP открыт наружу, RDP проброшен в интернет, слабый Wi-Fi-пароль, скрипт, тянущий код с GitHub. Почистил всё это — CPU стоит колом. Значит, проблема глубже, и одним взглядом её не увидеть.

Подключил второй мозг

Отдал те же конфиги субагенту — отдельной сессии ИИ. И он нашёл то, что я проморгал: 12 мёртвых маршрутов с gateway 10.100.0.2 — это собственный адрес роутера в L2TP-туннеле. Роутер гнал трафик «в самого себя», маршруты висели в статусе INACTIVE, а рабочие копии тех же сетей шли через туннель до зарубежного VPS (10.100.10.10).

Одна команда:

/ip route remove [find gateway=10.100.0.2]

Минус 12 маршрутов — трафик пошёл по живому пути. Минута работы. Вывод: два мозга видят разное, и на серьёзных вещах второй проход не помешает.

Ролевой аудит: три субагента, три модели

Один субагент помог — я усилил подход. Три роли, три разные модели, одни и те же свежие конфиги:

  • сетевой инженер — DeepSeek Flash;
  • безопасник — GPT-4o mini;
  • админ — DeepSeek Pro.

Каждый искал своё. Вот что набралось:

  • DHCP-клиент по умолчанию висит на WAN рядом с PPPoE. Если провайдер выдаст адрес, дефолт-маршрут с distance 1 перебьёт PPPoE (distance 2) и сломает NAT. Мина замедленного действия.
  • Мёртвый маршрут до лабораторной сети через шлюз, которого нет ни в одной connected-сети.
  • ~110 маршрутов-дублей от старых дампов — дедупликация похудела таблицу на 25–30%.
  • Мусор через VPN: multicast, RFC1918, широкие /8 и /12 через туннель с MTU 1400.
  • BFD включён на всех интерфейсах при полном отсутствии BGP/OSPF — hello-пакеты впустую жгут CPU.
  • YouTube address-list на 496 записей, обновляется каждые 12 часов и не используется ни одним правилом.
  • DHCP lease-time 10 минут — клиенты перерегистрируются каждые 5 минут, лишний broadcast на слабом MIPS.
  • Проброс RDP целится в динамический DHCP-лиз — адрес сменится, и проброс молча уедет на чужой хост.
  • Скрипт обновления списка с правами reboot/password — многовато для «обновить список».
  • Авто-SMB на роутере — лишний вектор в LAN.

Итого +10 находок. Три проверил живьём — всё подтвердилось.

Экзамен: 21 модель против одного конфига

Захотелось честной проверки: всем моделям — один и тот же конфиг (14,5 КБ) и один промпт: опиши, найди до 5 проблем, скажи, что пинговать. Потом сверка с реальными пингами.

Кто блеснул:

  • GPT-5 — единственный, кто с нуля нашёл DHCP-клиент на WAN (главную находку прошлого аудита);
  • qwen3-coder — указал на мёртвый маршрут и предложил пинговать именно его;
  • gemma3 — лучшая локальная: 4,2K токенов разбора бесплатно;
  • qwen2.5:14b — заметил check-gateway=none на куче маршрутов: роутер не проверяет шлюзы, поэтому мёртвые висят вечно.

Кто облажался:

  • три thinking-модели (qwen3:30b, qwen3-vl:8b, deepseek-r1:14b) вернули пустой ответ — весь лимит ушёл в скрытые размышления. С max_tokens=16000 все трое заговорили;
  • deepseek-coder:6.7b выдумал RIPv2, которого в конфиге нет, и выдал учебник;
  • qwen2.5:7b придумал проблему с ether3/ether4 — а они в bridge;
  • llama3.1:8b упал с ошибкой 500, не переварив конфиг.

Пинговая сверка подтвердила подозрения: интернет, дом, офис и LAN отвечают, а туннельные адреса 10.100.0.2 и 10.100.50.2 дают 100% потерь.

Весь эксперимент обошёлся в $0.23 (148K токенов промпта + 70K вывода). Локальные модели сожгли 91K дневной квоты, но денег — ноль.

Чистка

Собрал всё и прошёлся метлой: BGP/OSPF — off (мёртвые, но жрали CPU), BFD — off, мёртвые и дублирующиеся маршруты удалены, OpenVPN-сервер снят, YouTube-лист вычищен вместе со скриптом.

CPU упал с 99% до 15%. Память вдохнула. Роутер на 64 МБ ожил и замены не просит.

Выводы

Прежде чем покупать железо — почистите конфиг. Часто роутер не слабый, а просто завален мусором, копившимся годами: VPN-хабы, старые дампы, скрипты «на всякий случай».

И второе. Я один пропустил мёртвые маршруты — субагент нашёл. Три роли дали ещё +10 находок. 21 модель подтвердила главное и подсветила закономерности. Ни один ИИ не увидел всего, но вместе с живой проверкой они закрыли почти все реальные проблемы. Теперь это мой стандарт: роли × модели × живая проверка.

#network

Обложка

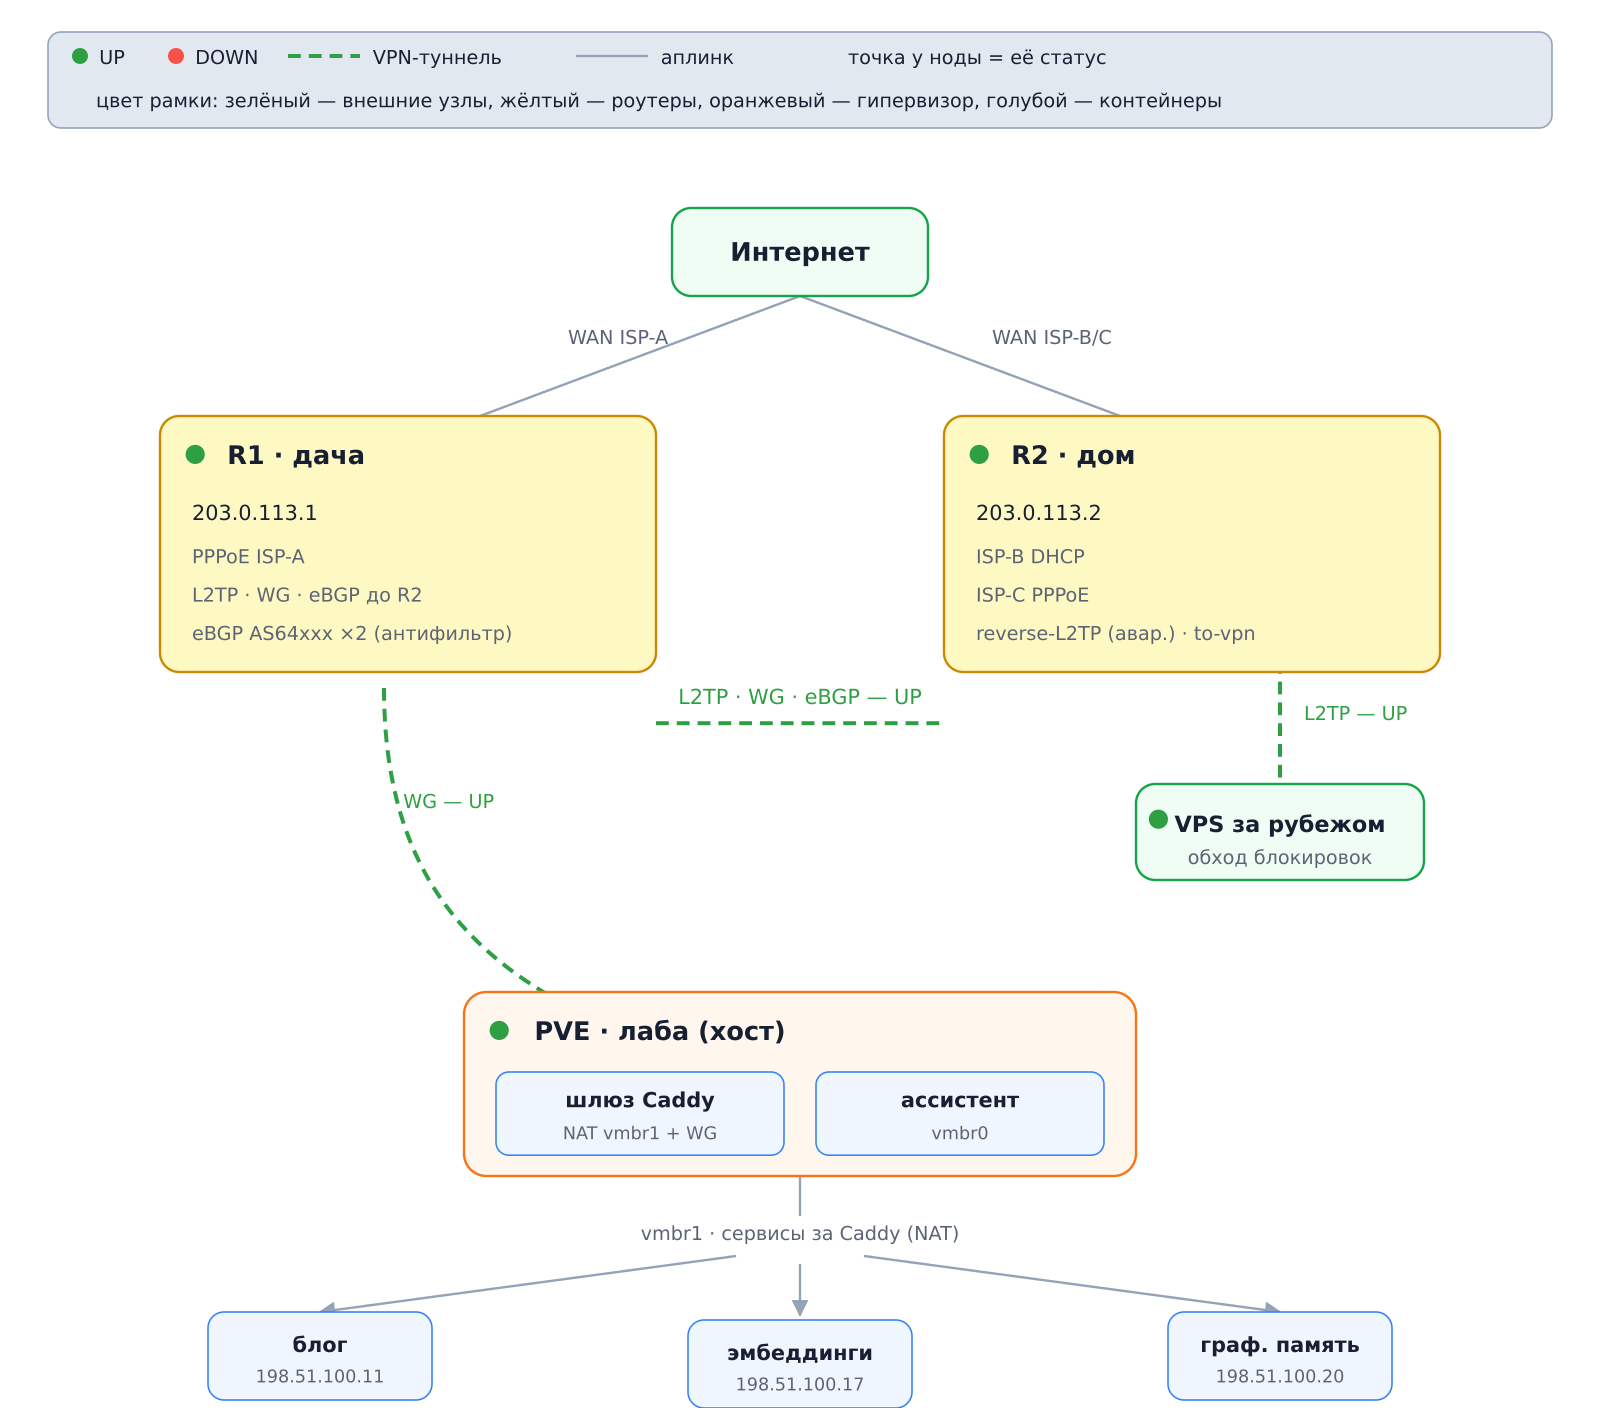
Давно хотел видеть всю инфраструктуру одним взглядом: две площадки, роутеры в разных концах города, туннели между ними, контейнеры на двух внутренних сетях, кто за каким NAT сидит и кто сейчас лежит. Не «список устройств в Wi-Fi», а именно схему — чтобы по ней сразу читалось, что через что ходит.

Рассказываю, как выбирал инструмент, что в итоге поставил и как оживил карту статусами туннелей.

Муки выбора

Сначала казалось, что задача простая — «нарисовать сеть», а инструментов вон сколько. Перебрал пять кандидатов, и у всех нашлось одно общее ограничение: это discovery-инструменты. Они сканируют один сегмент (обычно LAN) и рисуют «что болтается в broadcast domain». А моя топология — инфраструктурная: связи между площадками, туннели поверх интернета, контейнеры за NAT. Сканер за свой broadcast domain не заглянет в принципе.

NetAlertX (~7k звёзд). Один контейнер, лёгкий, красивые карточки устройств, online/offline, порты. Но карта древовидная: родитель → дети. Туннели рисует неидеально, VLAN — подписью на ребре. Вердикт: отличный «кто висит в домашней сети», но схема лабы — нет.

NetPulse (1 звезда, 8 коммитов). PHP + SQLite, ICMP/TCP/SNMP, ручное рисование связей, пунктиры, цвета. По духу — то, что надо, но проект сырой, наружу такое не выставишь. Вердикт: «рисовалка с пингами», которую за вечер напишешь сам.

Scanopy (~5.7k звёзд). L2/L3, VLAN, порты, контейнеры, живая карта. Но три контейнера + PostgreSQL + привилегированный сканер. Для домашней лабы тяжело и привилегированно, и снова L2-центричен — межсайтовые туннели не покажет.

MikroTik-NetMap (0 звёзд, но живой). Веб-альтернатива The Dude: сам находит соседей роутеров по MNDP/LLDP, dotted-линии для VPN, анимация трафика. Но рисует только то, что роутеры видят в L2. Мои контейнеры и туннели между площадками автоматически не покажет.

Homelable (3179⭐, MIT, обновляется чуть ли не ежедневно). – Импорт Proxmox VE — сам вытаскивает контейнеры и VM – Свободный канвас: зоны-сети, вложенность (хост → контейнеры внутри), ручные линки любого типа – Живые статусы нод: ping/TCP/HTTP – Экспорт PNG/SVG, read-only Live View, MCP-сервер для ИИ-ассистентов – Docker-образ или bare-metal скрипт — влезает в обычный LXC

Вердикт: единственный, кто закрывает именно мою задачу — произвольная схема + живые статусы + импорт уже существующей инфраструктуры.

Почему Homelable

  1. Моя топология — граф: 2 площадки, полтора десятка контейнеров, 2 внутренних сети, 3 типа туннелей между роутерами. Нужен свободный канвас с ручными связями, а не авто-дерево.
  2. Импорт Proxmox даёт 80% наполнения бесплатно — не надо вбивать контейнеры руками.
  3. Живые статусы — схема одновременно работает мониторингом.
  4. Лёгкий: frontend + backend, живёт в LXC рядом с остальными сервисами.
  5. Экспорт PNG — картинку можно вставить в статью.

Точный путь установки

Шаг 1. Контейнер

Свежий LXC на Proxmox (ubuntu, unprivileged, nesting=1 — docker внутри требует):

pct create 116 local:vztmpl/ubuntu-26.04-standard_26.04-1_amd64.tar.zst \
  --hostname homelable --memory 2048 --cores 2 --swap 512 \
  --rootfs m_storage_vm:8 \
  --net0 name=eth0,bridge=vmbr1,gw=198.51.100.1,ip=198.51.100.24/24,type=veth \
  --nameserver 203.0.113.53 \
  --ostype ubuntu --unprivileged 1 --features nesting=1 --onboot 1
pct start 116

Грабли: сначала взял 198.51.100.22 — а он уже занят другим сервисом. Симптом: HTTP 000 флапает (ARP-конфликт — пакеты уходят то туда, то сюда). Перед выдачей IP — проверять занятость pct list + pct config <id> | grep net0.

Шаг 2. Docker

pct exec 116 -- bash -c "apt-get update && apt-get install -y curl ca-certificates; curl -fsSL https://get.docker.com | sh"

Шаг 3. Homelable (prebuilt-образы, без сборки)

cd /opt
curl -fsSLO https://raw.githubusercontent.com/Pouzor/homelable/main/docker-compose.prebuilt.yml
curl -fsSL https://raw.githubusercontent.com/Pouzor/homelable/main/.env.example -o .env
# SECRET_KEY = secrets.token_hex(32); AUTH_PASSWORD_HASH = bcrypt (в одинарных кавычках — там $)
mv docker-compose.prebuilt.yml docker-compose.yml
docker compose up -d
# frontend :3000, backend :8000, mcp :8001

Шаг 4. Read-only токен Proxmox для импорта

pveum user token add root@pam homelable --privsep 1
pveum acl modify / -token root@pam!homelable -roles PVEAuditor

Тонкость PVE 9.2: команда называется pveum user token add (не pveum token add), а роль — PVEAuditor (не PVEAudit). Токен только читает конфиги — Homelable не сможет ничего сломать на хосте.

Шаг 5. Импорт топологии

Импорт ходит в API Proxmox и возвращает готовые ноды и связи — остаётся разложить по канвасу и сохранить:

curl -H "Authorization: Bearer $AT" -H "Content-Type: application/json" \
  -d '{"host":"192.0.2.10","port":8006,"token_id":"root@pam!homelable","token_secret":"...","verify_tls":false}' \
  http://198.51.100.24:3000/api/v1/proxmox/import
# раскладка + POST /api/v1/canvas/save {nodes:[...], edges:[...]}

Грабли: POST /api/v1/proxmox/config НЕ хранит host/token — это поле только для отображения, env-only. Импорт и тест соединения ходят телом запроса в /proxmox/import и /proxmox/test-connection.

Шаг 6. Доступ

Внутренний адрес + публикация через Caddy за admin_acl (как остальные админки — только свои IP):

homelable.example {
	header {
		-Server
	}
	import admin_acl 198.51.100.24:3000
	log { output file /var/log/caddy/access.log }
}

Раскладка: сетевая, а не импортная

Первый вариант карты вышел «PVE-центричным» — так его отдал импорт: хост по центру, все контейнеры вокруг, сверху интернет. Владелец лабы глянул и сказал: «ты не прав, у нас всё за Caddy». И ведь верно — импорт дал физику, а не логику трафика.

Пример живой карты

Перерисовал правильно, как трафик реально ходит:

  • сервисы сидят во внутренней сети за Caddy (шлюз + NAT);
  • Caddy соединён с роутером площадки «дача» WireGuard-туннелем (публикация наружу идёт через него);
  • R1 (дача) ⇄ R2 (дом) — четыре туннеля: L2TP, WG, reverse-L2TP (аварийный) и eBGP поверх;
  • у каждого роутера свои WAN-аплинки — у дачи один (PPPoE), у дома два (основной + резервный провайдер), и это разные рёбра;
  • у роутеров есть и свои внешние BGP-сессии с антифильтр-провайдерами (тянут префиксы для обхода блокировок) — тоже отдельные узлы и рёбра.

Живые статусы

Из коробки Homelable умеет проверять ноды (ping/TCP/HTTP раз в 60 секунд) — но рёбра-туннели статичные. Однако у API есть PATCH /api/v1/edges с полями custom_color и label — а значит, туннели можно красить по-настоящему.

Написал опросчик (cron, раз в минуту): ходит по SSH на оба MikroTik, снимает:

  • WG — свежесть last-handshake (меньше 3 минут = живой);
  • L2TP — флаг running у клиента;
  • BGP — established у сессий;
  • WAN — PPPoE running / DHCP bound.

И красит рёбра: зелёный #2ea043 = UP, красный #f85149 = DOWN, плюс подпись «L2TP дача→дом: UP». PATCH летит только при смене статуса, чтобы не дёргать API впустую.

Пара граблей из этой обвязки:

  • RouterOS print — колоночный, и это не detail. Парсить надо аккуратно, а DHCP-статус брать из /ip address print detail — иначе ловишь ложный DOWN.
  • WG last-handshake старше минуты RouterOS показывает как 1m2s, а не 62s. Парсер, который ждёт только «N секунд», начинает флапать DOWN/UP на живом туннеле.

Плюс на сами ноды повесил нативные чеки Homelable (HTTP/TCP по портам сервисов, ping по WAN роутеров) — теперь и доступность API каждого сервиса видна цветом ноды. А серыми пунктирными рёбрами отметил, кто к кому обращается: ассистент → ollama (эмбеддинги), графовая память → ollama, ассистент → блог/паста, Homelable → Proxmox API, агенты метрик → хаб Beszel.

Итог

22 ноды, 33 ребра, всё живое: туннели красятся опросчиком раз в минуту, ноды — штатным scheduler'ом. Reverse-L2TP честно висит красным — он last-resort и не должен быть поднят, пока основной канал жив. Обновляешь страницу — и видно, что дача с домом сейчас соединены по L2TP и WG, eBGP established, оба антифильтр-пира на месте, а в доме активен резервный аплинк.

Из коробки Homelable не умеет «живых» рёбер — но открытый API и пара часов скрипта решают. Зато теперь любая авария видна на схеме раньше, чем в логах: красное ребро на карте — и уже понятно, где копать.

Бонус: скрипт опроса роутеров

Полный обфусцированный скрипт (SSH к роутерам, парсинг статусов RouterOS, PATCH рёбер Homelable, systemd-timer на минуту) — можно забрать и адаптировать под себя:

https://paste.clr58.ru/mikrotik-tunnel-status.py

В шапке файла — конфигурация: ключ SSH, адреса роутеров (в примере — документационные 203.0.113.x), URL Homelable и словарь рёбер с именами ваших интерфейсов RouterOS.

#selfhosting #network #monitoring

Обложка

Цикл «Виды связности и SDN», часть 4. Предыдущая часть: «L2-overlay: VLAN, VXLAN, Geneve и EVPN».

Ось: уровень — L3.

L3-связность не пытается убедить серверы из разных стоек, что они подключены к одному коммутатору. У каждой части инфраструктуры есть собственная сеть, а маршрутизаторы выбирают путь между ними.

Такой подход уменьшает broadcast-домены, делает отказ локальнее и обычно лучше масштабируется.

Native routing

Самый прямой вариант — вообще не использовать overlay. Узел получает маршрут до подсетей нагрузок через обычную таблицу Linux, BGP или физическую фабрику.

Преимущества:

  • нет дополнительного tunnel header;
  • проще MTU;
  • меньше обработки на узле;
  • underlay видит реальные направления трафика;
  • проще использовать аппаратную маршрутизацию.

Цена — underlay должен знать маршруты нагрузок. В облаке может потребоваться изменение route tables и отключение source/destination check. В собственном ЦОД — BGP-пиринг с leaf-коммутаторами или статическая маршрутизация.

IPIP

IPIP помещает IPv4-пакет внутрь другого IPv4-пакета. Заголовок маленький, схема простая, поэтому IPIP долго оставался популярным режимом Calico.

Но он использует IP protocol 4, а не TCP или UDP. Underlay и firewall должны пропускать этот протокол. Azure блокирует IPIP на уровне фабрики, а не только NSG. IPv6 этим режимом не обслуживается; Windows-узлы тоже ограничивают применение.

В Calico IPIP обычно сочетается с BGP: узлы распространяют маршруты сетей нагрузок, а пакет между ними переносится через IPIP.

GRE

GRE умеет переносить разные типы полезной нагрузки. Обычный GRE применяется как L3-туннель, GRETAP — для Ethernet.

Он полезен при интеграции с маршрутизаторами, старой инфраструктурой и нестандартными схемами. Но как массовая основа современного mesh проигрывает: нет встроенного шифрования, автоматического NAT traversal, выдачи ключей и политик. GRE — строительный блок, а не готовая платформа.

VXLAN в L3-сценарии

Хотя VXLAN переносит Ethernet-кадры, CNI может использовать его для доставки трафика между подсетями нагрузок, не предоставляя приложениям один большой L2-домен.

Налог на MTU при этом остаётся L2-инкапсуляцией: те же около 50 байт на IPv4, что в части 2. «L3-сценарий» меняет модель адресации для приложений, а не формат внешнего пакета.

Calico поддерживает VXLAN overlay без обязательного BGP. Cilium в tunnel mode строит между узлами сетку туннелей VXLAN или Geneve.

CrossSubnet

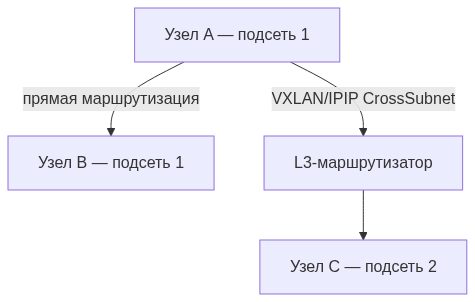
Инкапсуляция нужна не всегда. Допустим, несколько Kubernetes-узлов находятся в одной L2-подсети и могут напрямую доставлять пакеты друг другу. Другие узлы находятся в соседней зоне за маршрутизатором, который не знает pod-адресов.

Calico CrossSubnet действует избирательно:

  • внутри одной подсети трафик идёт без overlay;
  • при пересечении границы подсети включается VXLAN или IPIP.

Это уменьшает накладные расходы и сохраняет независимость от маршрутизации адресов нагрузок между сегментами. Calico рекомендует этот режим для multi-AZ и сетей, где L2-группы соединены маршрутизаторами.

CrossSubnet — не отдельный протокол. В ресурсе IPPool это поля vxlanMode: CrossSubnet и ipipMode: CrossSubnet. В operator Installation те же режимы называются VXLANCrossSubnet и IPIPCrossSubnet.

BGP full mesh и route reflector

Небольшой кластер может поднять iBGP между каждой парой узлов. Но число соседств растёт квадратично.

У ста узлов каждый поддерживает 99 BGP-соседств. Дальше разумнее использовать route reflectors или пиринг узлов с физической фабрикой.

Route reflector уменьшает количество сессий, но становится важным элементом control plane. Его нужно резервировать и правильно размещать.

Что выбирать

Неизвестный или плохо управляемый underlay: VXLAN обычно наиболее предсказуем.

Cilium с tunnel mode: VXLAN по умолчанию; Geneve — если этого требует функция или архитектура.

Calico, IPv4 и разрешённый protocol 4: IPIP остаётся рабочим простым вариантом.

Несколько L2-сегментов или AZ: VXLAN/IPIP CrossSubnet уменьшает лишнюю инкапсуляцию.

Полный контроль над маршрутизацией: native routing/BGP часто даёт лучшую производительность.

Нужно шифрование: не заменяем выбор транспорта словом WireGuard, а отдельно решаем, будет ли он основным L3-туннелем или дополнительным слоем поверх VXLAN/Geneve.

Где это ломается

  • Azure и часть облаков отбрасывают IPIP; «в лаборатории на Linux работало» здесь не аргумент.
  • BGP full mesh на сотнях узлов съедает CPU и сессии раньше, чем data plane.
  • CrossSubnet включают, не проверив, что underlay внутри подсети действительно доставляет пакеты напрямую.
  • VXLAN в «L3-режиме CNI» всё равно ест ~50 байт MTU из-за внутреннего Ethernet.
  • Шифрование путают с выбором транспорта и получают двойную инкапсуляцию без расчёта MTU.

В следующей части посмотрим на control plane: кто знает узлы, кто выдаёт маршруты и что останется работать, если центральная панель управления внезапно станет недоступна.

Предыдущая часть: «L2-overlay: VLAN, VXLAN, Geneve и EVPN»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Кто управляет сетью: контроллер, BGP и локальные агенты»

Схема

#network #selfhosting

Обложка

Цикл «Не светим лишнего». Выпуск 5.

Есть классическая заявка: «Пусти подрядчика к серверу, он сейчас быстренько посмотрит». Через три часа подрядчик заканчивает. Через полгода его адрес всё ещё лежит в trusted.

Временный allow-list отличается одной полезной деталью: у записи сразу есть срок жизни. В RouterOS динамическому address-list можно задать timeout. В nftables есть наборы с timeout. В других firewall встречаются динамические объекты и API.

Как выглядит нормальная выдача

Администратор выбирает не произвольные IP назначения, а готовый профиль:

  • monitoring-read: HTTPS к Zabbix и Grafana;
  • developer-test: SSH и HTTPS только в dev-сегмент;
  • cctv-contractor: веб-интерфейс камер и один сервисный SSH;
  • rdp-support: RDP к конкретной рабочей станции;
  • incident-admin: расширенный набор на время аварии.

Затем указывает внешний IP, срок, причину и ответственного. Контроллер добавляет адрес в соответствующую группу. Само firewall-правило уже существует и прошло проверку. Панель не должна уметь по введённой строке построить allow any any.

Lease — короткая аренда доступа

Удобно называть временную запись арендой, или lease. Пока lease действителен, адрес состоит в группе. Когда срок вышел, доступ закрывается автоматически.

Даже если нужен доступ «на весь день», лучше выдавать восемь часов, а не бессрочную запись с обещанием удалить вечером. Для особо чувствительных ресурсов можно сделать максимум 30–60 минут и разрешить продление.

Плюсы

  • исключение не живёт вечно;
  • работает с HTTP, SSH, RDP и другими протоколами;
  • не требует клиента;
  • хорошо автоматизируется через портал и API;
  • роли можно заранее проверить и согласовать;
  • журнал выдачи получается понятнее конфигурации firewall.

Минусы

  • идентичность всё ещё привязана к внешнему IP;
  • смена адреса обрывает возможность открыть новое соединение;
  • за общим NAT доступ получают все клиенты с тем же источником;
  • нужна синхронизация контроллера с несколькими firewall;
  • timeout на устройстве и срок в базе могут разъехаться.

Удалили запись — а SSH продолжает работать

Stateful firewall ведёт connection tracking. Открытый TCP-сеанс уже признан established. Если в начале цепочки стоит общий accept established,related, дальнейшая проверка актуального allow-list к нему может не применяться.

Есть два рабочих подхода.

Первый — для защищаемого направления проверять членство источника в активной группе раньше общего accept established. Тогда после удаления записи следующий пакет перестанет проходить.

Второй — при отзыве удалить подходящие записи connection tracking. Это действительно оборвёт SSH, RDP и веб-соединения. Но фильтр очистки должен быть точным: источник, назначение, профиль, а не «почистить вообще все соединения маршрутизатора».

FastTrack тоже надо учитывать. Ускоренный established-трафик может не попадать на нужную проверку. Защищаемые назначения часто проще исключить из FastTrack.

Где можно больно ошибиться

Доверять времени только в базе. Если контроллер считает сессию закрытой, а firewall получил запись без timeout, после падения связи она останется. У lease должен быть собственный короткий timeout на точке применения.

Продлевать бессрочно. Максимальная продолжительность сессии нужна даже при автоматическом продлении.

Не учитывать несколько шлюзов. Адрес удалился на одном MikroTik, но остался на резервном.

Открывать по IP из запроса без проверки прокси. Портал должен точно понимать, какой адрес увидит именно тот firewall, через который пойдёт дальнейший трафик.

Считать общий NAT безопасным. Временность уменьшает окно риска, но не превращает IP в индивидуальную личность. На целевом ресурсе остаётся собственная авторизация.

Что дальше

Временный список уже решает половину задачи. Осталось понять, каким действием пользователь может заслужить запись. Самый лёгкий вариант без веб-портала — port knocking: сначала правильно постучать в закрытые порты, потом получить короткий доступ.

Ранее в цикле

Документация и источники

#network

Обложка

AmneziaWG — форк WireGuard с переработанным транспортным слоем. Вышла версия 3.1, и вот что в ней поменялось.

Шифрование заголовков

Раньше заголовок сессии оставался открытым — по нему протокол легко читался на проводе. Теперь handshake и служебные поля пакетов шифруются, и первые байты сессии выглядят как случайные данные.

Рандомизация параметров сессии

Поля, которые раньше повторялись от соединения к соединению, теперь генерируются заново для каждой сессии. Соседние соединения перестали походить друг на друга по паттерну.

Совместимость с WireGuard

Ключи, формат пиров и общая структура конфига — прежние. Это тот же WireGuard, просто с другим транспортным слоем: всё, что написано под WG, работает без переделки.

Коротко: протокол стал аккуратнее под капотом, а снаружи для пользователя ничего не изменилось.

#network #selfhosting

Обложка

Реклама на сайтах бесит — это факт. Ставить блокировщик в каждый браузер и на каждый телефон лень, а хочется, чтобы резалось сразу для всей домашней сети: и ноутбук, и телевизор, и гостевой Wi-Fi.

Решение подсмотрел у ребят из Fatmetal — у них есть разбор, как поднять AdGuard Home на VPS с шифрованным DNS. Идея зашла, но я пошёл чуть дальше: вместо «DNS для телефона в любой сети» сделал «DNS для всей домашней сети через роутер». Дальше — что получилось, на какие грабли наступил и почему результат честно не стопроцентный.

Что вообще за AdGuard Home

Это DNS-сервер с фильтрацией. Он принимает запросы от клиентов, сверяет домены со списками блокировки и возвращает 0.0.0.0 для рекламы и трекеров. Всё, что не заблокировано, форвардит наверх — в моём случае на Quad9.

Работает на уровне сети: не нужно ставить приложения на каждое устройство. Телевизор, лампочки, приставка — всё, что ходит через этот DNS, автоматически получает чистый интернет.

Один бинарник на Go, ~43 MiB RAM в простое, конфиг — один YAML. Очень лёгкий.

Схема у меня

LAN-клиенты (192.168.x.x)
    ↓ DNS по DHCP = роутер
MikroTik (роутер)
    ↓ DoH (DNS over HTTPS)
dns.example (Caddy, валидный TLS)
    ↓ reverse_proxy
AdGuard Home (LXC, 10.0.0.22)
    ↓ апстрим DoH
Quad9 (9.9.9.9)

Клиенты даже не знают, что существует AdGuard: по DHCP они получают адрес роутера, а роутер уже сам ходит на наш DNS через шифрованный DoH. Одна настройка на роутере — и вся сеть фильтруется.

Как ставил

Шаг 1. AdGuard Home в LXC. У меня Proxmox, поэтому поднял отдельный контейнер: Ubuntu 26.04, один бинарник AdGuard Home v0.107.79 в /opt/AdGuardHome, systemd-сервис.

Первая засада: вручную написанный YAML сервис не принял («cannot construct !!seq into home.clientsConfig») — в свежих версиях схема конфига поменялась. Лечится просто: запустил AdGuard без конфига, он сам поднял мастер на порту 3000, я прошёл его через API — и только потом доправил YAML под себя. Урок: не пишите конфиг руками, дайте сервису сгенерить.

Шаг 2. DoH. По задумке у Fatmetal AdGuard сам терминирует TLS (DoH на 443, DoT/DoQ на 853). Я попробовал так же — и упёрся в то, что самоподписанный сертификат AdGuard отвергает («validating certificate pair: empty certificate»). А выпускать Let's Encrypt на сам AdGuard — лишняя возня, когда у меня уже есть Caddy, который умеет TLS из коробки.

Поэтому схему упростил: TLS терминирует Caddy на поддомене dns.example, а внутри сети гонит plain HTTP на AdGuard (у него есть режим insecure DoH ровно для reverse-proxy). Снаружи клиент видит валидный сертификат, внутри — ничего шифровать не надо.

Шаг 3. MikroTik. На роутере одна команда:

/ip dns set use-doh-server="https://dns.example/dns-query" servers="9.9.9.9,149.112.112.112"

servers оставил как фолбек: если наш DNS ляжет — роутер продолжит резолвить через Quad9 напрямую. DNS — критичный сервис, если он умрёт, «пропадёт интернет» на всех устройствах. Поэтому фолбек обязателен.

Грабли, на которые наступил

Грабля №1: роутер не может ходить на свой же внешний IP. MikroTik резолвил dns.example в свой WAN-адрес, шёл на него сам — и ничего не работало (hairpin NAT для собственного трафика не действует). Решение: статическая запись на роутере, которая ведёт dns.example прямо на Caddy через WireGuard-туннель:

/ip dns static add name="dns.example" address=10.99.0.2 comment="adguard-doh-via-wg"

Грабля №2: allow-remote-requests=no ломает DNS для всей LAN. Я решил «закрыть порт 53 наружу» этой настройкой — и клиенты в локалке перестали резолвить вообще. На RouterOS 7 эта опция отключает ответы DNS-сервера не только снаружи, но и для локальных сетей. Вернул yes, а снаружи порт 53 закрыл штатно — правилом firewall. Урок: на MikroTik не закрывайте DNS через allow-remote-requests, только через firewall.

Грабля №3: белый список внутри фильтра. Домен www.googleadservices.com (это Google Ads) упорно проходил — в самом списке AdGuard DNS filter оказалось whitelist-правило @@||www.googleadservices.com^|. Обычное правило блокировки его не перебивало. Лечится модификатором $important, который имеет приоритет над whitelist:

||www.googleadservices.com^$important

Грабля №4: кэш. После добавления правил реклама всё равно видна — потому что телефон и браузер закешировали реальные IP рекламных доменов ещё до блокировки. Инкогнито помогает от кэша браузера, но не от DNS-кэша ОС. Лечится временем или перезагрузкой устройства.

Что добавил для отечественной рекламы

Базовый список AdGuard DNS filter (178 тысяч правил) — хорошо, но российские рекламные сети в нём покрыты не полностью. Дописал свои правила в user_rules:

  • ads.adfox.ru, adfox.ru — AdFox, рекламная сеть Яндекса (баннеры на новостных сайтах)
  • an.yandex.ru, yabs.yandex.ru — Яндекс.Директ
  • 24smi.net — виджеты и видео 24СМИ
  • top-fwz1.mail.ru — счётчик Mail.ru
  • counter.yadro.ru — счётчик Яндекс.Метрики (спорно: это аналитика, но она же трекинг)
  • wcm.weborama-tech.ru — Weborama
  • ad.adriver.ru — AdRiver

Проверял на живых сайтах: rzn.info, 7info.ru — после правок их рекламные домены резолвятся в 0.0.0.0.

А теперь честно про результат

Работает: вся реклама, которая живёт на отдельных доменах (AdFox, Директ, 24СМИ, Google Ads), режется на уровне DNS для всех устройств в сети разом. Это, кстати, большая часть того, что бесит на новостных сайтах.

Не работает: – Реклама с CDN самого сайта. Часть баннеров новостники отдают со своих же доменов (cdn1.rzn.info и т.п.). DNS-фильтр не может отличить рекламу от контента на одном домене — иначе сломает весь сайт. – Яндекс.Директ через yandex.ru/ads. Скрипт грузится с основного домена Яндекса как путь (/ads/system/context.js). Заблокировать весь yandex.ru нельзя — это же сам Яндекс. DNS тут бессилен в принципе. – Видеореклама на плеерах — если ролик идёт с того же домена, что и само видео, DNS не поможет. – YouTube — реклама с тех же доменов, что и контент. DNS-фильтр это не берёт, нужен uBlock Origin или подобное.

Итого: DNS-фильтр закрывает, грубо, 70–80% раздражающей рекламы — всю, что на отдельных доменах. Остальное — это либо реклама с контентных CDN, либо встроенная в страницу, где DNS в принципе не может отличить. Для полной чистки в браузере всё равно нужен uBlock Origin.

Вывод

Для домашней сети связка «MikroTik + AdGuard Home через DoH» — это лучший баланс: одна настройка на роутере, вся сеть фильтруется, ничего не надо ставить на устройства. Но честно: это не 100% — DNS-блокировка по определению не режет рекламу с тех же доменов, что и контент.

Подход и первые шаги подсмотрел у Fatmetal — у них хороший разбор, рекомендую. А грабли с MikroTik, whitelist'ом и отечественной рекламой — уже мои, делюсь, чтобы вы не наступали.

А у вас что режет рекламу дома — DNS на роутере, uBlock, или всё вместе?

#selfhosting #network #dns #adguard #mikrotik #privacy