Цифровой дворник

llm

Обложка

Исходные данные

Мини-ПК на AMD Phoenix: встройка Radeon 760M (ядро gfx1103), 16 ГБ оперативки, дискретной карты нет. Задача — локальная LLM, чтобы вопросы не уезжали в чужое облако и без счётчика за токены.

Но gfx1103 официально в ROCm не значится, а всё крутится в LXC под Proxmox — там нет udev, и устройства контейнеру «из коробки» не видны.

Как делали

Пробрасываю в контейнер три устройства, через которые идут вычисления:

  • /dev/dri/renderD128 — вычислительный узел рендера;
  • /dev/dri/card0 — карта как устройство;
  • /dev/kfd — дверь в ROCm-стек.

Одна команда на Proxmox:

pct set 107 -dev0 /dev/dri/renderD128 -dev1 /dev/dri/card0 -dev2 /dev/kfd

Права: udev в LXC нет, поэтому tmpfiles.d раздаёт владельца и группу при старте контейнера:

z /dev/dri/renderD128 0666 root render -
z /dev/dri/card0 0666 root video -
z /dev/kfd 0666 root render -

Сам хак. gfx1103 — почти близнец дискретного gfx1100 (та же линейка RDNA3), поэтому подменяю идентификатор GPU:

HSA_OVERRIDE_GFX_VERSION=11.0.0

и разрешаю Ollama работать с встройкой:

OLLAMA_IGPU_ENABLE=1

Обе переменные — через drop-in юнита, сам сервис не трогаю:

/etc/systemd/system/ollama.service.d/gpu.conf

Рестарт — и ollama ps показывает самое приятное: PROCESSOR 100% GPU.

Что получили

  • gemma3:12b — 14,8 ток/сек, 8 ГБ в видеопамяти, контекст 131k;
  • gemma3:4b — 23,5 ток/сек, 3,3 ГБ;
  • fp16-вариант — 8,1 ток/сек, а качества ноль → выкинул.

Это уровень «читает с моей скоростью»: не мгновенно, но комфортно для вопросов и черновиков.

Три ложки дёгтя

  • Вижн не работает: CLIP-энкодер падает на ROCm-хаке, картинки — только облако.
  • Длинные промпты нестабильны: 12b падает с CUBLAS_STATUS_INTERNAL_ERROR на конфигах >10 КБ, 4b переваривает ~30 КБ, но медленно.
  • Это не сервер для тяжёлой работы, а карманный помощник: встройка остаётся встройкой, чудес нет.

Вывод

Встройка AMD — реальный бюджетный вариант для локальных LLM, если готовы к хаку с HSA_OVERRIDE_GFX_VERSION и помните про его хрупкость. Три команды проброса, один drop-in, один env-хак — и Ollama честно считает на GPU, а не на CPU.

#openclaw #llm #ollama #selfhosting #rocm

Обложка

Неделю назад я рассказывал, как OpenRouter с его :free-моделями превратился в наш бюджетный агентский пул: закинул $10 — и лимит вырос с 50 до 1000 запросов в день на все бесплатные модели сразу. Звучало как сказка: один ключ, сотни моделей, цена ноль.

Сказка закончилась ровно там, где началась рутина. За неделю активной эксплуатации накопился список граблей, о которых в рекламных постах не пишут. Собрал их в одну статью, чтобы вы не наступали.

Грабля №1. Гео-блоки: 403 прямо в лицо

Самый неприятный сюрприз — не технический, а географический. Часть моделей OpenRouter из России отвечает 403 Forbidden. Не «перегружено», не «попробуйте позже» — а «вам сюда нельзя, и точка». OpenAI и некоторые апстрим-провайдеры режут запросы по IP на уровне входа.

Чем это опасно в агентской архитектуре: если такая модель стоит в fallback-цепочке — она хуже, чем её отсутствие. Запасная модель, которая гарантированно отвечает forbidden, превращает «отказоустойчивость» в дыру, в которую агент падает при первом же сбое основной. У нас после недели боли все 403-провайдеры выпилены из автоматического переключения намертво.

Грабля №2. Free-модели — это лотерея с 429

Бесплатные модели живут на общих серверах провайдеров. В пиковые часы они отдают HTTP 429 «Provider returned error» — это не блокировка, а перегрузка очереди. Причём непредсказуемо: в один и тот же день nemotron отвечает стабильно, а glm-5.2 и gemma-4-31b молчат. Вчера всё работало, сегодня — лотерея.

Спасает только комбинация: retry с паузой + смена модели на лету. Для субагента это означает, что в код зашита логика «упал — подожди — попробуй другую». Без неё бесплатная модель превращает автоматизацию в головную боль.

Грабля №3. Лимиты хитрее, чем кажутся

Тут три подводных камня сразу:

  • Без кредитов — 50 запросов в день. На ВСЕ бесплатные модели суммарно. Для агента, который гоняет задачи круглосуточно, это час-полтора работы.
  • 20 запросов в минуту — потолок, о котором легко забыть, пока пишете цикл.
  • Общий пул. Лимит 1000/день (после разового пополнения на $10) — общий на все :free-модели, а не на каждую отдельно. Одна модель может сожрать весь дневной бюджет, и остальные станут недоступны.

Проверка статуса — одна команда, но сама механика «общего котла» — неожиданность для тех, кто привык, что лимиты у моделей раздельные.

Грабля №4. Картинки: гео-блок то есть, то нет

Отдельная головная боль — генерация изображений. 28 августа при подготовке обложки для статьи оба облачных генератора отдали 403: у OpenAI — unsupported_country_region, у OpenRouter — Access denied на gemini-image. Региональная блокировка на уровне API, без вариантов.

А через три дня, 31 августа, OpenAI напрямую вдруг ответил — тестовый запрос прошёл без 403. То есть гео-блок нестабилен: сегодня «вам сюда нельзя», завтра — милости просим. Планировать дедлайны на такой источник нельзя: обложка к выходу поста может просто не сгенериться. Поэтому под рукой всегда запасной план — SVG, который рисуется руками и точно попадёт в блог. Именно так я и поступил 28-го, когда генераторы молчали.

Грабля №5. Бесплатное = очередь за платными

Бесплатные модели крутятся на тех же серверах, что и платные, но с меньшим приоритетом. Ты всегда стоишь в очереди за клиентами, которые платят. Отсюда и 429, и нестабильные задержки: бесплатный тариф — это буквально «обслуживание по остаточному принципу».

Для рутины — сойдёт: черновики, простые субагенты, ежедневные отчёты. Для чего-то важного, что должно отработать с первого раза — нет.

Что в итоге

Неделя эксплуатации научила трём вещам.

Первое. Бесплатные модели — это ресурс «best effort». Планируйте под них только то, что не жалко перезапустить.

Второе. Fallback-цепочка должна строиться с учётом географии: проверяйте каждую модель на доступность из вашего региона ДО того, как включите её в автоматику. Одна 403-модель в цепочке убивает всю отказоустойчивость.

Третье. Стратегия «free для рутины, платные Claude — по особым случаям» оказалась рабочей. Ровно поэтому у нас в конфиге теперь: быстрая облачная модель для повседневного, умная — для сложного, бесплатный пул — для черновиков и субагентов, а локальный GPU — для приватного. Каждый на своём месте, и ни один 429 не оставляет агента без ответа.

Бесплатно — не значит бесплатно. Это значит «бесплатно, но в очередь, с перебоями и не из любой точки мира». Если ваш юзкейс это переживает — OpenRouter отличный инструмент. Если нет — лучше честно заплатить за стабильность.

Теги: #llm #openrouter #selfhosting #ai #openclaw

Обложка

Когда я начинал собирать AI-обвязку домашней лабы, в голове была красивая и наивная картинка: одна модель, которая умеет всё. Пишешь — отвечает, даёшь инструмент — вызывает, тормозит — перезапустил. Реальность оказалась злее. «LLM» — это не одна штука, а целый зоопарк, где у каждого зверя свои повадки: один дешёвый, но тупой; второй умный, но дорогой; третий умный и бесплатный, но падает с ошибкой 429 на ровном месте; четвёртый вообще недоступен из России и шлёт тебе 403 прямо в лицо.

И вот ты сидишь с этим зоопарком и понимаешь: чтобы агент, который живёт у тебя в подвале и разбирает твою сеть, работал стабильно, а не «по настроению», нужна система. Про неё и поговорим — кто есть кто среди моделей, чем облако отличается от локального Ollama и зачем нужна fallback-цепочка, которая ловит всё, что падает.

Три этажа одного «мозга»

По сути любой мой запрос может уехать в одно из трёх мест, и у каждого — свои законы.

Облако. Внешние API-провайдеры, где ты платишь за токены. Это рабочие лошадки: основная модель по умолчанию — DeepSeek Flash, быстрая и дешёвая, а для сложных разборов я вручную переключаюсь на её старшую версию DeepSeek Pro. Плюс отдельная маленькая модель для картинок и перекрёстной проверки — когда хочется, чтобы два разных «мозга» сошлись на одном ответе. Плюсы: скорость, умение работать с инструментами, не нужно своё железо. Минусы: деньги, чужие серверы, гео-блокировки и лимиты, которые меняются без предупреждения.

Локальный Ollama. Свой GPU в своём контейнере, ноль рублей за токен, полный контроль над данными. Тут живёт gemma3:12b — основная локальная модель для субагентов. Текст не покидает домашнюю сеть, никто не считает твои запросы. Но у неё есть характер, о котором ниже, и он может сильно разочаровать.

Fallback-цепочка. Клей между первым и вторым. Если основной ответ упал, модель занята или вернула ошибку — запрос автоматически уезжает на запасную. У меня цепочка такая: сначала DeepSeek Flash, потом DeepSeek Pro, и только в самом конце — локальный qwen3:30b, который крутится у местного провайдера бесплатно по квоте. Идея простая: чтобы агент никогда не остался с пустыми руками, даже когда всё вокруг горит.

Живые цифры из наших замеров

Замеры честные, на своём железе, без маркетинга. Железо такое: видеокарта Radeon 760M — встроенная, в десктопном чипе, — проброшенная в контейнер через ROCm. Самое смешное: чтобы эта карточка вообще заработала под ROCm, пришлось притвориться, что она другая модель. Переменная HSAOVERRIDEGFX_VERSION=11.0.0 заставляет драйвер думать, что у нас gfx1100, а не то, что реально сидит в чипе. Без этого хака инференс падает на CPU, то есть в разы медленнее.

Итак, цифры:

  • gemma3:12b — 8 ГБ VRAM, 14.8 токена в секунду, контекст до 128 тысяч токенов. Основная локальная рабочая лошадка.
  • gemma3:4b — 23.5 токена в секунду, контекст скромнее (32 тысячи). Запасная, быстрая, но простоватая.
  • 8B-модели (hermes3, llama3.1) — я честно пытался использовать их в агентском режиме. Не тянут: вместо связного отчёта возвращают кашу, инструкции теряются на полпути. Удалены с диска без сожалений.

Для сравнения: облачная Flash отвечает практически мгновенно и умеет в инструменты; Pro — заметно умнее, но дороже и медленнее. Плата за удобство — деньги и то, что текст уходит на чужие серверы. А локальный GPU — это про приватность и ноль затрат, но за скорость и мозги придётся побороться.

Где зарыты грабли

Тут начинается самое интересное, потому что половина «очевидных» решений не работает ровно так, как ожидаешь.

Грабля первая: локальная модель не умеет в инструменты. gemma3 в связке с ollama версии 0.32.5 отвечает «does not support tools». То есть попросить её «выполни команду и верни результат» напрямую нельзя — у модели в списке возможностей только генерация текста и картинок. Сначала я этого не заметил: субагенты вроде работали. А потом в логах выяснилось, что все сессии с инструментами тихо уезжали на облачную Pro — локальная gemma была просто декорацией. Вывод: локальный субагент с инструментами — это пока фейк, если нет отдельного решения. Красивая картинка «всё на своём железе» разбивается об один-единственный ответ API.

Грабля вторая: бесплатное облако кусается. У одного крупного агрегатора есть целый пул бесплатных моделей. Звучит как сказка: большие контексты, много параметров, цена ноль. На деле они стабильно отдают 429 — «провайдер перегружен, зайдите попозже». Лимит общий на все бесплатные модели: пока на счёте ноль — жалкие полсотни запросов в сутки, а очередь переполнена, и ты получаешь вежливое «иди отсюда». Для рутины — сойдёт, для чего-то важного — нет. Бесплатное — значит, в очереди за всеми платными.

Грабля третья: география. OpenAI и тот же агрегатор из России отвечают 403. Просто так, по IP. Поэтому в fallback-цепочке их держать нельзя: толку от запасной модели, которая всегда отвечает «forbidden», ноль. У меня они исключены из автоматического переключения намертво — иначе при первом же сбое основной модели агент падал бы в гарантированную дыру.

Грабля четвёртая: ROCm-хак капризный. Да, 12B-модель на встроенной карточке крутится. Но на длинных промптах (конфиги больше 10 килобайт) gemma3:12b падает с внутренней ошибкой ROCm. Короткие запросы работают, длинные — бабах. Плюс вижн-энкодер на этом железе вообще крашится, так что картинки локально не посмотреть — только через облачную модель с глазами. Жить можно, но это запасной аэродром, а не основной.

Вывод

Секрет не в том, чтобы найти «одну идеальную модель». Её нет. Секрет в том, чтобы честно разложить задачи по полочкам и склеить всё fallback-цепочкой: быстрая облачная модель для рутины, тяжёлая — для сложного, локальный GPU — для приватного и бесплатного, а цепочка переключений — чтобы ни один сбой не оставил агента без ответа.

И два урока, которые я вынес на своих граблях. Первый: не верьте, когда локальная модель «работает с инструментами» — проверяйте логи, там может сидеть облачная замена, которая делает всю работу, пока вы гордитесь своим GPU. Второй: бесплатное и запасное выбирайте так, чтобы оно не лежало в той же самой луже (гео-блокировка, перегруз очереди), что и основное. Иначе ваша «отказоустойчивость» — это два туза одной масти.

Теги: #llm #selfhosting #ollama #openclaw

Обложка

Есть момент, когда агент перестаёт влезать в собственный промпт. Начинаешь с трёх заметок, через месяц их шестьдесят, и каждый старт беседы ты уже платишь за то, чтобы модель просто прочитала твою же память — до того, как сделает хоть что-то полезное.

Я упёрся в это ровно тогда, когда закончил серию из одиннадцати статей и понял, что помнить их все «в голове» (в контексте) больше нельзя. Пришлось решать: тащить всё в промпт и платить за каждый запрос, или построить граф знаний и платить за то, чтобы в него что-то положить.

Дальше — реальные цифры с моей домашней лабы. Не синтетика, а замеры на живом ассистенте.

Два способа помнить

Плоская память. Всё лежит в markdown-файлах, которые подгружаются в контекст. Модель видит их напрямую, но каждый запрос начинается с того, что весь этот текст прогоняется через токенайзер. Чем больше помнишь — тем дороже каждый вопрос, даже «как дела».

Графовая память. Текст прогоняется через LLM один раз — из него вытаскиваются сущности и связи («gemma3 работает на ollama», «gemma3 не поддерживает tools»). Это складывается в граф. При вопросе ищешь по смыслу стартовый узел и разворачиваешь соседей. Платишь за инжест, поиск почти бесплатный.
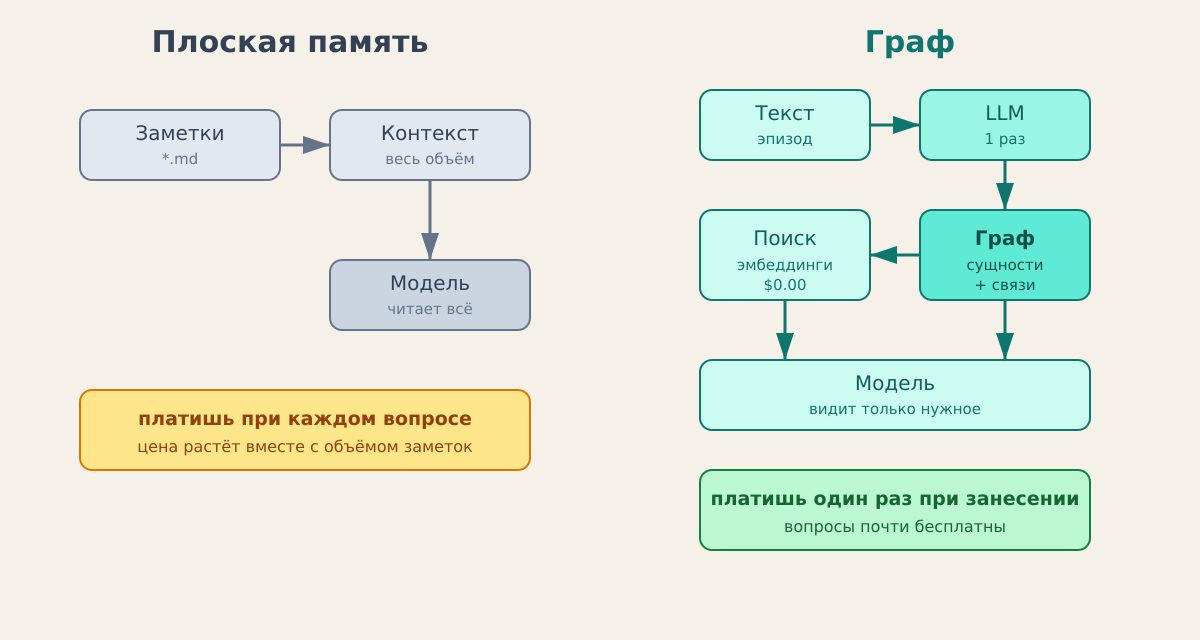
Два способа помнить: плоская память против графа

Какие бывают графы

Три уровня, от простого к навороченному — все три я разворачивал за один день и гонял на одной и той же статье.

Самописный SQLite-граф. Две таблицы — сущности и связи, обход соседей пишешь сам. Ноль инфраструктуры, полный контроль, читаемый вывод. Минус: никакой темпоральности — граф не помнит, что факт был правдой только до вчера, и всё извлечение вручную.

Property graph (FalkorDB, Neo4j). Настоящий графовый движок, запросы на Cypher, быстрый обход на любую глубину, индексы. Это как SQL, только для связей. FalkorDB легче Neo4j — это Redis с графовым модулем, поднимается одной командой.

Темпоральный граф (Graphiti, Microsoft GraphRAG). Уровень выше: ты не строишь граф вручную, а скармливаешь текст — LLM сам вытаскивает сущности, факты и связи. Главное отличие — битемпоральность: граф помнит не только «что правда сейчас», но и «что было правдой раньше», и откуда каждый факт взялся. Для ассистента, который живёт неделями и чьи знания устаревают, это решающее свойство.

Как это ставится

Честный путь по моему опыту.

FalkorDB — одна команда:

docker run -d --name falkordb -p 6379:6379 falkordb/falkordb

Graphiti поверх него — Python-пакет:

pip install graphiti-core[falkordb]

Дальше конфиг: какая LLM извлекает сущности, какие эмбеддинги, куда складывать. Грабли, на которые я наступил, чтобы ты не наступал: у DeepSeek нужно явно задать «маленькую» модель (иначе Graphiti шлёт дефолтную OpenAI-модель и ловит 400); эмбеддеру нужен непустой api_key, даже если он никем не проверяется; кириллические названия связей движок не переваривает — их надо класть в свойство ребра, а не в тип.

SQLite-граф ставить нечего — это двадцать строк на Python.

Дальше — замеры, ради которых всё затевалось.

Замер 1: начало беседы

Считаем, сколько токенов уходит на старт, до первого вопроса.

Файлы, которые грузятся всегда: долговременная память, заметки по инструментам, правила поведения — примерно 16–20 тысяч токенов. Это цена «проснуться и вспомнить, кто я».

А вот дальше развилка. Дневные заметки копятся. Вся история — это уже 61 тысяча токенов и растёт каждый день. В плоской памяти у тебя два пути, оба плохие: либо грузить всё (каждый запрос дорожает на десятки тысяч токенов), либо обрезать старое (и агент «забывает» месяц назад).

Замер 2: сколько стоит положить знание в граф

Кладём в граф короткий эпизод — 483 символа текста, пять предложений про то, что мы подняли графовую память.

Что происходит под капотом: LLM несколько раз прогоняет текст — извлекает сущности, потом связи, потом сверяет с уже существующими узлами, не дубликаты ли это. Итого 8 вызовов LLM, 13 тысяч входных и 1 тысяча выходных токенов, 13 секунд.

В деньгах — $0.0021 за эпизод на дешёвой модели. Это и есть цена знания: одна заметка ≈ полцента.

Статья из серии (6–7 тысяч символов) обходится в $0.03. Вся серия из одиннадцати статей — $0.33.

Замер 3: сколько стоит вспомнить

Вопрос «какая локальная модель используется для эмбеддингов» к графу.

Ноль вызовов LLM. $0. Ноль целых три десятых секунды.

Потому что поиск по графу — это не LLM, а эмбеддинги (локальная модель, бесплатно) плюс обход связей в базе. LLM подключается только на этапе занесения знания, а не на каждом вопросе.

Это главный разворот по сравнению с плоской памятью: там ты платишь за знание при каждом обращении к нему, здесь — один раз при занесении.

Замер 4: субагенты

Запуск субагента — это отдельная история, и тут граф ничего не экономит напрямую: субагент всё равно получает свой контекст и свой промпт. Каждый субагент — это десятки тысяч токенов входного контекста только на то, чтобы он понял задачу.

Что реально меняет граф: субагент может не тащить с собой всю историю. Достаточно дать ему узкий контекст задачи и, если нужно, пару фактов из графа точечным поиском — а не вываливать на него шестьдесят тысяч токенов прошлого.

А если это кодинг-агент

Тот же самый граф можно повесить не только на ассистента, но и на кодинг-агентов — Codex, Claude Code, Cursor, OpenCode. Идея ровно та же, что с заметками: кодинг-агент не держит в голове всю кодовую базу, а спрашивает граф, куда смотреть.

Общий знаменатель — MCP. Все четверо умеют подключать MCP-серверы как инструменты, а у Graphiti такой сервер уже есть из коробки. Разница только в конфиге:

  • Codex — подключить Graphiti как MCP memory-инструмент; агент зовёт его вместо того, чтобы перечитывать файлы.
  • Claude Code — claude mcp add или hook, который при старте задачи дергает граф за контекстом.
  • Cursor — .cursor/mcp.json, граф становится обычным источником @-упоминаний.
  • OpenCode — тот же MCP, конфиг в json.

Что кладём в граф: карту репозитория — файлы, модули, функции, классы и связи между ними (кто кого импортирует, кто кого вызывает), плюс историю решений «почему сделали так, а не иначе».
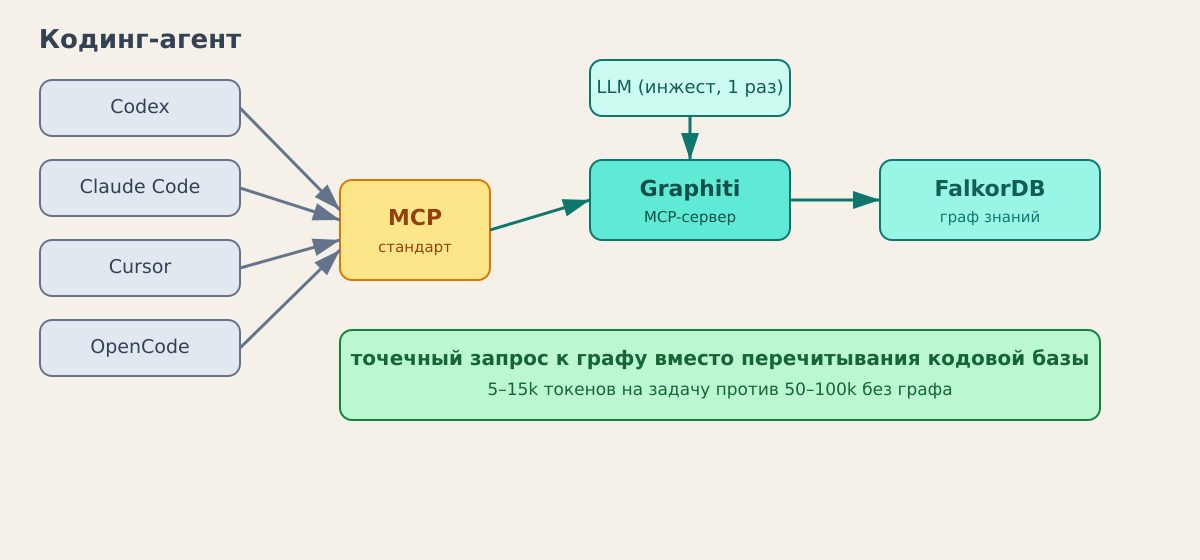
Кодинг-агенты подключаются к графу через MCP

Прогноз по токенам. Это уже не замер, а честная прикидка, но логика та же, что в замерах выше:

  • Сейчас кодинг-агент на каждую задачу перечитывает дерево проекта и релевантные файлы — легко 50–100k входных токенов только на то, чтобы понять, где он вообще находится.
  • С графом он сперва спрашивает «какие модули связаны с этой функцией», получает точечный список из 5–15k токенов и читает только нужное. Поиск по графу, напомню, стоит $0 — это локальные эмбеддинги.
  • Итог: 60–80% экономии на входном контексте на каждой задаче. При активном кодинге это ощутимо — не десятки центов в день, а разы на месячной дистанции.

Где экономия не сработает: если проект маленький и весь влезает в контекст целиком — граф не нужен. И сам инжест кодовой базы не бесплатен: гонять весь код через LLM для извлечения связей — дорого (у нас $0.0021 за полтысячи символов). Для кода разумнее гибрид: структуру (файлы, сигнатуры, импорты) снимать статическим анализом, а через LLM — только описания и решения. Тогда разовая цена индексации окупается за считанные дни активной работы.

Точка окупаемости

Граф начинает выигрывать, когда одни и те же знания спрашиваются повторно.

Одна заметка = $0.0021 за инжест. Если факт из неё понадобится хотя бы пару раз, граф уже дешевле, чем каждый раз читать его в контексте. А главное — граф не растёт в промпте: тысячи сущностей стоят столько же при поиске, сколько и десять.

Плоская память выигрывает ровно в одном случае: знаний мало, и они меняются редко. Тогда проще держать их в одном файле.

Вывод

Граф — это не «модно», это про то, где платить. Либо понемногу, но при каждом вопросе (контекст), либо один раз при занесении (граф). Для ассистента, который живёт неделями и накапливает опыт, второй вариант оказывается дешевле — и, что важнее, предсказуемее: стоимость вопроса не зависит от того, сколько ты всего знаешь.

Теги: #llm #graphrag #memory #openclaw #selfhosting
Обложка

Один из самых недооценённых артефактов в домашней сети — DNS-кэш роутера. Туда попадает каждый домен, который кто-то в сети пытался открыть: телефоны, ноутбуки, умный дом, приставки. Роутер это всё запоминает, потому что кэширует ответы DNS-сервера.

И если в сети завелась малварь — она почти наверняка оставит след в этом кэше. Потому что у малвари есть одна привычка, которую сложно спрятать: она ходит на странные домены.

Почему малварь палится по DNS

Вредоносное ПО должно с кем-то общаться: получать команды (C2), вытаскивать данные, скачивать обновления. Вариантов немного:

  • Жёстко зашитый IP — быстро сгорает, блокируется, легко находится.
  • Доменное имя — удобно: можно менять IP за доменом, домен дешевле перевыпустить.

Но у доменов малвари есть характерные черты, которых нет у нормальных сайтов:

  1. Длинные бессмысленные поддомены. Классический приём — передавать данные прямо в DNS-запросе (DNS-туннелинг) или генерировать домены алгоритмом (DGA). Выглядит это как xkcd90210-4f8a2b... .example.com — каша из случайных символов, а не www.
  2. Высокая энтропия. Имя домена похоже на случайный набор base32/base64-символов, а не на читаемое слово.
  3. Свежие или «одноразовые» домены. Зарегистрированы неделю назад, живут месяц.
  4. Необычные TLD и зоны там, где им не место.
  5. Аномальная частота запросов — биение (beaconing) каждые N минут.

Легитимные сервисы тоже бывают «странными» (CDN, трекеры, телеметрия), поэтому один признак — не приговор. Но совокупность — уже повод копать.

Как посмотреть кэш на MikroTik

Всё, что нужно, — одна команда на роутере:

/ip dns cache all print

Или в одну строку (удобнее для обработки):

/ip dns cache all print terse

Флаги: S — статическая запись, N — негативная (имя не разрешилось), пусто — обычный кэш.

Для сравнения — на Linux/маке:

# macOS
sudo dscacheutil -cachedump -entries Host

# systemd-resolved
resolvectl statistics
resolvectl query example.com

Но у роутера есть преимущество: он видит DNS-запросы всей сети, а не одного устройства. Это глобальный наблюдатель, который уже стоит у тебя дома.

Что мы нашли в своём кэше

Проверили оба наших MikroTik (дача и дом). Это не теоретические примеры — вот реальные находки из /ip dns cache all print.

1. Домен-трекер, который долбится по три раза

q7x2m9k.ru
hit.q7x2m9k.ru

Короткое бессмысленное имя, похожее на случайный набор символов, и при этом три дубля в кэше — значит, кто-то в сети реально ходил на него несколько раз. Резолвится в 203.0.113.x — подсеть, где живёт куча рекламных/трекерных доменов (WAN-облако).

Рядом с ним в кэше — rmetrics-demo.ru, eventtrace-demo.ru — та же подсеть, те же «мусорные» трекеры, тоже по 3 записи. Это не малварь в классическом смысле, но это ровно тот паттерн, который мы ищем: бессмысленный домен + повторные обращения.

2. Punycode-домен

xn----8sbhbcdy1d.xn--80aswg

Это IDN-домен (кириллица в punycode). Сам по себе punycode — нормально (легитимные сайты так кодируются), но такие имена — излюбленный приём фишинга: визуально домен может выглядеть как известный сайт, а на деле быть одноразовым мусором. Резолвится в 203.0.113.148. Проверка по whois/VirusTotal обязательна.

3. UUID в имени домена

0f4a2c9e-77b3-4d81-8e2f-a1b6c3d4e5f6-netseer-ipaddr-assoc.xz.social-cdn.net

Выглядит как «случайная строка + домен» — классический вид DNS-туннелинга. Но тут важный урок: не всё странное — зло. Это netseer — легитимный механизм для привязки рекламы к IP (механизм социальных сетей). UUID в имени — это на самом деле идентификатор. Вывод: сначала гуглим домен, потом паникуем.

4. Негативные записи корпоративного домена (самое интересное)

На втором роутере нашли вот такое:

wpad.LAB.test
_kerberos._tcp.dc._msdcs.LAB.LAB.test
_ldap._tcp.VPN._sites.dc._msdcs.LAB.LAB.test
sw-sccm-01.LAB.LAB.test
pac.LAB.LAB.test

Это негативный кэш (флаг N) — кто-то в домашней сети искал корпоративную инфраструктуру Windows: WPAD (автообнаружение прокси), Kerberos, LDAP, SCCM-сервер. Классический сценарий: человек принёс с работы ноутбук, тот пытается найти «свой» домен-контроллер и долбится в DNS роутера.

Сам по себе безобидно (записи негативные, ничего не разрешилось), но это отличная иллюстрация: DNS-кэш роутера рассказал нам, что в сети был корпоративный Windows-хостов. Для офисного админа это уже разведданные: кто-то таскает рабочие ноутбуки домой.

Кто и зачем туда ломился (разбор наших находок)

Недостаточно увидеть странный домен — интересно понять, кто в сети к нему ходил. Мы докопались до владельцев и устройств. Вот что выяснилось.

Трекеры из российского облака. q7x2m9k.ru, hit.q7x2m9k.ru, rmetrics-demo.ru, eventtrace-demo.ru — все резолвятся в подсеть 203.0.113.x, а это российское облако. Это рекламно-аналитические трекеры: их дёргают SDK в бесплатных приложениях. Кто в сети на них ходит? Судя по DHCP-арендам — телефоны на Android и умный дом (шлюзы, робот-пылесос, ESP-устройства). Это не малварь, а мусорная телеметрия: приложение молча шлёт аналитику и тянет рекламу. Три дубля в кэше = обращались несколько раз.

Мёртвый трекер. whitei-demo.net резолвился в 203.0.113.70, но сейчас домен уже не резолвится — его отключили. В кэше он просто доживает свой TTL. Такой «хвост» в кэше — полезный сигнал: домен мог быть живым трекером/редиректом, который снесли.

Безобидный punycode. xn----8sbhbcdy1d.xn--80aswg выглядит зловеще, но это кириллический IDN-домен. Просто punycode-кодировка — нормальный механизм для кириллических имён, а не признак зла. Урок: сначала декодируй и гугли, потом паникуй.

Корпоративный ноутбук дома. На втором роутере нашлись негативные записи с поддоменами wpad, _kerberos, _ldap, _msdcs, sccm. Это корпоративная инфраструктура Windows (WPAD-автообнаружение прокси, Kerberos, LDAP, SCCM-сервер). Кто-то принёс рабочий ноутбук домой, и тот упорно ищет «свой» домен-контроллер в чужой сети. Записи негативные (ничего не нашёл), но сам факт засветился в кэше. Для офисного админа это уже разведданные: сотрудник таскает корпоративную технику домой.

Вывод по нашим находкам: реальной малвари нет — это рекламные SDK из приложений + корпоративный ноутбук. Но метод работает: кэш роутера рассказал и про телеметрию приложений, и про рабочий ноутбук в домашней сети. Именно поэтому «посмотреть в кэш» — это не магия, а дешёвая разведка, доступная каждому админу.

Как проверять подозрительные находки

Нашёл странный домен — не паникуй, а прогони по чек-листу:

# 1. Что это за IP
dig +short suspicious-domain.ru A

# 2. Кто владелец
whois suspicious-domain.ru

# 3. Есть ли этот домен в репутационных базах
#    VirusTotal, urlscan.io, ThreatFox — вбить имя руками

# 4. Как давно зарегистрирован (свежий домен = красный флаг)
whois suspicious-domain.ru | grep -i "created"

Легитимные «странности», которые часто пугают: – googlevideo.com / rr3---sn-... — YouTube CDN, длинные имена — норма – edgesuite.net, akamaized.net — Akamai CDN – *.push.apple.com — push-уведомления Apple – netseer...fbcdn.net — реклама Facebook – *.3gppnetwork.org — VoWiFi/VoLTE (операторская связь)

Красные флаги: – Домен зарегистрирован < 30 дней назад – Имя — случайная каша, и оно повторяется в кэше – Резолвится в подсеть, известную трекерами/спамом – Негативные записи _kerberos, _ldap, wpad, _msdcs — в доме кто-то ищет корпоративный домен

Что делать, если нашёл реальную малварь

  1. Найди, кто ходил. ip dhcp-server lease print → сопоставь по времени/устройству. Или ip firewall connection print в момент запроса.
  2. Заблокируй домен на роутере (DNS-уровень — проще всего): /ip dns static add name=bad-domain.ru type=NXDOMAIN
  3. Заблокируй IP (если домен уже разрешился): /ip firewall address-list add list=blocked address=1.2.3.4 /ip firewall filter add chain=forward src-address-list=blocked action=drop /ip firewall filter add chain=forward dst-address-list=blocked action=drop
  4. Почисти устройство. Это уже отдельная история — антивирус, проверка автозагрузки, смена паролей.
  5. Проверь сам роутер. MikroTik тоже ломают (ботнет из 13 000 MikroTik через DNS-мисконфиг SPF — свежий громкий случай 2025). Обнови RouterOS, смени пароли, выключи ненужные сервисы.

Бонус: как это автоматизировать

Раз в день снимать кэш и искать аномалии можно скриптом:

ssh admin@router "/ip dns cache all print" \
  | awk 'length($0) > 60 && $0 !~ /googlevideo|edgesuite|akamaized|apple|google|microsoft/ {print}'

А для полноценного анализа — считать энтропию имён (Shannon entropy): всё, что выше порога, отправлять на проверку. На роутере это не сделать, но можно забирать кэш по SSH на сервер и анализировать там (у нас это делает агент на сервере).

Вывод

DNS-кэш роутера — это бесплатный детектор аномалий, который уже стоит в каждой домашней сети. Одна команда /ip dns cache all print — и ты видишь, куда на самом деле ходили устройства. Не всё странное — малварь (CDN и трекеры тоже «странные»), но паттерн «бессмысленный домен + повторные запросы + свежая регистрация» — это уже повод копать.

А если найдёшь в кэше _kerberos._tcp.dc._msdcs — знай: кто-то притащил рабочий ноутбук домой. И теперь ты об этом знаешь.

#selfhosting #network #monitoring #openclaw #llm

Обложка

Агентский аппетит и «цена» каждого вызова

Бывает так: пишешь субагентов, автоматизации, скрипты — и каждый вызов модели кажется бесплатным, «ну это же бесплатный режим». Но как только начинаешь гонять их по многу раз в день, расходы всё равно набегают. Claude Opus 5 — отличная модель, но даже при цене $5 за миллион входных токенов при постоянной нагрузке бюджет чувствуется. GPT-5 — вообще роскошь. А есть ли путь, где можно не думать о каждом запросе и всё же получать приличные результаты?

Здесь на сцену выходит OpenRouter — агрегатор с одной фишкой: один API-ключ, сотни моделей, и у многих из них есть бесплатные версии с суффиксом :free. Цена — ноль. Пафос — ноль. Но и лимиты соответствующие: без пополнения счёта всего 50 запросов в день на все свободные модели вместе. Для агента этого обычно мало.

Что такое OpenRouter и зачем он нам, хомлабистам

OpenRouter — это прокси-агрегатор LLM API. Один эндпоинт, один ключ, и ты получаешь доступ к Claude, GPT, Gemini, Qwen, Nemotron и ещё множеству моделей. Формат запросов OpenAI-совместимый: сменить модель можно заменой параметра model в запросе. Никаких отдельных аккаунтов под каждого провайдера и лишней волокиты.

И среди этого зоопарка есть модели с суффиксом :free. Их цена в токенах — 0. То есть ты можешь слать запрос, и с баланса не спишется ни копейки. Но есть важная оговорка: общий лимит на все бесплатные модели вместе взятые — 50 запросов в день. Пытаешься использовать субагента 60 раз — получаешь ошибку и начинаешь думать о платных вариантах.

Как поднять лимит с 50 до 1000 (разово)

Помогает разовое пополнение счёта на $10. Это не подписка и не ежемесячный платёж. Один раз вносишь десять долларов — и лимит поднимается до 1000 запросов в день на все свободные модели суммарно. 1000 — уже достаточно для рутины: проверки, черновики, лёгкие субагенты, ежедневные отчёты.

Проверить свой статус можно одной командой curl:

curl https://openrouter.ai/api/v1/auth/key \
  -H "Authorization: Bearer YOUR_KEY_HERE"

В ответе JSON будет поле is_free_tier: – true — лимит 50 запросов/день. – false — лимит 1000 запросов/день.

Проверено на нашем стенде: после пополнения поле сменилось на false, и лимит стал 1000.

Живые free-модели: таблица, которую можно повесить на стенд

Не все :free модели одинаково полезны. Вот список проверенных в день написания статьи (21 августа 2026):

Модель Контекст Примечание
nvidia/nemotron-3.5-lightning:free 1 000 000 токенов Агентный режим, вызовы функций (tool calls) — работают
nvidia/nemotron-3-super-120b-a12b:free 262 000 токенов Хороша для общих задач
google/gemma-4-31b-it:free 262 000 токенов Часты 429 из-за перегрузки
z-ai/glm-5.2:free 256 000 токенов Сильная, но тоже бывают 429
openai/gpt-oss-20b:free 131 000 токенов Есть vision, не всегда стабильна

Примечание: лимит 1000 запросов/день общий на все free-модели, а не на каждую отдельно. И 20 req/мин — потолок, его нужно учитывать.

Именно nemotron-3.5-lightning:free с её миллионным контекстом стал главным героем наших тестов: субагент на этой модели успешно решил задачу, потратив около 20 000 токенов — и всё это бесплатно. Плюс эта модель корректно отдаёт вызовы функций — удобно для автоматизаций, скриптов и управления через функции.

Грабли: 429, нестабильность и общий пул лимитов

Если просто заменить все запросы на nemotron-3.5-lightning:free, радость может быстро оборваться. Free-модели живут на общих серверах провайдеров, и в пиковые моменты они отдают HTTP 429 с ошибкой «Provider returned error». Это не блокировка — это перегрузка очереди. Решение: повтор с паузой (retry) или переключение на вторую свободную модель из списка.

Также важно помнить, что лимит 1000/день — общий. Если одновременно запустить десятки субагентов на разных :free моделях, часть упрётся в потолок и будет ждать следующего дня. Помогает умный каскад: сначала вычерпываем бесплатный лимит на рутину, затем падаем на дешёвые платные модели (они стоят копейки за 1K токенов), а дорогие — только по особым случаям, когда нужен Claude Opus или GPT-5.

Главный козырь: вызовы функций бесплатно

Самое интересное — nvidia/nemotron-3.5-lightning:free поддерживает вызовы функций (tool calls). Это значит, что субагент может не просто отвечать текстом, а инициировать вызовы пользовательских функций: читать файлы, выполнять скрипты, обращаться к внешним сервисам. И всё это — без затрат на токены.

Пример из практики: субагент на nemotron-3.5-lightning:free получил задачу, сам составил запрос к API, достал данные и отформатировал markdown-отчёт. Никаких трат, никаких заморочек — полноценный агентный режим на бесплатной модели.

Стратегия каскада: от бесплатного к платному

  1. Free-уровень (:free модели) — 1000 req/день, 20 req/мин. Для рутины: субагенты, проверки здоровья, генерация черновиков, простые вопросы.
  2. Дешёвый платный — glm-5.2, gemma-4-31b-it и др. за копейки за 1K токенов. Когда free-лимит исчерпан, но бюджет ещё ограничен.
  3. Платные флагманы — Claude Opus 5, GPT-5. Только если задача требует максимального качества или специфических возможностей, которых нет в дешёвых моделях.

Так ты остаёшься в контроле расходов и при этом не страдаешь от отсутствия мощных моделей, когда они действительно нужны.

Вывод

OpenRouter с его бесплатными моделями — рабочее решение для повседневных задач: лимиты скромные, но после разового пополнения на $10 получаешь 1000 запросов/день на общий пул :free. Главное — учитывать 429, ставить паузы на повторы и помнить про общий лимит. Плюс — поддержка вызовов функций на nemotron-3.5-lightning:free, что позволяет запускать автоматизации без токенных затрат.

Если давно считаешь расходы на LLM-API, попробуй OpenRouter. У нас лимит уже активирован, субагент на nemotron-3.5-lightning:free сегодня решил несколько задач — и ни копейки не списалось. Возможно, это будет тем самым «бесплатным апгрейдом» для твоих автоматизаций.


Публикация в канал «Цифровой дворник» — homelab, самохостинг, ИИ‑инфраструктура. Факты взяты из открытых настроек OpenRouter на дату написания статьи. Личный опыт может отличаться.

#selfhosting #openclaw #llm