Цифровой дворник

network

Обложка

Цикл «Виды связности и SDN», часть 9. Предыдущая часть: «Шифрование в SDN: MACsec, IPsec, WireGuard и mTLS».

Срез по продуктам: уровень, NAT/relay, управление, HA.

Список функций mesh-платформ выглядит одинаково: зашифрованная сеть, простое подключение, ACL, DNS, NAT traversal. Различия начинаются после вопросов о data plane, relay и отказе управления. Типы HA и тесты отказа — в части 5; свойства NAT и TCP/443 — в части 7.

Headscale

Headscale — self-hosted реализация control server для клиентов Tailscale. Клиенты используют WireGuard, пытаются построить прямой UDP-путь и при необходимости работают через DERP.

Сильные стороны:

  • знакомые клиенты Tailscale;
  • собственный control plane;
  • ACL и OIDC;
  • возможность своего DERP;
  • сравнительно простая установка.

Ограничения:

  • проект ориентирован на один tailnet, self-hosters и небольшие организации;
  • официально рекомендуется SQLite; PostgreSQL в режиме сопровождения;
  • штатного active-active control plane нет;
  • интерфейсы управления в основном сторонние;
  • DERP — отдельный компонент, его нет внутри бинарника Headscale.

Хороший выбор для лаборатории, небольшой команды и собственной инфраструктуры, если один контроллер с нормальным резервным копированием допустим.

NetBird

NetBird строит L3-сеть на WireGuard. Management управляет узлами, адресами и policies, Signal помогает установить P2P, Relay используется при неудачном прямом соединении.

Плюсы:

  • полноценный self-hosting;
  • web-интерфейс и identity integration;
  • прямой WireGuard data plane;
  • relay с QUIC и запасным WebSocket;
  • несколько relay;
  • маршрутизация сетей за routing peers.

Нюанс HA: Community — один Management. Active-active Management и Signal — Enterprise (PostgreSQL, Redis, NATS). Несколько собственных relay доступны в обеих редакциях.

Netmaker

Netmaker автоматизирует WireGuard между серверами, площадками и пользователями. Он удобен для full mesh и site-to-site, предоставляет gateways, egress и remote access.

Сильная сторона — использование kernel WireGuard и ориентация на производительный L3 overlay.

UDP/443 в конфигурации WireGuard остаётся UDP. TCP/443 у Netmaker — UI, API и служебные каналы, а не универсальный data fallback. При сравнении редакций отдельно смотрят failover, расширенные ACL и observability.

Nebula

Nebula использует собственный зашифрованный UDP overlay, сертификаты и локальный firewall. Lighthouses помогают участникам найти друг друга, но не обязаны пропускать data plane.

Можно указать несколько lighthouses. Для сложного NAT существуют UDP relays. Управление в большей степени файловое и распределённое: нет обязательной тяжёлой панели и центральной базы для каждого изменения.

Это нравится тем, кто предпочитает понятные конфиги и PKI. Обратная сторона — больше собственной автоматизации, а полный запрет UDP не переживается штатным TCP fallback. Несколько lighthouses — это HA discovery, а не HA data plane.

ZeroTier

ZeroTier предоставляет виртуальный Ethernet-порт поверх зашифрованной P2P-сети. Это делает его удобным там, где нужна L2-подобная модель, multicast или подключение приложений, ожидающих обычный сетевой интерфейс.

Для discovery используются публичные root servers (planet). Private moons официально deprecated и для новых внедрений не рекомендуются. Политики применяются распределённо на endpoints. При проблемах с UDP разворачивают отдельный TCP relay через HTTPS — это не тот же механизм, что UDP-ретрансляция через roots.

С версии 1.16 контроллер больше не входит в дефолтные пакеты по умолчанию: self-host control plane возможен, но это отдельное решение по поставке и лицензии.

OpenZiti

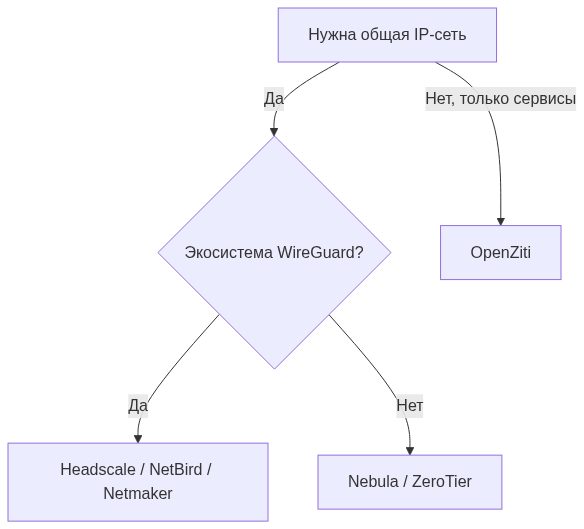
OpenZiti стоит в другой колонке. Он не обязан создавать общую IP-сеть между устройствами. Пользователь или приложение получает доступ к разрешённому сервису через fabric routers.

Есть tun/tproxy intercept, но это не делает OpenZiti IP-mesh в смысле WireGuard.

Преимущества:

  • identity-based policy;
  • сервисы не требуется публиковать в обычной IP-сети;
  • endpoints инициируют исходящие соединения;
  • edge router может использовать TCP/443;
  • контроллеры поддерживают RAFT-кластер.

Цена — более сложная архитектура и иной способ мышления. Это не «быстро заменить WireGuard», а построить сервисный overlay.

Короткая матрица

Решение Модель Оба узла за NAT Relay Data fallback через TCP/443 HA управления
Headscale WireGuard L3 да DERP отдельно от control plane да нет active-active
NetBird WireGuard L3 да да QUIC / запасной WebSocket Community: нет; Enterprise: да
Netmaker WireGuard L3 условно gateway/relay нет штатного TCP data fallback Pro/внешнее
Nebula собственный L3 условно UDP relay нет несколько lighthouses
ZeroTier виртуальный Ethernet да UDP через roots + отдельный TCP relay отдельный TCP relay зависит от схемы
OpenZiti сервисный overlay да fabric routers TCP/443 RAFT-кластер

Полная таблица — в tables/solution-matrix.md. Оценки архитектурные, до лаборатории.

Как выбирать

Небольшой self-hosted tailnet: Headscale.

Современная панель, identity и хорошие relay-механизмы: NetBird.

Производительный WireGuard site-to-site/full mesh: Netmaker, но с проверкой редакции.

Минимум центральной панели и собственная PKI: Nebula.

Нужна виртуальная Ethernet-модель: ZeroTier.

Доступ строится вокруг сервисов и identity, а не общей IP-сети: OpenZiti.

Окончательный выбор делаем не по таблице возможностей, а после лаборатории: два CGNAT, запрет UDP, потеря контроллера, отказ relay и измерение рабочего MTU.

Где это ломается

  • Панель зелёная, а data plane сидит на далёком relay.
  • Community принимают за HA, потому что «есть Postgres».
  • UDP/443 Netmaker записывают как HTTPS fallback.
  • Private moon ZeroTier поднимают как актуальный способ self-host discovery.
  • OpenZiti сравнивают с WireGuard mesh как с взаимозаменяемыми продуктами.

В следующей части те же оси — уровень, VTEP, control plane — появятся в фабрике ЦОД, уже без mesh-панели.

Предыдущая часть: «Шифрование в SDN: MACsec, IPsec, WireGuard и mTLS»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «SDN в ЦОД: spine-leaf, EVPN/VXLAN и OVN»
Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 8. Предыдущая часть: «NAT, CGNAT и ограниченные сети: где заканчивается прямая связность».

Ось: шифрование.

Шифрование — не переключатель «безопасно». Нужно знать границы защищённого участка.

MACsec

MACsec защищает Ethernet между непосредственно соединёнными устройствами на конкретном линке. Это hop-by-hop, а не шифрование всего VLAN.

Он полезен для межкоммутаторных и серверных линков в контролируемой инфраструктуре. Глобальную overlay-сеть и NAT traversal MACsec не строит. На каждом маршрутизируемом переходе граница шифрования заканчивается.

IPsec

IPsec работает на L3. ESP защищает содержимое IP-пакета, tunnel mode добавляет внешний IP-заголовок. IKE управляет согласованием ключей.

Для NAT применяется NAT-T, обычно UDP/4500. IPsec широко поддерживается маршрутизаторами и аппаратным ускорением, удобен для site-to-site и нормативно закреплённых решений.

Цена — сложная матрица режимов, предложений (proposals), сроков жизни ключей, сертификатов и поведения разных вендоров. Когда туннель не поднялся, журнал часто уверен, что администратор уже знает все аббревиатуры.

WireGuard

WireGuard использует компактную модель публичных ключей и UDP. Он хорошо подходит как защищённый L3 data plane между узлами.

Сам протокол не содержит полноценного управления участниками, выдачи адресов, ACL, NAT discovery и relay. Эту часть добавляют Tailscale, Headscale, NetBird, Netmaker и другие системы.

WireGuard не маскирует протокол и не поддерживает TCP mode. Это осознанное архитектурное решение.

mTLS

mTLS взаимно аутентифицирует приложения или сервисные proxies. Защищается конкретное соединение между нагрузками, а решение о доступе может приниматься по identity сервиса, а не IP-адресу.

Это сильная модель для микросервисов и service mesh, но она не заменяет базовую IP-связность. Сначала пакету всё равно нужно добраться до удалённой стороны.

Шифрование поверх overlay

Возможны варианты:

  1. Native routing и WireGuard между узлами.
  2. IPsec между площадками, внутри — обычный VXLAN.
  3. VXLAN/Geneve между узлами и прозрачное WireGuard-шифрование поверх.
  4. Приложение использует mTLS, а межузловой транспорт дополнительно защищён IPsec.

Cilium в tunnel mode сначала помещает pod-трафик в VXLAN/Geneve, затем шифрует межузловой поток WireGuard. Получается двойная инкапсуляция.

В native routing Cilium может шифровать WireGuard без VXLAN/Geneve: тогда налог один, а не два. WireGuard не всегда заменяет tunnel protocol — это отдельный переключатель.

Двойная инкапсуляция работает, но внешний MTU должен вместить оба слоя. Если underlay имеет MTU 1500, MTU нагрузки придётся уменьшить сильнее, чем при одном VXLAN. Цифры накладных расходов — в части 2.

Кто хранит ключи

При ручном WireGuard ключи создаются на узлах, а публичные части распространяются администратором.

В управляемом mesh контроллер хранит или распространяет публичную информацию, policy и сроки действия. Приватный ключ должен оставаться на endpoint.

Нужно проверить:

  • как добавляется новый узел;
  • можно ли быстро отозвать потерянное устройство;
  • как ротируются ключи;
  • что происходит при недоступном identity provider;
  • может ли контроллер выдать peer лишней группе;
  • применяются ли ACL локально с обеих сторон.

Шифрование и наблюдаемость

Внешний firewall видит адреса конечных точек туннеля, объём и время трафика, но не внутренние порты и назначения. Это хорошо для конфиденциальности и неудобно для старых средств анализа.

Наблюдаемость приходится переносить внутрь endpoints: flow logs, eBPF/Hubble, журналы policy engine и метрики туннеля.

Производительность

На современных CPU WireGuard обычно быстр, IPsec может использовать аппаратное AES-ускорение и offload. Но результат зависит от:

  • размера пакетов;
  • PPS;
  • числа участников;
  • ядра и драйвера;
  • наличия GRO/GSO/TSO;
  • NUMA и размещения очередей;
  • двойной инкапсуляции.

Сравнивать только гигабиты в одном iperf3 недостаточно. Нужны ещё PPS, latency, CPU и поведение при нескольких потоках.

Где это ломается

  • «Зелёный замок» в панели, а пакет открыт до VTEP или внутри хоста.
  • MACsec принимают за защиту всей L2-сети, а не линка.
  • Cilium tunnel + WireGuard включают без уменьшения MTU.
  • Приватные ключи оказываются на контроллере или в общем хранилище конфигов.
  • Шифрование путают с политикой доступа: зашифрованный запрещённый поток всё равно должен отбрасываться.

В следующей части соберём эти свойства в продуктовую матрицу и сравним self-hosted mesh-решения.

Предыдущая часть: «NAT, CGNAT и ограниченные сети: где заканчивается прямая связность»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Self-hosted mesh: Headscale, NetBird, Netmaker, Nebula, ZeroTier и OpenZiti»

Схема

#network #selfhosting

Обложка

Цикл «Виды связности и SDN», часть 7. Предыдущая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh».

Ось: underlay с ограничениями (NAT, CGNAT, фильтрация).

Фраза «работает за NAT» звучит уверенно, но описывает слишком много разных ситуаций.

Если сервер имеет белый адрес, а клиент находится за домашним роутером, достаточно исходящего соединения клиента и сохранения NAT mapping. Если оба участника за CGNAT, ни к одному нельзя сделать обычный port forwarding. Если обе стороны находятся за symmetric NAT, внешний порт может зависеть от назначения, и простого обмена наблюдаемыми адресами недостаточно.

Отдельно проверяют hairpin NAT: два узла за одним и тем же маршрутизатором часто не могут достучаться друг до друга по внешнему адресу, пока устройство не умеет возвращать такой трафик внутрь.

Ещё одна ловушка адресации: диапазон 100.64.0.0/10 занят и операторским CGNAT (RFC 6598), и многими mesh — Tailscale и Headscale по умолчанию живут в нём же. Если адреса overlay пересекаются с underlay, маршруты ломаются неочевидно.

NAT mapping и keepalive

Stateful NAT запоминает исходящий поток и временно разрешает обратные пакеты. Когда трафика нет, запись удаляется.

WireGuard умеет отправлять PersistentKeepalive, чтобы mapping не исчезал. Но чистый WireGuard не содержит центрального механизма знакомства двух неизвестных участников, автоматического hole punching и relay. Как минимум одна сторона должна иметь известный достижимый endpoint либо нужен внешний координатор.

Если у узла сменился внешний адрес и он отправил пакет первым, пир WireGuard может обновить endpoint по входящему пакету. Это roaming, а не NAT traversal для двух неизвестных сторон.

STUN, ICE и hole punching

Полезно разделять mapping и filtering — так делает RFC 4787. Hole punching обычно ломается на address-and-port-dependent mapping: внешний порт зависит от назначения. Endpoint-independent mapping при более строгом filtering часто всё же пробивается взаимными проверками.

STUN помогает узлу узнать, какой внешний адрес и порт видит сервер в Интернете. Сам по себе STUN путь не строит. ICE добавляет взаимные проверки связности. Если прямой путь не получается, нужен ретранслятор: в IETF это TURN, в продуктах — DERP, NetBird Relay или отдельный TCP relay.

Controller или signal service обменивает наблюдаемые адреса между участниками. Затем оба почти одновременно отправляют UDP друг другу, создавая подходящие состояния NAT.

При обычном NAT это часто даёт прямое соединение. При address-and-port-dependent mapping — не всегда.

Relay

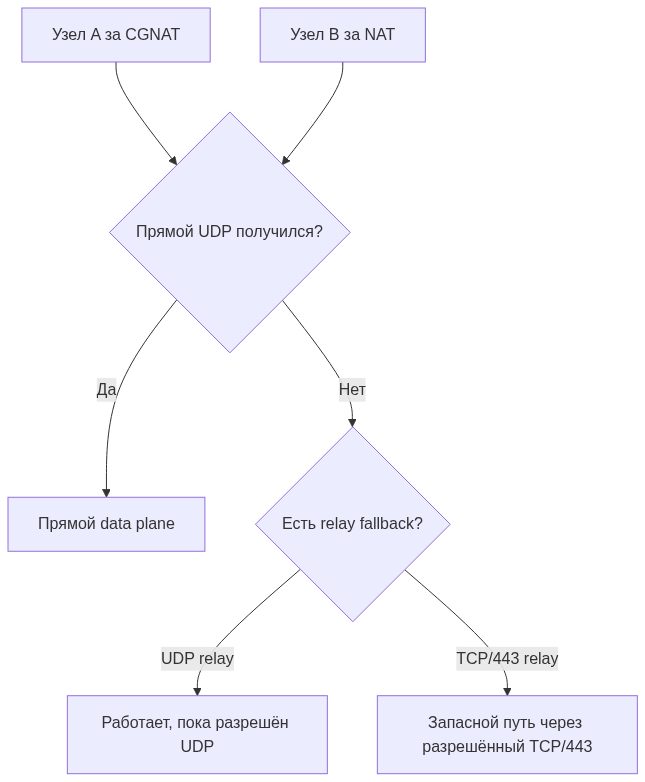
Если прямой путь не построен, оба участника устанавливают исходящие соединения к публичному relay. Он пересылает уже зашифрованные пакеты и не обязан знать их содержимое.

Relay повышает вероятность связности, но добавляет:

  • дополнительную задержку;
  • ограничение пропускной способности;
  • расходы на сервер и трафик;
  • новую точку отказа;
  • зависимость от адреса и транспорта relay.

Поэтому важно резервировать relay и уметь видеть, какая пара работает напрямую, а какая через него.

UDP/443 не является HTTPS

Номер 443 не превращает произвольный протокол в веб-трафик.

WireGuard на UDP/443 остаётся WireGuard по UDP. Сеть, в которой разрешён только TCP/443, его не пропустит. Межсетевой экран с анализом протокола также не обязан доверять пакету только из-за номера порта.

Настоящий fallback через TCP/443 означает, что data plane умеет работать поверх разрешённого TCP-транспорта — например HTTPS, TLS или WebSocket. Это повышает совместимость с жёсткими egress-правилами, но не гарантирует работу при белых списках, блокировке домена, SNI или адреса сервиса.

Как ведут себя разные семейства решений

Tailscale пытается построить прямой WireGuard-путь по UDP, а при неудаче использует DERP через TCP/443.

Headscale применяет те же клиенты; можно использовать публичные DERP или собственный сервер. Сам Headscale остаётся control plane, а не обязательным транзитом данных и не содержит DERP внутри бинарника.

NetBird использует STUN/ICE для прямых соединений и собственный relay. Основной транспорт relay — QUIC, запасной — WebSocket при недоступном UDP.

Nebula умеет hole punching и UDP relay. Такой relay помогает при сложном NAT, но для его работы UDP всё равно должен проходить.

ZeroTier преимущественно строит P2P по UDP; публичные roots могут и обнаруживать, и ретранслировать. Для сетей без UDP отдельно разворачивают TCP relay через HTTPS — это другой компонент, не «тот же root на порту 443».

Netmaker автоматизирует WireGuard и умеет работать с gateway/relay, но UDP/443 в конфигурации остаётся UDP и не является универсальным TCP fallback.

OpenZiti использует другую модель: endpoints подключаются к публичным edge routers, а трафик проходит через fabric. Это не direct mesh, зато TCP/443 является штатным транспортом edge listener.

Почему нельзя поставить вечную галочку «проходит ТСПУ»

ТСПУ и белые списки применяются неодинаково у разных операторов и в разных регионах. Правила меняются. Могут ограничиваться:

  • весь UDP;
  • отдельные сигнатуры;
  • адреса публичных контроллеров и relay;
  • DNS;
  • SNI или домены;
  • соединения, не соответствующие разрешённому приложению.

Поэтому вместо рекламной галочки нужно фиксировать свойства:

  1. Нужен ли произвольный UDP?
  2. Может ли data plane перейти на TCP/443?
  3. Можно ли поднять собственные контроллер, STUN и relay?
  4. Что продолжает работать после потери контроллера?
  5. Какие адреса и домены обязательны?
  6. Когда, где и на каком операторе проводился тест?

Цель такой проверки — диагностика и обеспечение разрешённой корпоративной связности, а не обещание универсального обхода ограничений.

Наша лаборатория

Каждое решение нужно прогонять через одинаковые профили: оба узла за CGNAT, hairpin за одним NAT, symmetric NAT, полный запрет UDP, только TCP/80/443, отказ основного relay, потеря контроллера, смена внешнего адреса во время SSH-сеанса и PMTUD black hole. Полный список — в программе испытаний.

В итоговой таблице появятся не мнения, а наблюдаемые результаты: прямой путь или relay, время установления, failover, RTT, throughput и рабочий MTU.

Где это ломается

  • «Работает за NAT» проверяли, когда одна сторона была с белым адресом.
  • Symmetric NAT / EDM путают с обычным masquerade; STUN есть, прямого пути нет.
  • Два ноутбука в одном офисе не видят друг друга из-за hairpin NAT.
  • UDP/443 принимают за HTTPS и удивляются при запрете UDP.
  • Overlay-адреса из 100.64.0.0/10 пересекаются с CGNAT оператора.

В следующей части разберём шифрование: от MACsec до WireGuard и mTLS, а также цену двойной инкапсуляции.

Предыдущая часть: «Топологии связности: hub-and-spoke, partial mesh и full mesh»

Оглавление цикла: «SDN без магии: карта видов связности»

Следующая часть: «Шифрование в SDN: MACsec, IPsec, WireGuard и mTLS»

Схема

#network #selfhosting

Цикл «Не светим лишнего». Выпуск 15.

Теоретическая схема у нас уже есть. Теперь полезно собрать маленький стенд, который можно без жалости ломать. Не надо сразу подключать боевой WinBox, IPMI и камеры. Сначала докажем, что доступ правильно открывается и, что гораздо важнее, правильно закрывается.

Что понадобится

На границе ставим MikroTik с RouterOS 7. У него есть WAN и отдельная защищаемая сеть, например VLAN protected-lab.

В защищаемой сети размещаем три разных ресурса:

  • простой HTTP-сервис на 443;
  • Linux-хост или контейнер с SSH;
  • Windows VM или тестовый RDP-сервис.

Снаружи доступен только HTTPS-портал. Его административная часть слушает внутренний management-интерфейс или дополнительно закрыта firewall. RouterOS API доступен лишь worker с фиксированного управленческого адреса.

Сам портал удобно разделить на компоненты:

  • backend проверяет TOTP и создаёт сессии;
  • PostgreSQL хранит токены, профили, владельцев и историю;
  • Redis хранит живые WebSocket-сессии и короткое оперативное состояние;
  • worker синхронизирует активные разрешения с MikroTik;
  • reverse proxy завершает TLS и проксирует WebSocket.

Для первого запуска всё это можно поднять на одной Linux VM в контейнерах. Разделение здесь логическое: позже компоненты получится разнести, не переписывая модель доступа.

Профили лаборатории

Не создаём универсальный список trusted. Заводим три роли.

lab-web разрешает только HTTPS к тестовому веб-сервису.

lab-ssh разрешает только TCP/22 к одному Linux-хосту.

lab-support разрешает HTTPS, SSH и RDP к конкретным тестовым адресам, но не ко всей VLAN.

Каждый TOTP-токен связан с одной или несколькими ролями. Пользователь не вводит destination вручную. На MikroTik заранее лежат правила, которые ссылаются на эти address-list.

Жизненный цикл сессии

Пользователь открывает портал и вводит TOTP. Backend проверяет код, срок действия токена, лимит попыток и разрешённые роли. Затем создаёт сессию с абсолютным максимумом, например два часа.

Браузер открывает WebSocket. Пока он жив, Redis содержит активную ссылку на пару внешний IP + роль. Worker раз в несколько секунд вычисляет нужное состояние и добавляет на MikroTik динамическую запись с timeout 60–90 секунд.

При штатном завершении worker удаляет запись сразу. Если любой компонент пропал, MikroTik сам удалит её по timeout. Это и есть fail closed.

Что проверять по шагам

1. Нулевое состояние. Без TOTP все три ресурса недоступны. Проверяем не только браузером, но и nmap, SSH и RDP-клиентом. Публичный портал при этом доступен.

2. Разные роли. Токен lab-web не должен открыть SSH. lab-ssh не должен дать RDP. Проверяем реальные правила, а не только подпись на странице.

3. Истечение времени. Не закрываем вкладку и ждём абсолютный максимум. Сессия обязана завершиться, даже если heartbeat продолжает идти.

4. Закрытие вкладки. При штатном WebSocket close доступ снимается быстро. Затем повторяем жёстко: убиваем браузер, отключаем сеть, усыпляем ноутбук. В этих случаях ждём окончания короткого lease.

5. Два пользователя за одним NAT. Открываем две сессии с одного публичного IP. Закрываем первую. Доступ второй роли обязан сохраниться. Закрываем последнюю — соответствующая запись исчезает.

6. Одинаковая роль за одним NAT. Две сессии требуют lab-ssh. После закрытия одной счётчик остаётся равным единице, и SSH не пропадает у второй.

7. Уже установленный SSH. Открываем соединение, затем отзываем сессию. Если терминал продолжает работать, значит порядок established,related, FastTrack или очистка connection tracking настроены неправильно.

8. Падение портала. Останавливаем backend и Redis. Новые доступы не выдаются, существующие исчезают после timeout. Никаких постоянных записей на MikroTik остаться не должно.

9. Потеря RouterOS API. Worker должен показать ошибку и не считать сессию успешно применённой. Старые leases естественно истекают.

10. Перезапуск worker. После запуска он восстанавливает правильное состояние из активных сессий, а не доверяет случайно оставшимся firewall-записям.

11. Смена внешнего IP. Переключаем сеть или внешний VPN. Старый адрес закрывается по lease. Новый не получает права автоматически без повторного подтверждения.

12. Рассинхронизация времени. Уводим часы портала и убеждаемся, что мониторинг NTP ловит проблему. TOTP очень не любит творческое отношение ко времени.

Плюсы такого стенда

  • можно проверить спорные места до боевого внедрения;
  • правила ресурсов отделены от логики токенов;
  • легко сравнить фиксированный timeout и heartbeat;
  • видны нагрузки на RouterOS API и worker;
  • получается готовый набор интеграционных тестов;
  • стенд потом можно превратить в dev-контур решения.

Минусы

  • лаборатория не воспроизводит все виды CGNAT и мобильных сетей;
  • Docker на одной VM скрывает проблемы высокой доступности;
  • тестовые сервисы проще реальных старых панелей;
  • права RouterOS API всё равно придётся отдельно минимизировать и изолировать;
  • для промышленной эксплуатации нужны резервирование, мониторинг и резервные копии.

Где можно больно ошибиться

Тестировать только успешный вход. Самые важные сценарии — падение, отзыв и рассинхронизация.

Использовать боевые TOTP-секреты. Лаборатория должна иметь отдельные токены, ключи API, адреса и сертификаты.

Дать worker полный RouterOS admin. Даже в стенде стоит сразу строить отдельную учётку и management-доступ. Иначе опасная привычка доедет до production.

Считать состояние Redis единственной истиной. На точке применения всегда есть собственный короткий timeout. Потеряли оперативную базу — доступ закрывается.

Не собирать журнал. Для каждой записи нужны ID сессии, токен, роль, внешний IP, время создания, продления и причина закрытия.

Забыть IPv6. Если тестовый ресурс имеет глобальный IPv6 в обход MikroTik-политики, идеальный IPv4 heartbeat ничего не защищает.

Что получится в финале

После этих проверок у нас будет не просто страница с шестью цифрами, а понятный механизм: заранее проверенные группы ресурсов, временные роли, короткие firewall leases, живые браузерные сессии и гарантированный fail closed.

Дальше уже можно делать второй, практический цикл: конкретная схема БД, API портала, конфигурация RouterOS, Docker Compose и автоматические тесты. Но это будет отдельная инженерная работа, а не ещё одна статья в духе «добавьте правило accept и всё готово».

Ранее в цикле

Документация и источники

#network

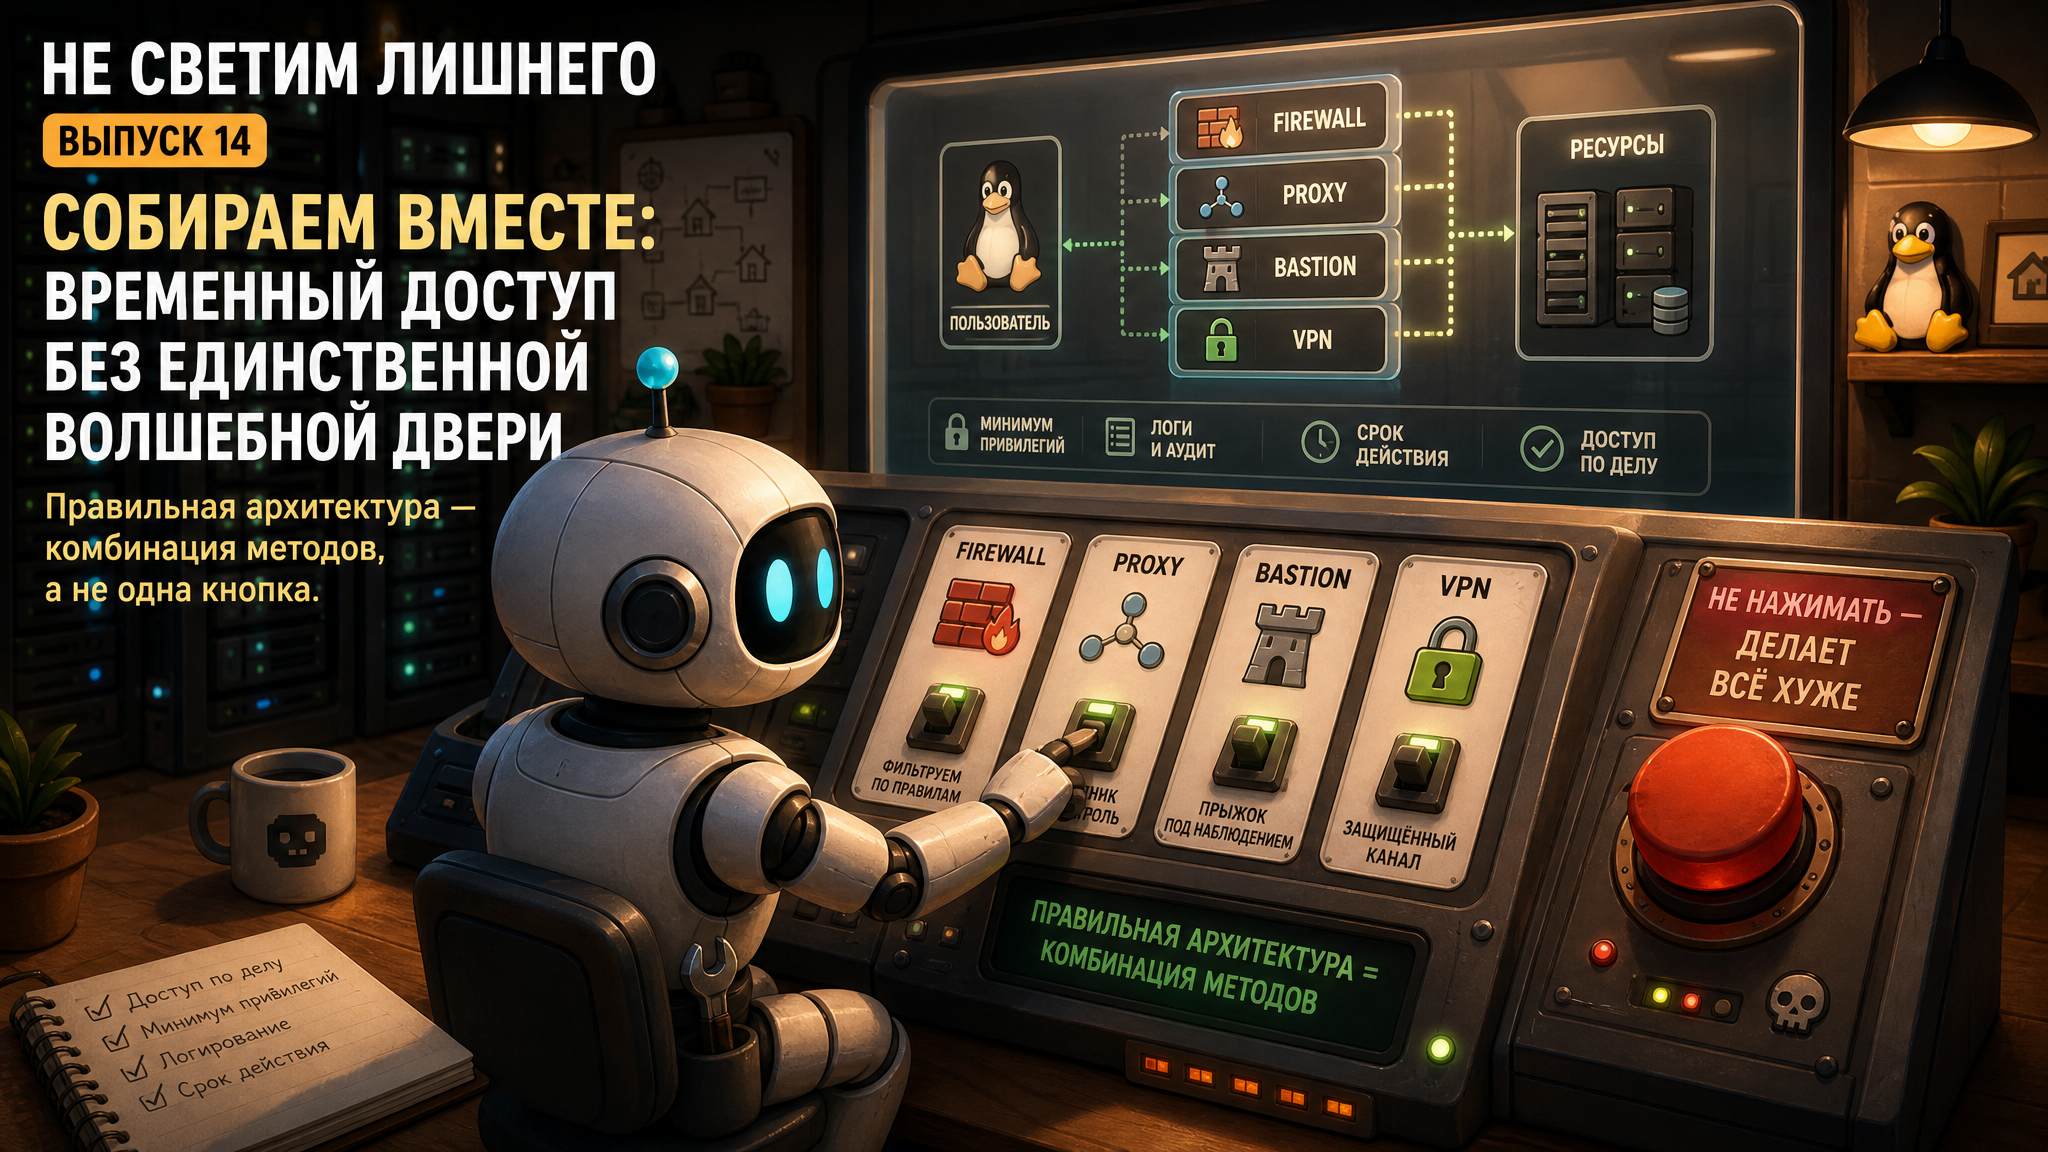
Цикл «Не светим лишнего». Выпуск 14.

За предыдущие выпуски мы накопили приличный набор инструментов. Было бы странно теперь выбрать один и заставить его защищать вообще всё.

HTTP-панель, RDP подрядчика, IPMI, dev-база и доступ филиала — разные задачи. Им нужны разные точки входа, но единая логика выдачи прав.

Один контроллер, несколько точек применения

В центре находится контроллер политики. Он хранит пользователей или токены, роли, группы ресурсов, сроки и активные сессии. Сам трафик через него идти не обязан.

Решение применяется там, где это удобнее:

  • MikroTik или другой firewall управляет L3/L4-доступом;
  • reverse proxy проверяет пользователя перед HTTP-приложением;
  • Guacamole проводит индивидуальные RDP/SSH/VNC-сессии;
  • VPN-шлюз даёт полноценную приватную связность;
  • SPA или port knocking остаётся резервным техническим входом.

В терминах Zero Trust это иногда называют Policy Decision Point и Policy Enforcement Point. По-человечески: один компонент решает, другой стоит у двери и исполняет решение.

Как разложить ресурсы

Корпоративные веб-системы. Reverse proxy + OIDC/MFA. Если приложение особенно чувствительное, дополнительно короткий IP allow-list.

Dev- и test-контуры. TOTP + heartbeat открывает только адреса и порты конкретного проекта. Веб-интерфейсы при этом могут идти через proxy.

RDP и SSH подрядчиков. Web-bastion, без прямого внешнего NAT. Отключённая передача файлов, персональная учётка, при необходимости запись.

Нативные инструменты администраторов. TOTP + heartbeat или персональный VPN. Выбор зависит от того, нужны ли приватные адреса и много маршрутов.

IPMI, iDRAC, iLO, гипервизоры. Не публиковать напрямую. Bastion или управляемый VPN из отдельного административного сегмента.

Филиалы и системные интеграции. Статические allow-list и site-to-site VPN, потому что источник стабилен и является системой, а не случайным человеком.

Гостевой и технологический Wi‑Fi. Captive portal выдаёт базовую роль; дополнительный TOTP включает инженерную группу на время работ.

Аварийный доступ. Персональный SPA либо отдельный knocking-профиль с коротким timeout, журналом и собственной авторизацией конечного сервиса.

Пример ролей

monitoring — HTTPS к Grafana и Zabbix, без доступа к серверам.

developer-project-a — SSH к двум dev-хостам, HTTPS к registry и тестовой панели.

cctv-contractor — Guacamole-подключение к сервисной машине и web-доступ только к камерам нужного объекта.

incident-admin — расширенная роль максимум на два часа, с обязательным TOTP и уведомлением ответственному.

infrastructure-core — только с корпоративного устройства через сертификатный VPN и bastion.

Плюсы комбинированной схемы

  • каждый ресурс получает подходящий способ защиты;
  • нет единого широкого сетевого входа для всех;
  • права описываются ролями и группами ресурсов;
  • временность и отзыв работают единообразно;
  • можно внедрять постепенно;
  • отказ одного способа не требует раскрывать весь периметр.

Минусы

  • компонентов больше, чем у одного VPN;
  • нужна нормальная инвентаризация ресурсов;
  • журналы придётся собирать из нескольких точек;
  • роли могут разъехаться между proxy, firewall и bastion;
  • контроллер политики становится важной внутренней системой.

Где можно больно ошибиться

Fail open. При падении контроллера старые короткие leases должны истечь, а новые — не выдаваться. Никакого «временно разрешим всем, пока база не вернулась».

Разные источники истины. Если роль удалена в портале, но осталась вручную на firewall, отзыв не работает. Ручные исключения либо запрещаем, либо регулярно сверяем.

Слишком крупные роли. admin-all быстро становится единственной используемой группой. Роли строим вокруг работы и ресурса.

Нет отдельного management-контура. API firewall, база секретов и админка портала не должны быть доступны через тот же публичный путь, которым пользуется подрядчик.

Собрать всё сразу. Начинать лучше с инвентаризации, default deny и временных списков. Потом добавить портал, heartbeat, proxy и bastion по мере реальной необходимости.

Практичная первая версия

Для небольшой лаборатории хватит MikroTik, отдельного контейнера портала, PostgreSQL, Redis для живых сессий и reverse proxy. За MikroTik размещаем тестовые HTTP, SSH и RDP-ресурсы. Сначала включаем TOTP и фиксированный timeout, затем heartbeat и reference counting. Guacamole можно добавить вторым этапом.

На этом теория заканчивается. В следующем выпуске соберём лабораторный стенд: MikroTik, портал, TOTP, WebSocket, тестовые HTTP/SSH/RDP и набор проверок отказа. Потому что вся красота временного доступа проверяется не успешным входом, а тем, как он закрывается при падении половины компонентов.

Ранее в цикле

Документация и источники

#network

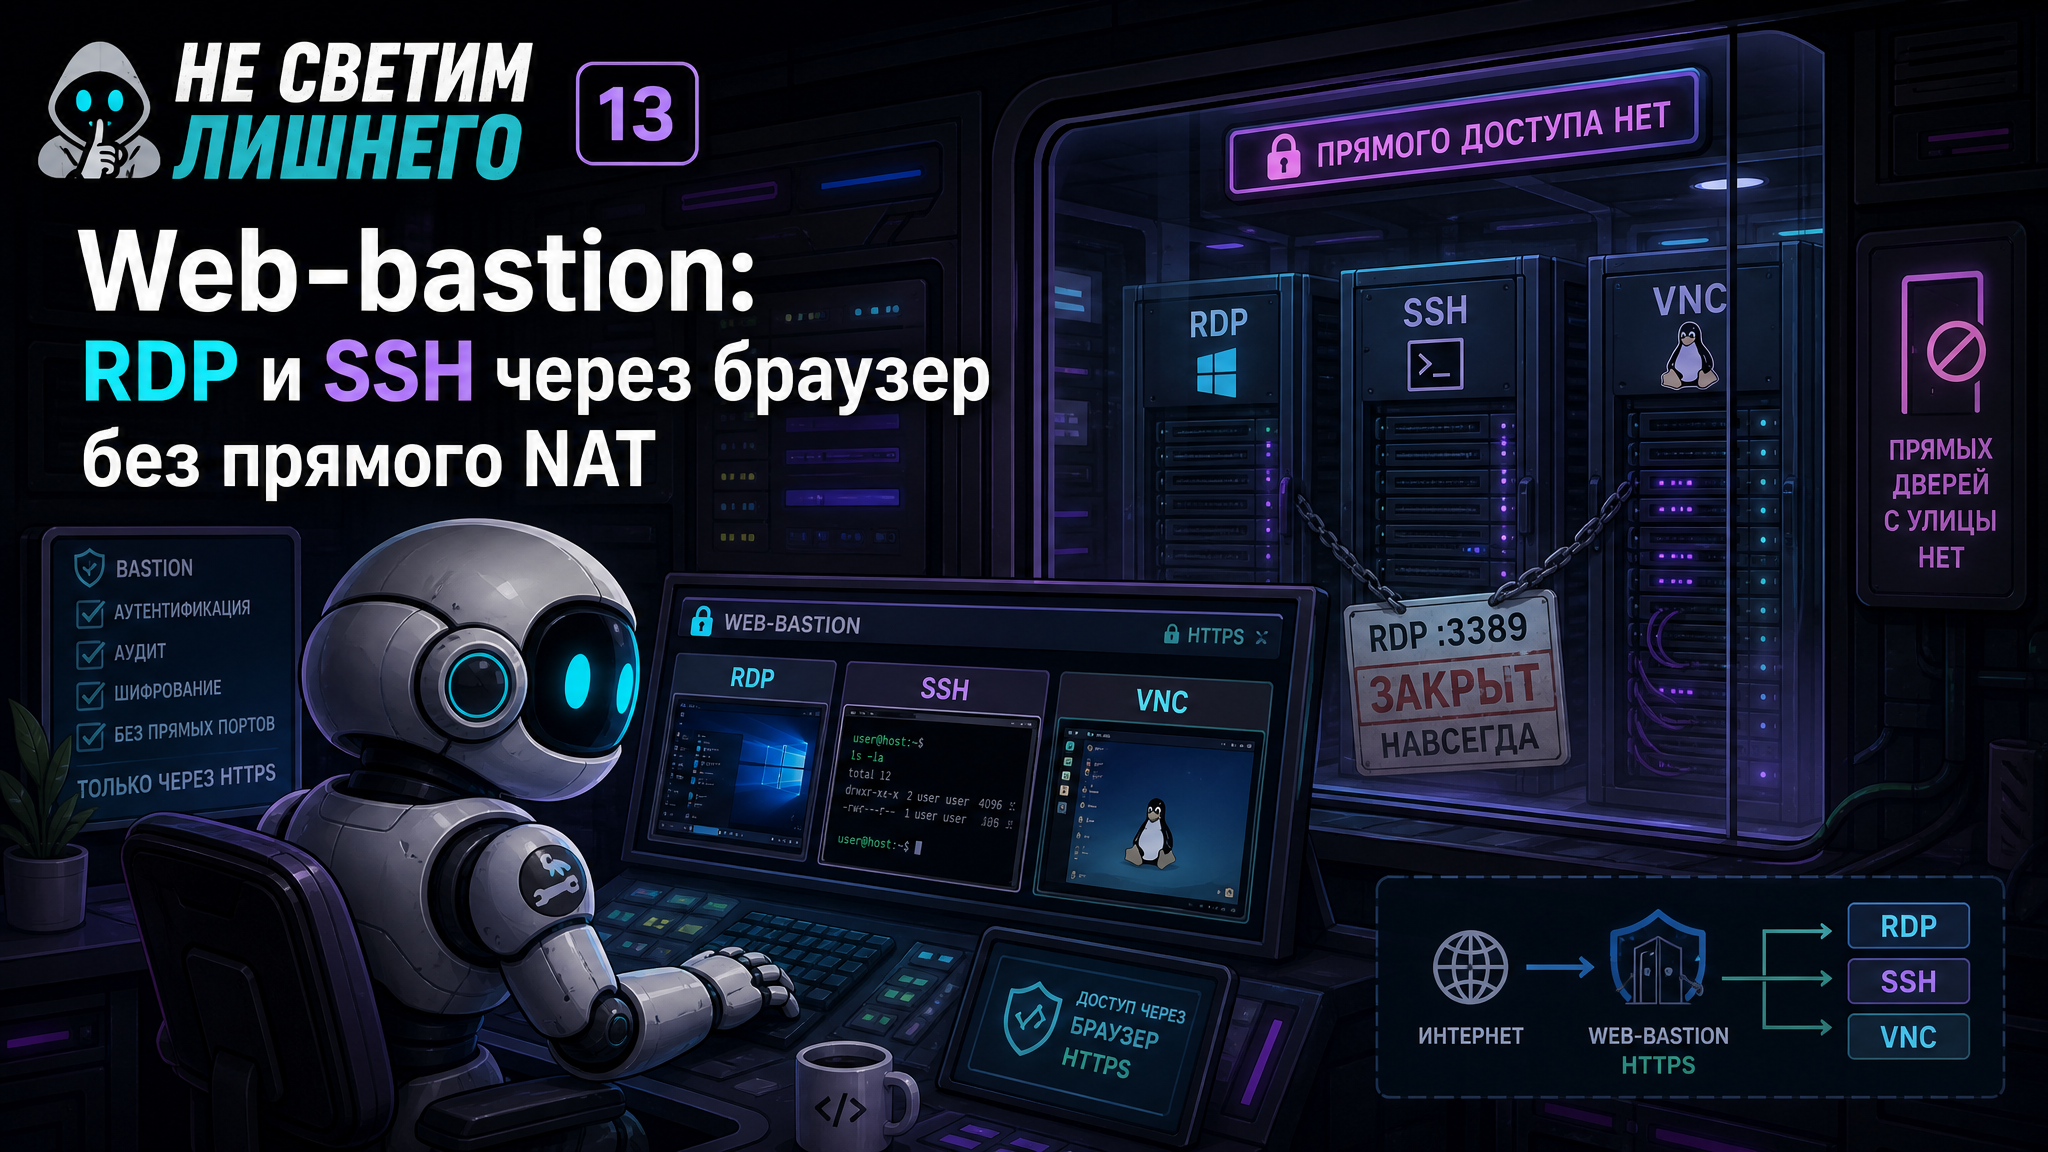
Цикл «Не светим лишнего». Выпуск 13.

Динамический allow-list хорош, но у него фундаментальное ограничение: после открытия firewall видит внешний IP. Если за ним сто человек, сетевой допуск получают все сто. Их ещё остановит авторизация целевого сервиса, но индивидуального сетевого коридора нет.

Для RDP, SSH и VNC можно не публиковать прямой коридор вообще. Пользователь входит на web-bastion, выбирает разрешённую машину и работает внутри браузера.

Как устроен Apache Guacamole

Apache Guacamole называют clientless remote desktop gateway. На пользовательском устройстве нужен только современный браузер.

Веб-приложение отвечает за интерфейс и авторизацию. Компонент guacd устанавливает настоящие RDP, SSH или VNC-соединения к внутренним узлам и переводит их в протокол, который понимает браузер.

Наружу опубликован только HTTPS самого Guacamole. Серверы Windows не имеют внешнего DNAT на 3389, а SSH-хосты — на 22. Между guacd и целевыми узлами действуют отдельные внутренние firewall-правила.

Что получаем кроме «работает в браузере»

Пользователь известен bastion по индивидуальной учётке, OIDC или LDAP. Ему можно показать только назначенные соединения. Общий NAT больше не мешает — действия проходят внутри отдельной веб-сессии.

Guacamole умеет управлять буфером обмена, передачей файлов, SFTP и записью графических сеансов. Это полезно для подрядчиков и чувствительного администрирования, если правила хранения и доступа к записям определены заранее.

Плюсы

  • никакого клиента и VPN-профиля;
  • внутренние RDP/SSH/VNC-порты не публикуются;
  • индивидуальная авторизация не зависит от внешнего IP;
  • единый список разрешённых подключений;
  • аудит и запись сеансов;
  • можно отключить clipboard и передачу файлов;
  • удобно выдавать временных пользователей.

Минусы

  • весь интерактивный трафик идёт через bastion;
  • задержка и производительность зависят от него;
  • не все сценарии толстых клиентов переносятся в браузер;
  • появляется критичная база подключений и прав;
  • сложнее обеспечить высокую доступность;
  • учётные данные целевых систем надо либо спрашивать, либо где-то хранить.

Где можно больно ошибиться

Выставить guacd наружу. Он должен быть доступен только веб-приложению по изолированной сети. Публичной точкой остаётся HTTPS.

Хранить общие админские пароли без защиты. Лучше персональные учётки на целевых системах, интеграция с каталогом или безопасное хранилище секретов.

Оставить всё включённым. Clipboard, drive redirection и загрузка файлов удобны, но для подрядчика могут стать каналом выноса данных или заноса исполняемых файлов.

Разрешить произвольные ad-hoc назначения. Если пользователь сам указывает любой ssh://10.x.x.x, bastion превращается в внутренний сканер. Нужны разрешённые ресурсы и сетевые ACL от guacd.

Записывать всё без правил. В записи могут оказаться персональные данные, пароли на экране и коммерческая информация. Определяем срок хранения, доступ и причину записи.

Забыть MFA и обновления. Bastion — единая внешняя дверь к множеству систем. Компрометация его учётки особенно неприятна.

Когда bastion лучше прямого доступа

Для подрядчиков, временной поддержки, администрирования с чужого устройства и доступа из общего NAT — почти всегда интереснее прямого DNAT. Постоянному сетевому инженеру иногда удобнее нативный SSH и WinBox; тогда TOTP + heartbeat может открыть узкий прямой доступ.

В финальной архитектуре эти способы не спорят: разные группы ресурсов проходят через разные точки применения политики.

Ранее в цикле

Документация и источники

#network

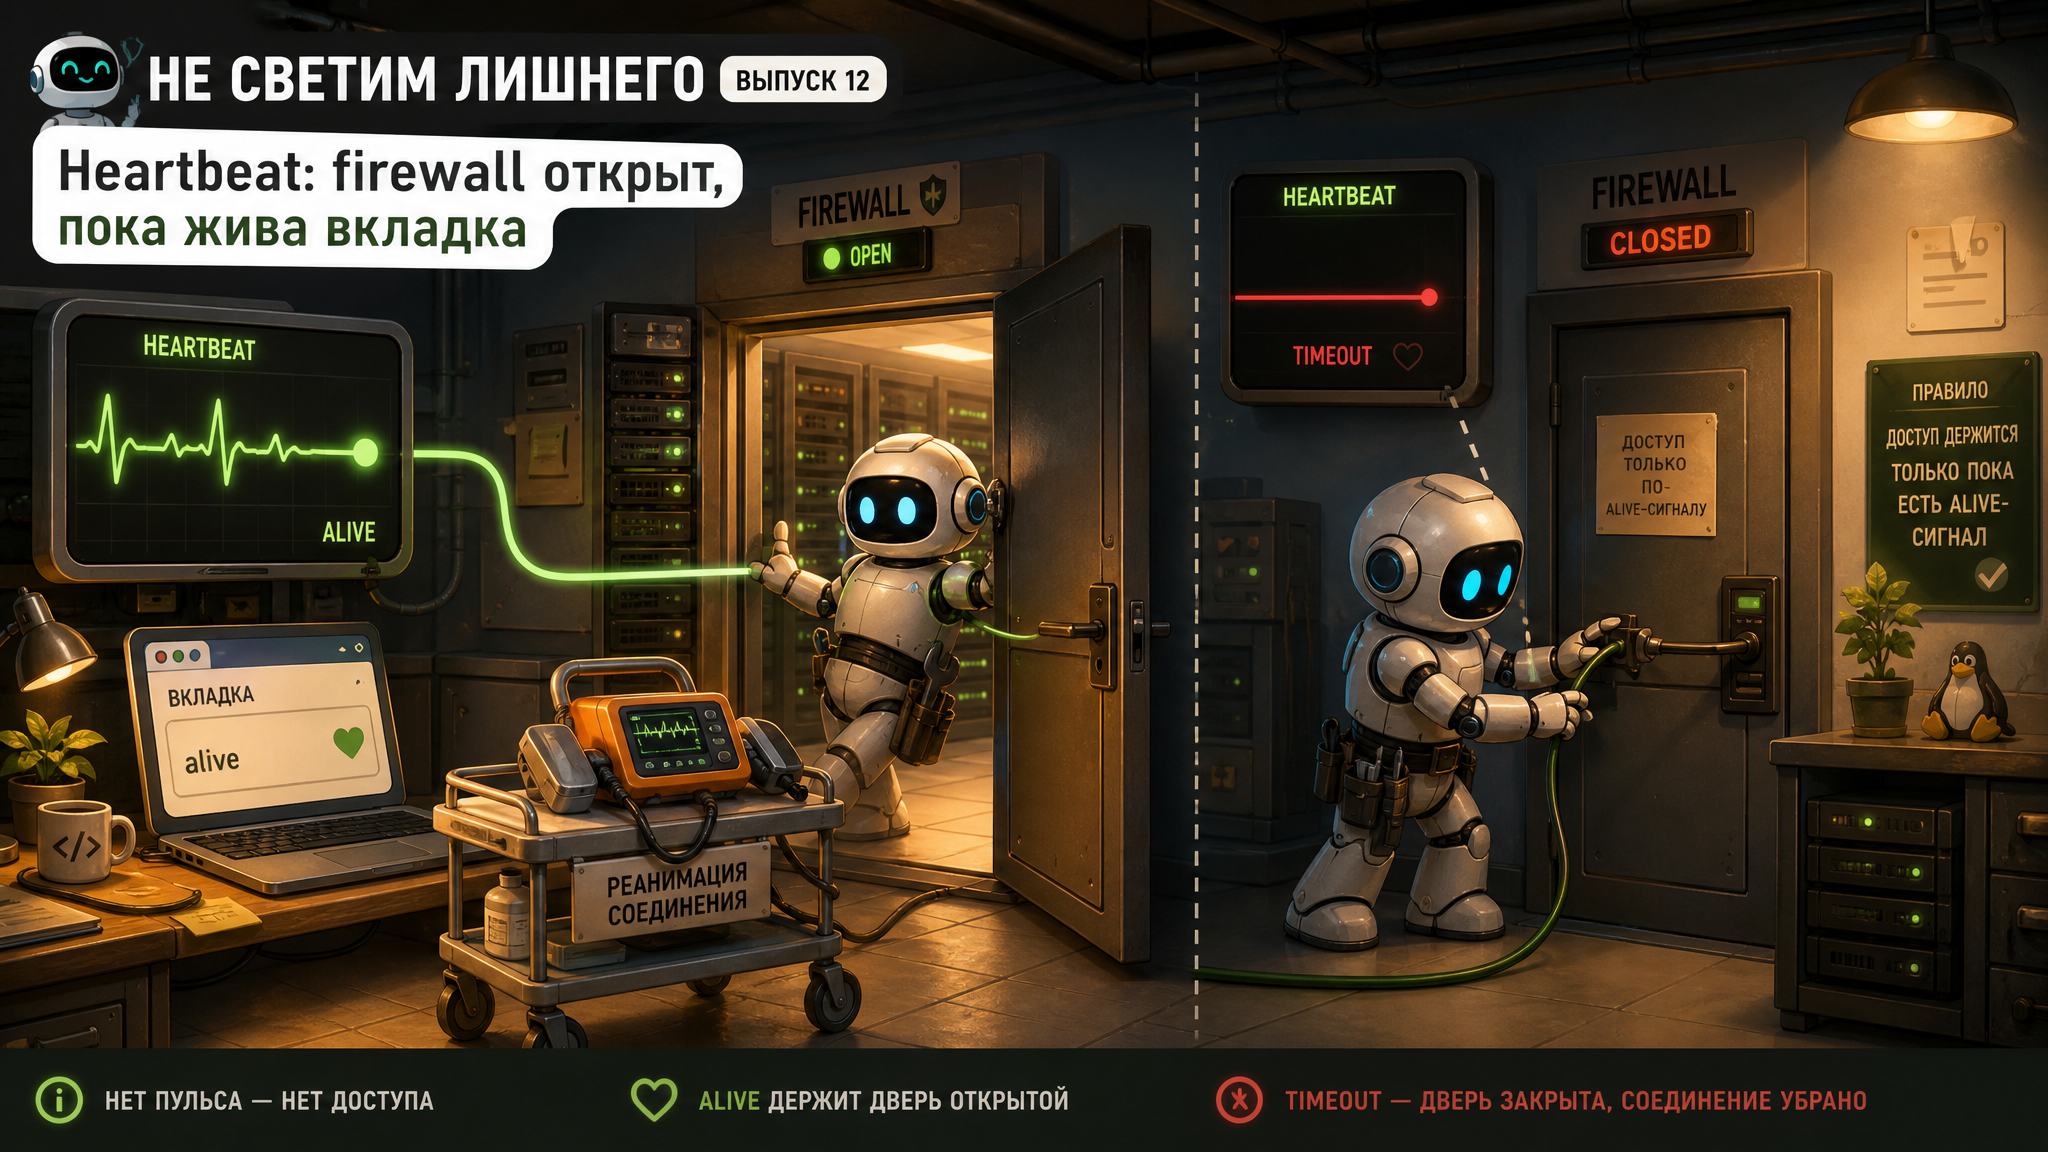
Цикл «Не светим лишнего». Выпуск 12.

Обычный временный доступ живёт по часам. Выдали на два часа — значит firewall будет открыт два часа, даже если человек закончил через десять минут.

А можно привязать lease не только ко времени, но и к живой браузерной сессии. После TOTP пользователь попадает на страницу «Доступ активен». Страница держит WebSocket с порталом. Пока соединение существует, контроллер регулярно продлевает короткую запись на firewall.

Закрыли вкладку — доступ снимается. Ноутбук уснул, сеть пропала, браузер завершился аварийно — lease не продлился и сам истёк.

Как подобрать интервалы

Практичная отправная точка:

  • сервер проверяет живость WebSocket или получает приложение heartbeat каждые 15–20 секунд;
  • запись firewall живёт 60–90 секунд;
  • два пропуска дают предупреждение;
  • через три-четыре пропуска сессия считается потерянной;
  • есть абсолютный максимум, например восемь часов;
  • кнопка «Закрыть доступ» отзывает сессию сразу.

Слишком короткий lease начнёт раздражать при любом мобильном провале. Слишком длинный убивает сам смысл heartbeat.

Лучше опираться не только на JavaScript-таймер фоновой вкладки: браузеры умеют их замедлять ради батареи. Сервер должен контролировать состояние WebSocket, протокольные ping/pong и время последнего подтверждения.

Несколько пользователей за одним NAT

Представим офис подрядчика. С одного публичного IP открыты две вкладки: у инженера доступ к камерам, у администратора — к мониторингу. Потом инженер закрывает свою вкладку.

Нельзя просто удалить этот IP из всех списков. Контроллер должен считать активные сессии отдельно и вести reference counting по ключу вроде:

пограничный шлюз + внешний IP + группа доступа.

Для access-cctv счётчик стал нулём — удаляем адрес только из CCTV-группы. Для access-monitoring остаётся единица — доступ администратора продолжает жить.

Если два пользователя с одного IP имеют одну роль, закрытие первой сессии уменьшает счётчик, но запись удаляется только после завершения второй.

Что происходит при смене IP

Мобильная сеть или другой VPN могут поменять внешний адрес. WebSocket обычно оборвётся. Автоматически переносить разрешение на новый IP опасно: лучше попросить повторное подтверждение TOTP или хотя бы явное действие в уже доверенной сессии.

Старый адрес при этом должен быстро исчезнуть по короткому lease.

Плюсы

  • доступ живёт ровно во время работы;
  • ничего не устанавливается;
  • не меняются маршруты и DNS;
  • подходит любым протоколам после открытия;
  • короткий lease обеспечивает fail closed;
  • можно показать пользователю понятный статус и кнопку отзыва.

Минусы

  • IP остаётся общей сетевой идентичностью;
  • общий NAT требует аккуратного учёта сессий;
  • вкладку надо держать открытой;
  • мобильные браузеры и энергосбережение могут рвать соединение;
  • кластер портала требует общего хранилища сессий;
  • логика отзыва сложнее обычного timeout.

Где можно больно ошибиться

Удалить доступ при закрытии одной вкладки, не проверив другие. Получим случайные обрывы у людей за одним NAT.

Доверять событию unload. Браузер не обязан успеть отправить его при падении или сне. Истинная страховка — короткий timeout на firewall.

Продлевать lease напрямую каждым heartbeat. При сотнях вкладок API маршрутизатора будут дёргать постоянно. Портал обновляет состояние в Redis/БД, а worker синхронизирует firewall с разумным интервалом.

Оставить established-соединения. Проверяем allow-list до общего accept established,related либо точечно чистим connection tracking при отзыве. Защищаемый трафик исключаем из FastTrack, если нужен немедленный разрыв.

Fail open при падении портала. Правило на firewall всегда имеет короткий timeout. Если контроллер умер, новые сессии не выдаются, старые естественно исчезают.

Считать WebSocket вторым фактором. Он подтверждает живость браузерной сессии, но не подписывает каждый SSH-пакет. На ресурсах остаётся своя авторизация.

Где эта схема особенно хороша

Временный доступ подрядчиков, dev-контуры, мониторинг, камеры, редкие административные панели — то есть всё, что желательно вообще не показывать без активного человека. Для особо опасных RDP и SSH можно пойти дальше и не открывать их напрямую даже после heartbeat, а проводить через web-bastion.

Ранее в цикле

Документация и источники

#network

Цикл «Не светим лишнего». Выпуск 11.

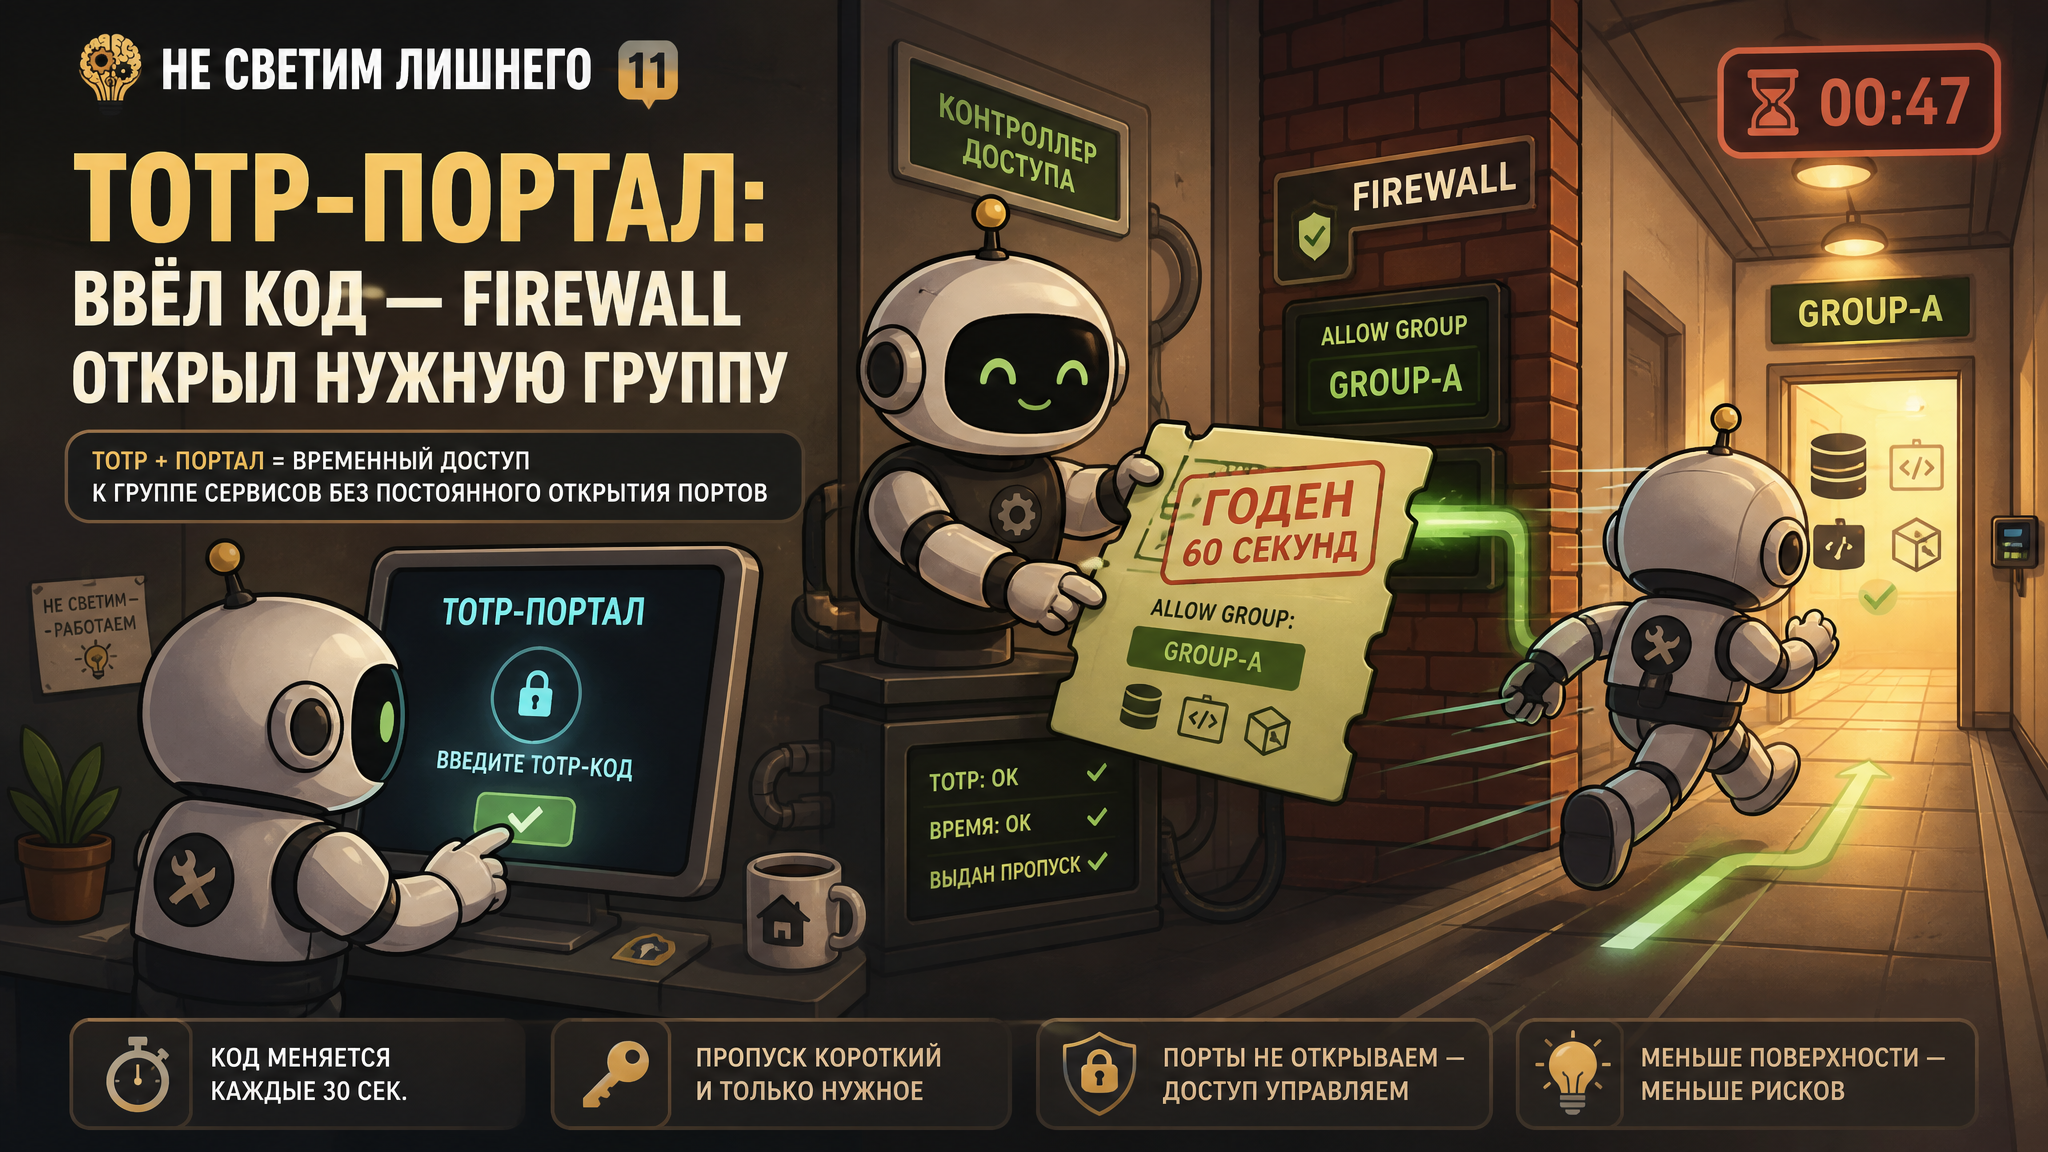
Мы хотим простую пользовательскую механику: открыть страницу, ввести шесть цифр и получить доступ к заранее определённой группе ресурсов. Никакого нового сетевого интерфейса, клиента и борьбы двух VPN за маршруты.

После успешной проверки портал определяет внешний IP соединения и через контроллер добавляет его в динамический address-list на MikroTik. Firewall уже знает, что список access-monitoring разрешает HTTPS к Zabbix и Grafana, а access-dev — SSH и HTTPS только в тестовый сегмент.

Что такое TOTP

TOTP — Time-Based One-Time Password. Приложение вроде Google Authenticator и сервер имеют общий уникальный секрет. Из него и текущего временного шага вычисляется короткий код. В RFC 6238 типовой шаг — 30 секунд.

Важная оговорка: код не становится магически одноразовым после первого ввода. Пока действует временное окно, тот же TOTP технически можно отправить повторно, если сервер специально не помечает использованный шаг. Поэтому одного кода мало — после входа создаём нормальную серверную сессию, ограничиваем попытки и при необходимости запрещаем повторное использование конкретного шага.

Что хранит административная часть

Для каждого токена нужны:

  • название и владелец;
  • TOTP-секрет в зашифрованном виде;
  • один или несколько профилей доступа;
  • максимальная продолжительность;
  • разрешённые часы или дата окончания;
  • число одновременных сессий;
  • состояние: активен, заблокирован, отозван;
  • журнал выдачи и входов.

Админка должна быть доступна только из внутренней сети или отдельного управленческого контура. Публичной остаётся лишь маленькая страница входа и активной сессии.

QR-код регистрации показывает сам долговременный секрет. Его нельзя хранить в заявке, пересылать в общий чат и потом показывать повторно любому администратору. Нормальная схема: секрет генерируется, QR показывается один раз, пользователь подтверждает первый код, дальше виден только статус токена.

Как управлять MikroTik

Портал не должен ходить к RouterOS прямо из каждого веб-запроса. Лучше отделить worker, который получает решение контроллера и обновляет firewall по API.

API доступен только с IP этого worker по management-сети. Учётная запись имеет минимально возможные права. Сам API ни в коем случае не публикуется в Интернет ради портала.

На MikroTik уже существуют проверенные правила и списки. Worker может только добавить или удалить адрес в разрешённой группе с обязательным timeout и комментарием с ID сессии.

Плюсы

  • ничего не устанавливается на пользовательскую машину;
  • не конфликтует с существующим VPN;
  • после открытия работают HTTP, SSH, RDP, WinBox и другие протоколы;
  • токен связан с ролью, а не с произвольным правилом;
  • доступ имеет срок и журнал;
  • на целевых ресурсах сохраняется собственная авторизация.

Минусы

  • firewall разрешает IP, а не браузер;
  • общий NAT расширяет фактический круг сетевого допуска;
  • смена внешнего адреса требует новой проверки;
  • портал и worker становятся элементами безопасности;
  • TOTP-секреты требуют серьёзного хранения;
  • RouterOS API имеет довольно крупные права и нуждается в изоляции.

Где можно больно ошибиться

Брать IP из любого X-Forwarded-For. Доверяем только своему reverse proxy и точно знаем, какой источник увидит пограничный firewall.

Не ограничить перебор. Шесть цифр — миллион вариантов. Нужны rate limit на IP и токен, задержки, временная блокировка и журнал.

Разрешить произвольный список. Пользователь выбирает только готовый профиль, который назначен его токену.

Дать API полный доступ и выставить его наружу. Компрометация портала тогда сразу становится компрометацией маршрутизатора.

Сделать доступ бессрочным. Даже постоянный сотрудник должен запускать временную сессию, а не один раз навсегда открыть домашний IP.

Чего пока не хватает

Фиксированный timeout не знает, работает пользователь или давно закрыл ноутбук. Можно выдать час, но он закончит через десять минут. В следующем выпуске добавим WebSocket heartbeat: доступ существует, только пока жива авторизованная вкладка.

Ранее в цикле

Документация и источники

#network

Цикл «Не светим лишнего». Выпуск 10.

Basic Auth хорош, пока пользователей трое. Потом нужен четвёртый, один увольняется, другой забывает пароль, руководитель просит TOTP, а безопасник — журнал по именам. В этот момент лучше перестать улучшать htpasswd.

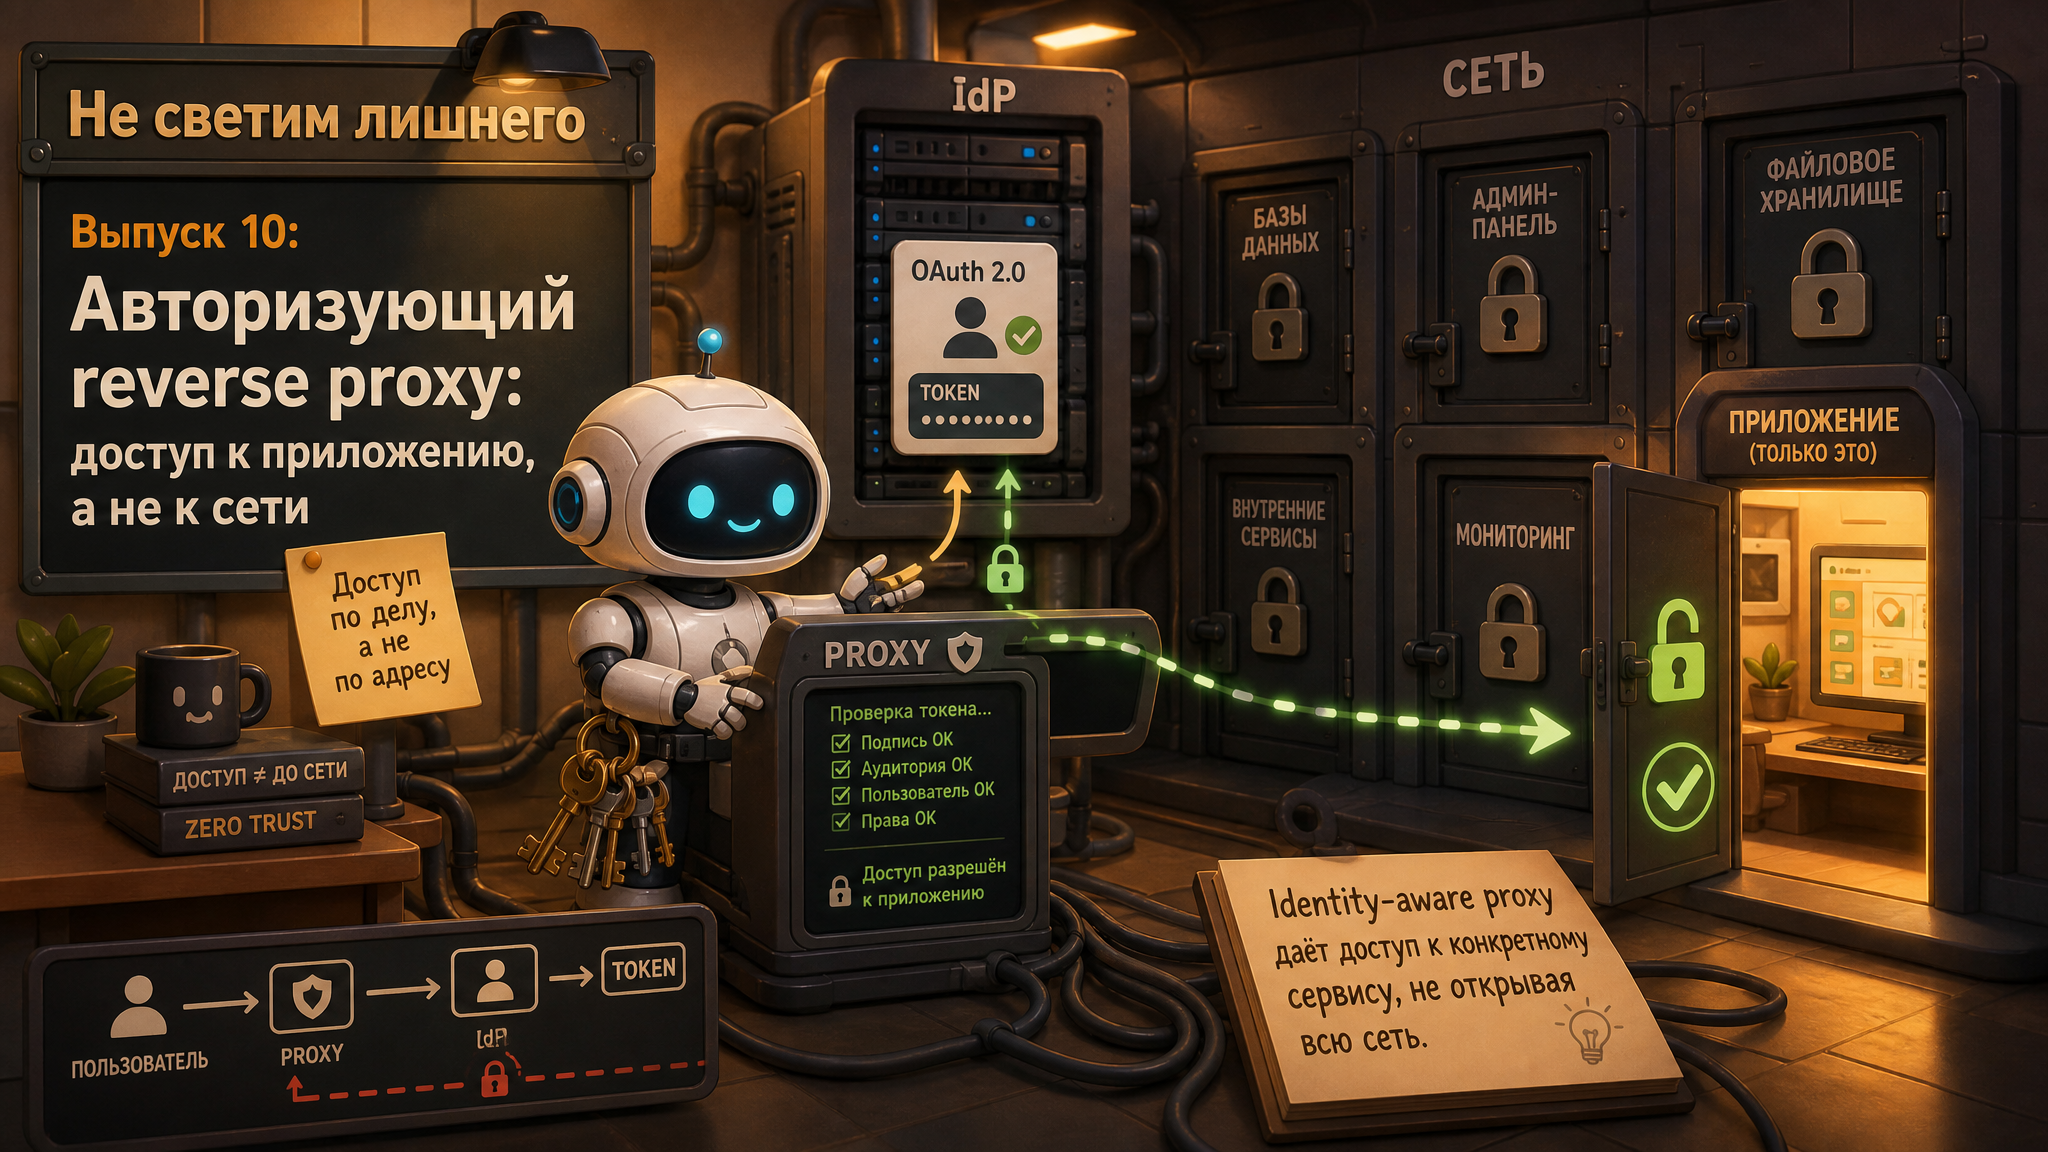
Авторизующий reverse proxy отправляет пользователя к нормальному провайдеру идентичности: Keycloak, Authentik, Authelia, Entra ID или другому OIDC-совместимому сервису. После входа прокси получает подтверждённую личность и решает, можно ли пропустить запрос к конкретному приложению.

Несколько новых слов

IdP, Identity Provider — система, которая аутентифицирует пользователя и сообщает другим сервисам, кто это.

OIDC, OpenID Connect — распространённый протокол входа поверх OAuth 2.0. Пользователь логинится у IdP, а приложение получает подписанные данные о его личности.

SSO — единый вход. Один раз прошли корпоративную авторизацию и используем несколько разрешённых приложений без отдельных паролей.

Identity-aware proxy — прокси, который принимает решение не только по IP, но и по пользователю, группе, MFA и другим признакам.

Как идёт запрос

Пользователь открывает внутренний hostname. Proxy видит, что действующей сессии нет, и отправляет его на страницу IdP. После пароля, passkey или TOTP пользователь возвращается с подтверждением. Proxy создаёт защищённую cookie и пропускает запрос к backend.

Внутреннее приложение может само ничего не знать про OIDC. Если ему нужна личность, proxy передаёт проверенные заголовки вроде X-User или X-Email.

Плюсы

  • одна корпоративная учётная запись;
  • MFA и passkey без переделки каждого приложения;
  • доступ по группам;
  • отзыв пользователя в одном месте;
  • приложение не получает сетевой доступ ко всей подсети;
  • понятный аудит входов;
  • удобно публиковать старые веб-интерфейсы.

Минусы

  • применимо в первую очередь к HTTP/HTTPS;
  • IdP и proxy становятся критичными компонентами;
  • не все приложения корректно работают за внешней авторизацией;
  • нужно управлять cookie, токенами, redirect URI и секретами клиентов;
  • ошибка общей политики может открыть сразу много приложений.

Где можно больно ошибиться

Backend доверяет заголовкам от клиента. Внешний пользователь сам присылает X-User: admin. Proxy обязан удалять такие заголовки и записывать собственные. Backend должен принимать трафик только от proxy.

Неправильно определён реальный IP. OAuth2 Proxy отдельно предупреждает: X-Forwarded-* надо принимать только от доверенных адресов reverse proxy. Иначе IP можно подделать строкой заголовка.

Слишком длинная cookie. Человек ушёл с общего компьютера, а сессия живёт неделю. Нужны разумный срок, logout и повторная сильная авторизация для опасных действий.

Нет защиты origin. Если backend доступен напрямую, вся identity-aware-логика обходится одним прямым запросом.

Proxy стал единственной защитой. На самом приложении всё равно оставляем минимальные роли и обновления. Для критичной админки можно совместить IdP с IP allow-list или клиентским сертификатом.

Что этот метод не решает

Он отлично защищает веб-приложения, но не открывает обычный SSH-клиент, RDP, WinBox или подключение к базе. Для произвольных протоколов понадобится bastion, VPN или динамический firewall.

Следующая наша схема как раз про динамический firewall: пользователь вводит TOTP на портале, а его текущий IP временно попадает в нужный access-list.

Ранее в цикле

Документация и источники

#network

Цикл «Не светим лишнего». Выпуск 9.

Есть внутренняя панель, написанная когда-то давно. Она умеет показывать графики, но не умеет пользователей. Разработчика рядом нет, а доступ двум сотрудникам нужен завтра.

Самый быстрый аккуратный вариант — поставить перед ней reverse proxy и включить HTTP Basic Authentication.

Что делает reverse proxy

Внешний клиент соединяется только с NGINX, Caddy, Traefik или другим прокси. Прокси завершает TLS, проверяет пользователя и отправляет разрешённый запрос внутреннему backend.

Внутренний сервис может жить на приватном адресе и вообще не иметь прямого DNAT. На одном внешнем IP удобно публиковать несколько hostname: monitoring.example.ru, dev.example.ru, reports.example.ru.

Basic Auth — стандартная HTTP-схема, в которой браузер отправляет имя пользователя и пароль в заголовке Authorization. Сами данные кодируются Base64, а не шифруются. Защиту канала даёт только HTTPS.

NGINX хранит проверочные значения в htpasswd-файле и может ограничивать отдельные location. Можно одновременно потребовать и разрешённый IP, и пароль либо разрешить один из этих вариантов — зависит от политики.

Плюсы

  • разворачивается быстро;
  • старое приложение не надо переделывать;
  • работает в обычном браузере;
  • backend остаётся во внутренней сети;
  • легко добавить TLS и журнал запросов;
  • можно закрывать разные сайты разными файлами пользователей.

Минусы

  • только HTTP/HTTPS;
  • неудобное управление большим числом пользователей;
  • нет красивого входа, MFA и восстановления учётки;
  • браузер может надолго сохранить пароль;
  • общие пароли быстро расходятся по чатам;
  • не все приложения хорошо живут за изменившимся hostname и префиксом пути.

Где можно больно ошибиться

Basic Auth без HTTPS. Base64 легко декодируется. В открытом HTTP пароль уходит практически как текст.

Один пароль на отдел. В журнале будет одна учётка, отозвать конкретного человека невозможно.

Backend доступен в обход. Если внутренний сервис всё ещё опубликован отдельным DNAT или слушает доступный внешний интерфейс, пользователь обойдёт proxy и Basic Auth.

Слабый TLS и забытые сертификаты. Прокси становится внешней точкой, поэтому обновления, сертификаты и безопасная конфигурация обязательны.

Доверие к X-Forwarded-For от всех. Прокси должен перезаписывать служебные заголовки. Backend — принимать их только от адреса прокси.

Отсутствие защиты от перебора. Basic Auth вызывает окно входа снова и снова. Rate limit, fail2ban или внешний firewall никто не отменял.

WebSocket и длинные запросы. Некоторые панели используют WebSocket, SSE или большие загрузки. Для них на прокси нужны отдельные timeout и Upgrade-заголовки.

Когда Basic Auth достаточно

Для двух-трёх технических пользователей, временной панели или read-only-отчёта — вполне. Особенно если дополнительно ограничить доступ по IP.

Но когда появляются десятки людей, увольнения, группы, MFA и аудит, htpasswd начинает изображать систему управления доступом. В следующем выпуске поставим перед proxy нормального провайдера идентичности.

Ранее в цикле

Документация и источники

#network