Живой «нет интернет»: постоянный мониторинг на Uptime Kuma
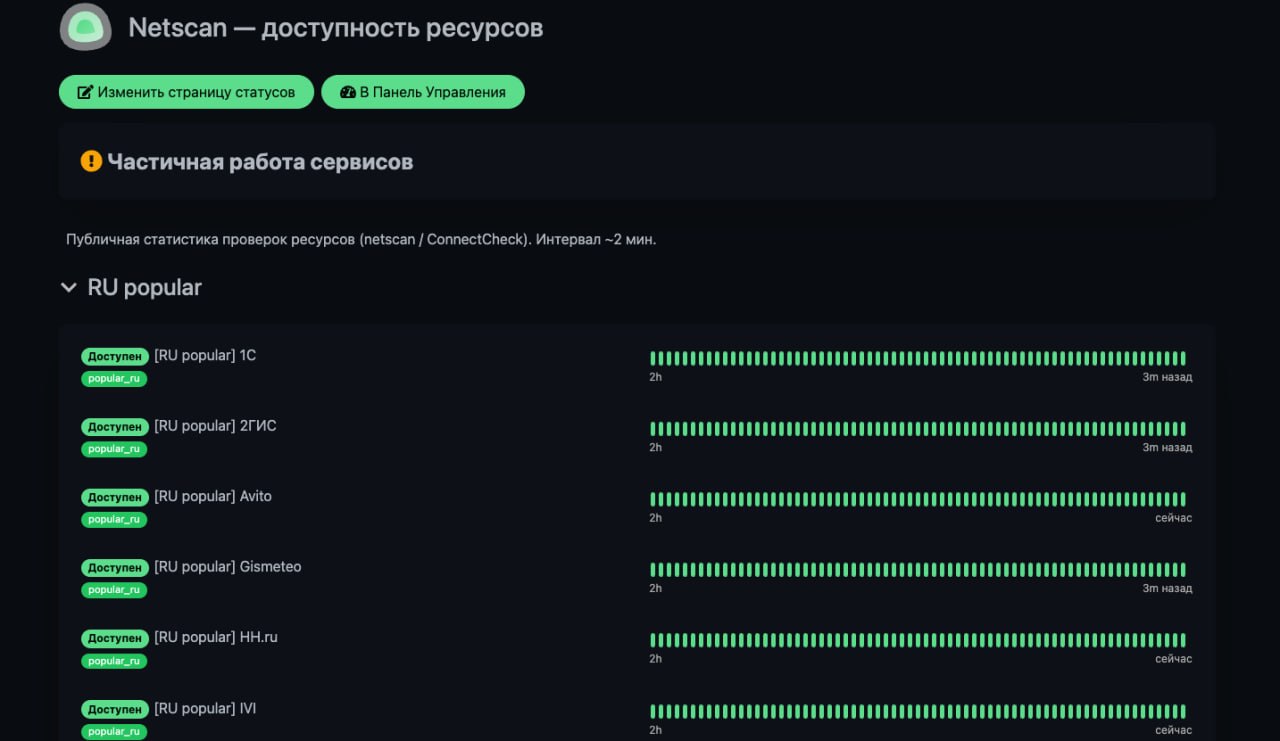
Вводные: пинги живые, а интернета как будто нет Две недели подряд ловил одинаковую картину: «интернета нет», а пинги бодрые. Браузер — унылый, мессенджеры — кое-как, игры и апдейты — рандом. Где-то пробивалось, где-то всё падало разом, будто кто-то водит шторку по списку доменов. Пропадали точечно — кептив-порталы, DoT, игровые логины, AI и облака. Типичный «фильтр-рондо». Пока включишь голову и гонишь connect-check руками — волна уже ушла, журнал пустой, виноватых нет.
Разовые прогоны хороши как «температура прямо сейчас», но бессильны против турбулентности. Мне нужна была история. Причём не в виде личных записей «кажется, около двух ночи падал OAuth у BNET и тормозил Steam CM», а нормальная хронология: кто упал, во сколько и сколько длилось.
Сел и перевёл connect-check в постоянный мониторинг на Uptime Kuma с публичной статус-страницей. Хотел, чтобы и самому видеть, и друзьям дать «смотри сюда» вместо десяти скриншотов.
Как делал: хроника работ 1) База: список ресурсов из resources.conf У меня уже был аккуратный список ресурсов для connect-check — группами: РФ-сервисы, банки, зарубежные платформы, игры (HTTPS и отдельные портовые пробы), инфраструктура (облака/IX), обновления систем и пакетных менеджеров, AI/LLM. Его и взял за основу. В терминах Kuma это — канарейки: маленькие, но громкие.
2) Площадка: Uptime Kuma в контейнере на зарубежном VPS Поднял Uptime Kuma в Docker: образ louislam/uptime-kuma:2. Спереди — Caddy, чтобы не думать про сертификаты: авто-TLS и редиректы. Корень сайта уехал на /status/netscan, чтобы не путать гостей и себя: открыл — сразу видишь общее состояние.
3) Импорт: Socket.IO API вместо REST У Kuma нет REST, у неё Socket.IO. Написал небольшой импортёр под свой resources.conf: пробегает по секциям, создаёт мониторы, присваивает теги по группам, задаёт параметры: – интервал 120 секунд (две минуты); – timeout 45 секунд; – HTTP и TCP по типу цели; – расширенные HTTP-коды успеха: не только 200, но и 400/429/500/503 в ряде точек — чтобы увидеть «жив ответ сервера» вместо ложной тревоги от временного 500; – ignoreTls там, где встречаются self-signed у банков/внутренних шлюзов; – expected_block/пауза для платформ, где блок-страницы и редиректы — это норма (YouTube, Meta, Telegram, Discord), чтобы не маячили фальшивые «зелёные» от их капч и заглушек.
Часть госсайтов принудительно гоню на HTTP: у ряда из них :443 формально «жив», но по сути мёртв, а реальный сервис отдают по 80-му.
4) Публичная статус-страница: /status/netscan Собрал страницу через addStatusPage и saveStatusPage. Имя: «Netscan — доступность ресурсов». Описание: «Публичная статистика проверок ресурсов (netscan / ConnectCheck). Интервал ~2 мин.» Поставил автообновление на 60 секунд, добавил подпись: «Источник списков: netscan resources.conf». Без логина, только статусы. Каждая секция из resources.conf стала группой на странице.
5) Алерты в Telegram Без этого мониторинг — просто музей графиков. Подключил Telegram-уведомления: падение — пилик, восстановление — тоже пилик. Волну фильтрации видно не только на дашборде: телефон сам шепчет «что-то с банками» или «просели AI-шлюзы».
6) Тонкая настройка под точку проверки Важно: все проверки идут С зарубежного VPS. Это картина «с этой точки». Для «как видит абонент в РФ» я оставил локальный connect-check — сравниваем две линии. Где расхождение — там и ответ: фильтрует дорога в/из страны или локальные сети.
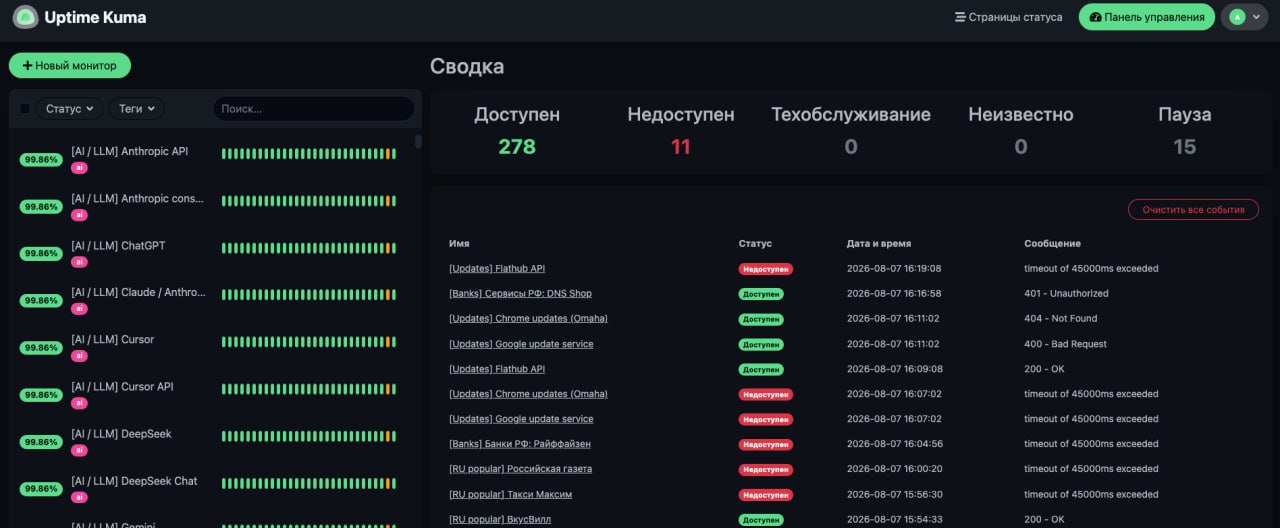
Что получилось: живая, публичная картина сети На странице /status/netscan сейчас 346 мониторов, разбитых на 11 групп. HTTP/HTTPS и TCP-пробы примерно в пропорции 228 к 118. Интервал ~2 минуты — это около 720 проверок в сутки на каждый монитор. Получается плотная, ритмичная лента событий. Если кто-то «присел» даже на 5–10 минут — видно.
Группы и состав 1) RU popular — 89 Государственные и популярные сервисы: Госуслуги, Президент/Правительство/Госдума, Яндекс/VK/OK/Mail/Дзен, медиа (Rutube, IVI, Okko, Кинопоиск, РБК, ТАСС, РИА, Известия, Ведомости), маркетплейсы (Ozon, Wildberries, Avito, HH), транспорт (РЖД, Туту, 2ГИС), операторы (МТС, МегаФон, Билайн, t2, Ростелеком), ритейл и прочее.
2) Banks — 17 Сбербанк, СберБанк Онлайн, Т-Банк×2, ВТБ, Альфа, Газпромбанк, РСХБ, Совкомбанк, МТС Банк, ПСБ, Райффайзен, Росбанк, плюс Bitrix24/Zoom (деловые сервисы в контексте бэкофиса), DNS Shop и ЦИАН — маркеры «жизни вокруг платежей».
3) Significant — 15 Большие публичные платформы: Google/Gmail/Play, App Store, Microsoft/Teams, YouTube, Instagram, Facebook, X, Discord, Telegram, WhatsApp, Wikipedia.
4) Video — 6 IVI, Okko, Rutube, VK Видео, Кинопоиск, Яндекс Видео.
5) Games HTTPS — 44 Battle.net/Blizzard/BNET login, Steam CDN (Dota/CS2), Epic×4, Riot, Ubisoft×2, Xbox, PSN×3, Nintendo, EA, Roblox×3, Minecraft, GOG, VK Play, War Thunder, Мир танков×2, Мир кораблей, Lesta, Tarkov, Genshin/HoYoverse×4, Twitch×3, Kick×3, loot.farm×2.
6) Games TCP — 66 Портовые пробы и узлы сессий: Battle.net HTTPS/account/OAuth/EU/US/version/download, BNET login :1119 EU/US/KR, CDN Akamai, Steam CM, Epic :443, GOG, Faceit, Xbox Live, PSN и т.д. Это те точки, где «логин не проходит» и «матчмейкинг крутится вечность».
7) Infra HTTPS — 12 Служебные веб-интерфейсы и точки проверки инфраструктуры.
8) Infra TCP — 26 Облака и CDN на портах: AWS S3 EU-North, Azure×4, Cloudflare×3, DigitalOcean×2, Hetzner×2, OVH×3, Selectel×6, GitHub×3. Хорошая лакмусовая бумажка для «облако целиком просело» против «упал только чей-то фронт».
9) Geo / IX — 10 DE-CIX, AMS-IX, LINX, DATAIX, Eurasia Peering, HE Looking Glass, Selectel speed. Тут и латентность видна, и «зевки» обменных узлов.
10) Updates — 35 Обновления всего, чем живёт домашняя инфраструктура: Debian/Ubuntu/Arch/Fedora/Kali/Alma/Rocky/openSUSE, Alpine, Docker Hub×2, PyPI/npm/crates/Maven/NuGet, Homebrew, Flathub, Snapcraft, Windows Update/Winget/VS Code, Chrome Omaha, Apple mesu/configuration/gdmf, Mozilla, Microsoft download CDN, Yandex mirror×2. Когда это краснеет — админ страдает.
11) AI / LLM — 26 OpenAI/ChatGPT/API, Anthropic×3, Cursor×2, Gemini×3, Grok/xAI×3, DeepSeek×2, Mistral×2, Hugging Face, Groq, Together, Perplexity, Poe, Copilot, GigaChat, YandexGPT/Алиса. Если тут краснеет пачкой — это не «случайно лёг таб», это волна по AI.
Поведение и «волны» – Интервал 2 минуты даёт ~720 точек в сутки на каждый монитор. Любая точечная фильтрация больше пары минут засвечивается на дашборде — не через день, а почти сразу. – Вчерашняя волна 28.07 по банкам РФ в такой конфигурации выглядела бы как красные карточки в группе Banks в реальном времени. Алерт в Telegram, потом спокойная зелень, а в истории — чёткий коридор времени для разбирательства. – В группах Games TCP хорошо видно, когда «ломит логин»: краснеют именно :1119 у BNET или CM-узлы Steam, при этом витрина магазинов по HTTPS — зелёная. Можно сразу говорить пользователю: «играть — да, логиниться — нет». – В Infra TCP и Geo/IX ловятся скачки латентности и мимолётные недоступности на уровне облаков/обменников. Если одновременно краснеют Cloudflare и пара IX — это уже сетевое, а не «у сервиса рука дрогнула». – В Updates — отдельная боль. Когда PyPI/npm и Docker Hub дружно уходят в «серое», любые CI/CD и домашние апдейты превращаются в квест.
Технические детали, чтобы всё честно – Контейнер: louislam/uptime-kuma:2. – Перед ним Caddy с авто-TLS. Корень сайта редиректит на /status/netscan. – Импорт мониторов через Socket.IO API: создаю monitors с тегами по секциям, интервал 120с, timeout 45с, тип HTTP/TCP по ресурсу. – Публичная страница собрана addStatusPage + saveStatusPage: группы совпадают с секциями resources.conf. – Страница автообновляется каждые 60 секунд. Внизу подпись: «Источник списков: netscan resources.conf». – Подстройка под реальные условия: – гос-ресурсы — чаще HTTP; :443 иногда «ждёт лучшей жизни»; – банки — ignoreTls для мест с самоподписанными цепочками; – расширенные acceptedstatuscodes (400/429/500/503) там, где сам факт ответа важнее «строгой 200»; – для YouTube/Meta/Telegram/Discord — пауза и expectedblock, чтобы не считать заглушки «здоровьем». – Проверки идут с зарубежного VPS — это важно для интерпретации. Для российского абонента картинка может отличаться: держу локальный connect-check как второй взгляд с земли. – Алерты — в Telegram. Этого хватает для «вскипает чайник — посмотрел — понятно».
Живые цифры – 346 мониторов в 11 группах: примерно 228 HTTP и 118 TCP. – Интервал ~2 минуты — около 720 проверок/сутки на каждый монитор. – Суммарно это сотни тысяч проверок в день. Хватает, чтобы увидеть и «пульс» сервисов, и редкие, но показательные «провалы». – Публикация статуса: «Netscan — доступность ресурсов» по пути /status/netscan. Описание на странице: «Публичная статистика проверок ресурсов (netscan / ConnectCheck). Интервал ~2 мин.» Автообновление — 60 секунд.
Что это даёт в быту – Когда «интернета нет» при живых пингах — захожу на /status/netscan и сразу вижу, кого именно «подстригли»: кептивы, банки, игровые логины, AI, облака, репозитории обновлений. – Можно аргументированно разговаривать с поддержкой: «в 13:42–13:58 пачкой шли ошибки на PSN и Xbox Live, при этом Cloudflare и IX — зелёные, проблема, похоже, на маршруте до конкретной AS». – Для своих — одна ссылка вместо поэмы в мессенджере. Для себя — история для ретроспективы и автоматические алерты, а не «кажется, это было позавчера». – Для лабы — набор «канареек» по всем категориям. Если зеленеют не там, где надо, или внезапно краснеет банк/облако/AI — собираюсь быстрее.
Грабли и почему именно так – Разовый connect-check — отличная диагностика «прямо сейчас», но он не ловит всплески и не даёт истории. А фильтрация сегодня — это волны. Они приходят и уходят быстрее, чем ты успеваешь сделать первый скриншот. – Почему Uptime Kuma? Простая, самодостаточная, контейнером завернул, Socket.IO — и поехали. Плюс приятная публичная страница, которую не стыдно показывать. – Зачем расширенные коды и ignoreTls? Чтобы не путать «сервер отвечает, но ругается» с «канал физически закрыт». Для сетевой картины важнее факт досягаемости, чем идеальный HTTP-ритуал. – Почему 2 минуты? Компромисс: волна видна в течение минут, а не дней, и при этом не жрёт VPS до костей. Меньше интервал — шумнее и дороже, больше — зияют дыры.
Дальше по плану – Вторую точку мониторинга хочу запустить из домашней сети: сравнивать «зарубежный взгляд» и «домашний абонент». Либо второй зарубежный VPS — для географии. – Добавить несколько UDP-мониторов для игр (где это адекватно), но аккуратно: Kuma тут не всесилен. – Свести «красные всплески» к недельным сводкам: какие группы страдали чаще, в какие часы. Это полезно не только для цифровой гигиены, но и для планирования обновлений.
Выводы – Разовый прогон — фотоснимок. Постоянный мониторинг — хроника с таймкодами и будильником. – При «интернета нет» и живых пингах публичная /status/netscan даёт конкретику: фильтруются ли кептивы, падают ли банки, захлебнулся ли OAuth у игр, дергают ли AI/облака или задушили репозитории апдейтов. – Волны фильтрации становятся видны сразу — на шкале минут, а не «вчера где-то в районе вечера». – Алерты в Telegram снимают главную боль: не надо сидеть и таращиться в зелёные кирпичики — телефон сам позовёт, когда надо вмешаться.
❓ Вопрос
Какие канарейки добавить в netscan, чтобы ловить «нет интернета при живых пингах» точнее? Отдельные проверки DoT/DoH/QUIC, больше игровых узлов, UDP-пробы, больше зеркал обновлений — или, наоборот, реже, но точнее? И из какой точки мира/сети вы бы хотели вторую (третью) перспективу?